TL;DR
Ich habe 30 Tage Logs aus dem Agent-Setup gezogen, mit dem ich arbeite: 127.610 Tool-Aufrufe und 1.238 abgeschlossene Agent-Läufe. Drei Dinge bestimmten, was ein Monitoring-Dashboard zeigen sollte. 59 % aller Tool-Fehler waren meine eigenen Schutzregeln, die etwas verweigerten, nicht etwas, das kaputtging; Fehler brauchen also zwei Zähler. Ein Zeitlimit für alle Agenten ist falsch: 21 % meiner Test-first-Coder liefen länger als 12 Minuten, bei den Code-Explorern 0 %. Und 1 von 5 Agent-Starts wurde abgelehnt, bevor er begann, was kein Diagramm “Läufe pro Tag” zeigt.
Ich bin Denys, Full-Stack- und KI-Entwickler. Ich arbeite mit einer führenden Coding-Sitzung, die Aufgaben an spezialisierte Agenten abgibt: Explorer, einen Planer, Test-first-Coder, Security- und Code-Reviewer. In Multi-agent orchestration: was in 3.315 Läufen kaputtging habe ich die Fehler gezählt. Hier geht es beim AI Agent Monitoring um eine andere Frage: Was gehört ins Dashboard?
Daten. Sitzungs-Logs und das Start-Ledger meines eigenen Setups, 24. September bis 23. Oktober 2026. Jede Zahl unten wird aus ihnen mit einem Skript berechnet; Kunden- und Projektnamen stecken nicht in den Daten, die ich verwendet habe. Es ist die Arbeitslast einer Person, kein Benchmark.
Was sollte ein AI Agent Monitoring Dashboard zeigen?
Anbieter-Leitfäden, etwa die Agent-Observability-Dokumentation von Grafana, drehen sich um Latenz, Tokens, Kosten und Fehler. Meine Logs sagen: Diese vier sind nötig, aber nicht genug. Fünf Panels:
- Starts: begonnen, abgelehnt, abgeschlossen, fehlgeschlagen, pro Tag.
- Fehler getrennt nach “von einer Regel abgelehnt” und “kaputtgegangen”, pro Tool.
- Dauer und Tool-Aufrufe pro Agententyp, als Median und 90. Perzentil, mit einem Limit je Typ.
- Tokens pro Lauf, also die Kosten.
- Was gerade läuft, mit der verstrichenen Zeit jedes Laufs gegenüber dem Normalbereich seines Typs.
Der Rest dieses Artikels sind die Zahlen hinter jedem davon.
Wie viele Agent-Starts beginnen nie?
| Starts, 30 Tage | Anzahl |
|---|---|
| Startversuche | 1.775 |
| Vor dem Start abgelehnt | 352 (19,8 %) |
| Geschäftigster Tag | 258 Starts |
| Median-Tag | 40 Starts |
Mein Setup prüft jeden Start: ob der Auftrag die Dateien nennt, die der Agent ändern darf, ob ein anderer laufender Agent diese Dateien schon hält, welches Modell ein riskanter Schritt braucht. Einer von fünf Starts bestand nicht. Ein Diagramm der Läufe zählt nur die Starts, die begonnen haben, und verbirgt damit alle diese.
Warum brauchen Tool-Fehler zwei Zähler?
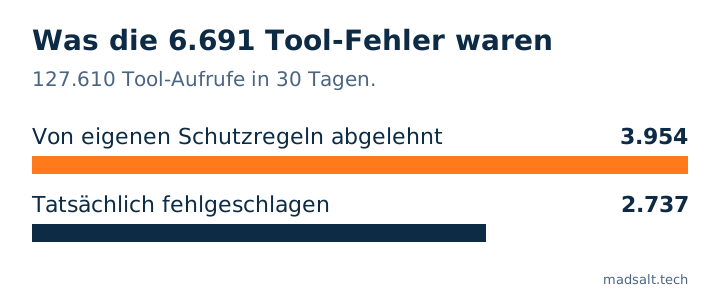
Von 127.610 Tool-Aufrufen kamen 6.691 als Fehler zurück: 52 pro 1.000 Aufrufe. Dann habe ich sie danach aufgeteilt, was der Fehler sagte:
| Tool | Aufrufe | Fehler | Davon von einer Schutzregel abgelehnt |
|---|---|---|---|
| Shell | 50.960 | 4.985 | 2.970 |
| Datei bearbeiten | 28.244 | 743 | 602 |
| Datei lesen | 26.348 | 145 | 1 |
| Datei schreiben | 8.238 | 208 | 195 |
| Agent starten | 1.719 | 287 | 132 |
| Websuche | 2.527 | 57 | 0 |
3.954 der 6.691 Fehler, 59 %, waren meine eigenen Regeln, die Nein sagten: ein Befehl, der eine Prüfung übersprungen hätte, eine Änderung vor einer vorgeschriebenen Abfrage, ein Schreibzugriff auf eine Datei, die einem anderen Agenten gehört. Steigt diese Zahl, machen die Regeln ihre Arbeit oder ein Agent kämpft gegen sie. Die übrigen 2.737 sind echte Fehlschläge: ein Test, der fehlschlug, ein Befehl, der abstürzte, eine Seite, die nicht laden wollte. In einem Diagramm vermischen sich beide: Ein Tag mit vielen Ablehnungen sieht wie ein schlechter Tag aus, obwohl nichts kaputtging.
Passt ein Zeitlimit für jeden Agenten?
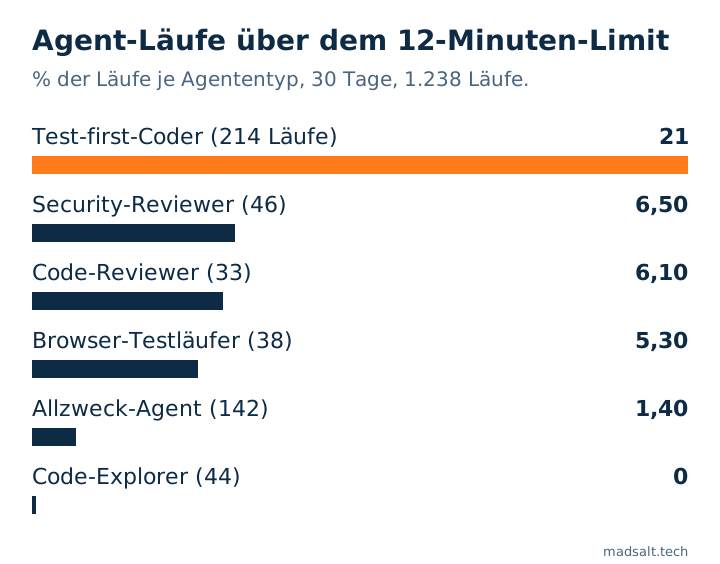
Nein. Ich stoppe einen Subagenten nach 12 Minuten oder 80 Tool-Aufrufen, und die Logs zeigen, wie verschieden die Typen sind:
| Agententyp | Läufe | Median (Min.) | 90. Perzentil | Über 12 Minuten | Über 80 Tool-Aufrufe |
|---|---|---|---|---|---|
| Test-first-Coder | 214 | 6,8 | 17,1 | 45 (21 %) | 66 (31 %) |
| Security-Reviewer | 46 | 5,0 | 10,9 | 3 (6,5 %) | 2 |
| Code-Reviewer | 33 | 4,8 | 10,2 | 2 (6,1 %) | 3 |
| Browser-Testläufer | 38 | 4,3 | 10,5 | 2 (5,3 %) | 2 |
| Allzweck-Agent | 142 | 3,1 | 6,5 | 2 (1,4 %) | 8 |
| Architekt | 72 | 5,2 | 8,5 | 0 | 4 |
| Code-Explorer | 44 | 1,9 | 3,4 | 0 | 0 |
| Alle 1.238 Läufe | 4,0 | 11,8 | 72 (5,8 %) | 98 (7,9 %) |
Ein Coding-Agent, der einen Test schreibt, ausführt, Code korrigiert und erneut ausführt, braucht mehr Zeit und mehr Aufrufe als einer, der Dateien liest. Mit einem einzigen Limit wird der Coder in einem Fünftel der Fälle abgeschnitten, und der Explorer könnte das Sechsfache seiner üblichen Dauer hängen, bevor es jemand merkt. Das Panel, das ich bauen würde, zeigt das 90. Perzentil jedes Typs und markiert einen laufenden Agenten, der sein eigenes überschreitet, keine globale Zahl. Bevor ich einen stoppe, lese ich seine letzte protokollierte Aktion: Ein Agent, der seit 15 Minuten einen langen Testlauf fährt, arbeitet; einer, dessen letzte Aktion 10 Minuten zurückliegt, steckt fest.
Was kostet ein Lauf in Tokens?
Ein Median-Lauf verbrauchte 125.828 Tokens und das 90. Perzentil 211.884, gezählt wurde alles, was der Agent las und schrieb. Explorer lagen niedriger (Median 86.389), Allzweck-Agenten höher (141.495). Preise ändern sich zu oft, um sie hier zu drucken; das Dashboard sollte also Tokens pro Lauf und Modell speichern und die aktuelle Preisliste erst beim Zeichnen der Kosten anwenden. Was dieselbe Arbeit auf verschiedenen Modellen kostet, steht in Was kostet ein KI-Agent?.
Von den 1.775 Starts gingen 883 an das mittelgroße Modell, 827 an das größte, 33 an das neueste Spitzenmodell und 32 an andere; 54 % der Agenten durften Dateien ändern.
Waren die abgeschlossenen Läufe tatsächlich erfolgreich?
Von 1.238 Läufen, die sich zurückmeldeten, wurden 1.172 abgeschlossen, 64 schlugen fehl und 2 wurden gestoppt. Diese 94,7 % sagen, dass der Agent fertig wurde, nicht dass seine Arbeit richtig war. In meinem Setup geht jede Codeänderung weiterhin durch einen Security-Reviewer und einen Code-Reviewer, die sie zurückschicken können; nichts davon ist am Status eines Laufs sichtbar. Ein Dashboard kann zeigen, dass ein Lauf endete. Ob das Ergebnis stimmt, braucht einen zweiten Agenten, einen Test oder einen Menschen.
Welche Tools gibt es dafür?
Für eine Produktions-App, in der Agenten mit Kunden sprechen, decken gehostete Tracing-Tools wie Langfuse, LangSmith, Datadog oder die Agent-Ansichten von Grafana Latenz, Tokens und Traces ab, und manche können Ausgaben bewerten. Für mehrere Coding-Agenten auf einem Rechner gibt es Open-Source-Dashboards, die die Hook-Ereignisse der Agenten in eine lokale Datenbank lesen. Meine eigenen Zahlen stammen aus den Logs, die das Setup ohnehin schreibt: ein Start-Ledger, eine Zeile pro Start, und die Sitzungsprotokolle. Für einen einzelnen Entwickler reichte das, und ein Skript über diese zwei Dateien erzeugte jede Tabelle hier.
Wie eine vollständige Orchestrierungsansicht mit Agentenkarte, Workflow-Builder und Kostendiagrammen aussehen kann, zeigt mein Prototyp Dashboard für Multi-Agent-Orchestrierung.
Grenzen. Ein Entwickler, ein Setup, 30 Tage. “Von einer Schutzregel abgelehnt” wird am Fehlertext erkannt, einige Fehler können also auf der falschen Seite gezählt sein. Dauer und Tool-Zahlen stammen von Agenten, die im Hintergrund liefen und sich zurückmeldeten; Agenten im Vordergrund fehlen in der Dauertabelle. Fehlschläge ließen sich nicht verlässlich Agententypen zuordnen und werden daher nur als Summe genannt.
Agenten im Produktivbetrieb?
Gern tausche ich mich darüber aus, was Sie messen sollten. Ohne Verkaufsgespräch.
Kontakt aufnehmen