En resumen
Extraje 30 días de logs de la configuración de agentes con la que trabajo: 127.610 llamadas a herramientas y 1.238 ejecuciones de agentes terminadas. Tres cosas decidieron qué debería mostrar un dashboard de monitoreo. El 59 % de todos los errores de herramientas eran mis propias reglas de protección rechazando algo, no algo que se rompiera, así que los errores necesitan dos contadores. Un único límite de tiempo para todos los agentes es un error: el 21 % de mis agentes de código con test primero superó los 12 minutos, frente al 0 % de los exploradores de código. Y 1 de cada 5 lanzamientos de agentes fue rechazado antes de empezar, algo que ningún gráfico de “ejecuciones por día” muestra.
Soy Denys, ingeniero full-stack y de IA. Construyo con una sesión principal de código que reparte el trabajo entre agentes especializados: exploradores, un planificador, programadores con test primero, revisores de seguridad y de código. En qué falló en 3.315 ejecuciones de agentes conté los fallos. Este texto hace otra pregunta: ¿qué debe ir en el dashboard?
Datos. Logs de sesión y registro de lanzamientos de mi propia configuración, del 24 de septiembre al 23 de octubre de 2026. Cada número de abajo sale de ellos con un único script; los nombres de clientes y proyectos no están en los datos que usé. Es la carga de trabajo de una persona, no un benchmark.
¿Qué debe mostrar un dashboard de monitoreo de agentes de IA?
Las guías de los proveedores, como los documentos de observabilidad de agentes de Grafana, giran en torno a latencia, tokens, coste y errores. Mis logs dicen que esos cuatro son necesarios y no bastan. Cinco paneles:
- Lanzamientos: iniciados, rechazados, terminados, fallidos, por día.
- Errores divididos en “rechazados por una regla” y “se rompió”, por herramienta.
- Duración y llamadas a herramientas por tipo de agente, como mediana y percentil 90, con un límite por tipo.
- Tokens por ejecución, que es el coste.
- Qué se está ejecutando ahora, con el tiempo transcurrido de cada ejecución frente al rango normal de su tipo.
El resto de este texto son los números detrás de cada uno.
¿Cuántos lanzamientos de agentes nunca empiezan?
| Lanzamientos, 30 días | Cantidad |
|---|---|
| Intentos de lanzamiento | 1.775 |
| Rechazados antes de empezar | 352 (19,8 %) |
| Día más intenso | 258 lanzamientos |
| Día mediano | 40 lanzamientos |
Mi configuración revisa cada lanzamiento: si el encargo nombra los archivos que el agente puede cambiar, si otro agente en ejecución ya tiene esos archivos, qué modelo necesita un paso de riesgo. Uno de cada cinco lanzamientos no pasó. Un gráfico de ejecuciones cuenta solo los lanzamientos que empezaron, así que los oculta todos.
¿Por qué los errores de herramientas necesitan dos contadores?
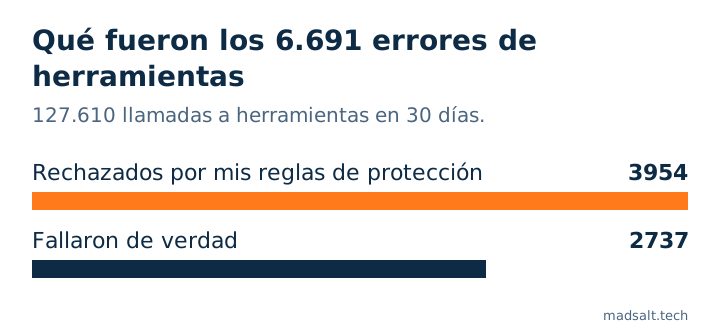
De 127.610 llamadas a herramientas, 6.691 volvieron como errores: 52 por cada 1000 llamadas. Luego los dividí según lo que decía el error:
| Herramienta | Llamadas | Errores | De ellos, rechazados por una regla de protección |
|---|---|---|---|
| Terminal | 50.960 | 4.985 | 2.970 |
| Editar archivo | 28.244 | 743 | 602 |
| Leer archivo | 26.348 | 145 | 1 |
| Escribir archivo | 8.238 | 208 | 195 |
| Lanzar agente | 1.719 | 287 | 132 |
| Búsqueda web | 2.527 | 57 | 0 |
3.954 de los 6.691 errores, el 59 %, fueron mis propias reglas diciendo que no: un comando que se saltaría una comprobación, una edición antes de una consulta obligatoria, una escritura en un archivo que pertenece a otro agente. Que ese número suba significa que las reglas cumplen su función o que un agente pelea contra ellas. Los otros 2.737 son fallos reales: un test que falló, un comando que se colgó, una página que no cargó. En un solo gráfico los dos se mezclan: un día de muchos rechazos parece un mal día, cuando no se rompió nada.
¿Sirve un único límite de tiempo para todos los agentes?
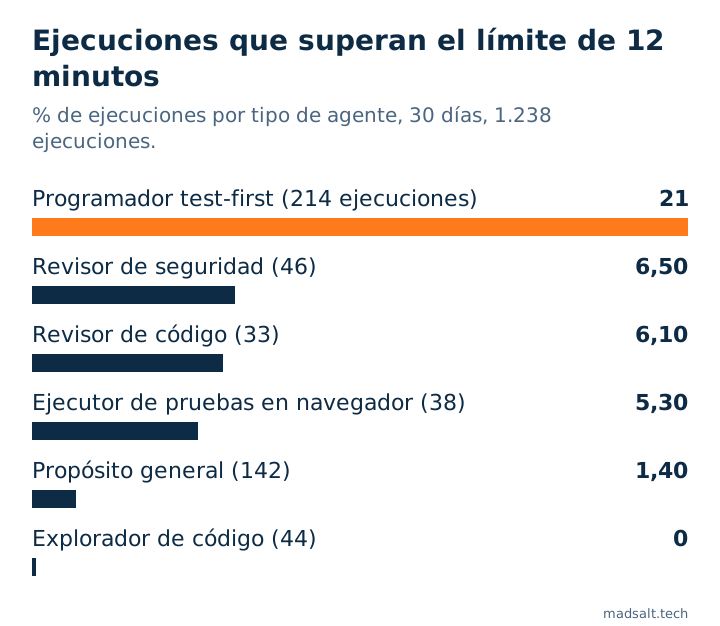
No. Detengo a un subagente tras 12 minutos o 80 llamadas a herramientas, y los logs muestran lo distintos que son los tipos:
| Tipo de agente | Ejecuciones | Mediana (min) | Percentil 90 | Más de 12 minutos | Más de 80 llamadas |
|---|---|---|---|---|---|
| Programador test-first | 214 | 6,8 | 17,1 | 45 (21 %) | 66 (31 %) |
| Revisor de seguridad | 46 | 5,0 | 10,9 | 3 (6,5 %) | 2 |
| Revisor de código | 33 | 4,8 | 10,2 | 2 (6,1 %) | 3 |
| Ejecutor de pruebas en navegador | 38 | 4,3 | 10,5 | 2 (5,3 %) | 2 |
| Propósito general | 142 | 3,1 | 6,5 | 2 (1,4 %) | 8 |
| Arquitecto | 72 | 5,2 | 8,5 | 0 | 4 |
| Explorador de código | 44 | 1,9 | 3,4 | 0 | 0 |
| Las 1.238 ejecuciones | 4,0 | 11,8 | 72 (5,8 %) | 98 (7,9 %) |
Un agente de código que escribe un test, lo ejecuta, corrige código y vuelve a ejecutarlo necesita más tiempo y más llamadas que uno que lee archivos. Con un único límite, al programador se le corta una quinta parte de las veces y el explorador podría colgarse durante seis veces su duración normal antes de que nadie lo note. El panel que construiría muestra el percentil 90 de cada tipo y marca a un agente en ejecución que supera el suyo, no un número global. Antes de detener a uno, leo su última acción registrada: un agente a 15 minutos de una ejecución larga de tests está trabajando; uno cuya última acción fue hace 10 minutos está atascado.
¿Cuánto cuesta una ejecución en tokens?
Una ejecución mediana usó 125.828 tokens y el percentil 90, 211.884, contando todo lo que el agente leyó y escribió. Los exploradores quedaron más abajo (mediana de 86.389), los agentes de propósito general más arriba (141.495). Los precios cambian demasiado a menudo para imprimirlos, así que el dashboard debe guardar los tokens por ejecución y modelo, y aplicar la lista de precios vigente al dibujar el coste. Lo que cuesta el mismo trabajo en distintos modelos está en cuánto cuesta un agente de IA.
De los 1.775 lanzamientos, 883 fueron al modelo de tamaño medio, 827 al más grande, 33 al modelo top más reciente y 32 a otros; el 54 % de los agentes tenía permiso para cambiar archivos.
¿Las ejecuciones que terminaron tuvieron éxito de verdad?
De 1.238 ejecuciones que informaron, 1.172 se completaron, 64 fallaron y 2 se detuvieron. Ese 94,7 % dice que el agente terminó, no que su trabajo sea correcto. En mi configuración cada cambio de código sigue pasando por un revisor de seguridad y uno de código, que pueden devolverlo; nada de eso se ve en el estado de una ejecución. Un dashboard puede mostrar que una ejecución terminó. Saber si el resultado es correcto requiere un segundo agente, un test o una persona.
¿Qué herramientas existen para esto?
Para una app en producción con agentes que hablan con clientes, las herramientas de trazado alojadas como Langfuse, LangSmith, Datadog o las vistas de agentes de Grafana cubren latencia, tokens y trazas, y algunas pueden puntuar las salidas. Para varios agentes de código en una máquina, hay dashboards de código abierto que leen los eventos de hooks de los agentes en una base de datos local. Mis propios números salen de los logs que la configuración escribe de todos modos: un registro de lanzamientos, una línea por lanzamiento, y las transcripciones de sesión. Para un solo desarrollador bastó con eso, y un script sobre esos dos archivos produjo todas las tablas de aquí.
Cómo puede verse una vista completa de orquestación, con un mapa de agentes, un constructor de flujos y gráficos de coste, está en mi prototipo de dashboard de orquestación multiagente.
Límites. Un desarrollador, una configuración, 30 días. “Rechazado por una regla de protección” se detecta por el texto del error, así que algunos errores pueden contarse en el lado equivocado. La duración y las llamadas a herramientas vienen de agentes que corrieron en segundo plano e informaron; los agentes en primer plano no están en la tabla de duración. Los fallos no pudieron atribuirse de forma fiable a tipos de agente, así que se informan solo como total.