TL;DR
Jag hämtade 30 dagars loggar från den agentuppsättning jag bygger med: 127 610 verktygsanrop och 1 238 avslutade agentkörningar. Tre saker avgjorde vad en övervakningsdashboard bör visa. 59 % av alla verktygsfel var mina egna skyddsregler som nekade något, inte något som gick sönder; fel behöver alltså två räknare. En tidsgräns för alla agenter är fel: 21 % av mina test-first-kodagenter körde över 12 minuter, mot 0 % av kodutforskarna. Och 1 av 5 agentstarter nekades innan den började, vilket inget diagram över “körningar per dag” visar.
Jag heter Denys och är full-stack- och AI-utvecklare. Jag bygger med en ledande kodsession som delar ut arbete till specialiserade agenter: utforskare, en planerare, test-first-kodare, säkerhets- och kodgranskare. I Multi-agent orchestration: vad gick sönder i 3 315 körningar räknade jag felen. Här är frågan en annan, sett som AI agent monitoring: vad hör hemma på dashboarden?
Data. Sessionsloggar och startjournalen från min egen uppsättning, 24 september till 23 oktober 2026. Varje siffra nedan är beräknad ur dem med ett enda skript; kund- och projektnamn finns inte i den data jag använde. Det är en persons arbetsbörda, inte ett benchmark.
Vad bör en AI agent monitoring dashboard visa?
Leverantörsguider, som Grafanas dokumentation om agent-observerbarhet, kretsar kring latens, tokens, kostnad och fel. Mina loggar säger att de fyra är nödvändiga men inte tillräckliga. Fem paneler:
- Starter: påbörjade, nekade, avslutade, misslyckade, per dag.
- Fel delade i “nekade av en regel” och “gick sönder”, per verktyg.
- Varaktighet och verktygsanrop per agenttyp, som median och 90:e percentil, med en gräns per typ.
- Tokens per körning, alltså kostnaden.
- Vad som körs nu, med varje körnings förflutna tid mot det normala intervallet för dess typ.
Resten av artikeln är siffrorna bakom var och en.
Hur många agentstarter börjar aldrig?
| Starter, 30 dagar | Antal |
|---|---|
| Startförsök | 1 775 |
| Nekade före start | 352 (19,8 %) |
| Mest intensiva dag | 258 starter |
| Mediandag | 40 starter |
Min uppsättning kontrollerar varje start: om uppdraget nämner de filer agenten får ändra, om en annan körande agent redan håller dem, vilken modell ett riskabelt steg kräver. En start av fem klarade det inte. Ett diagram över körningar räknar bara de starter som började och döljer därmed alla dessa.
Varför behöver verktygsfel två räknare?
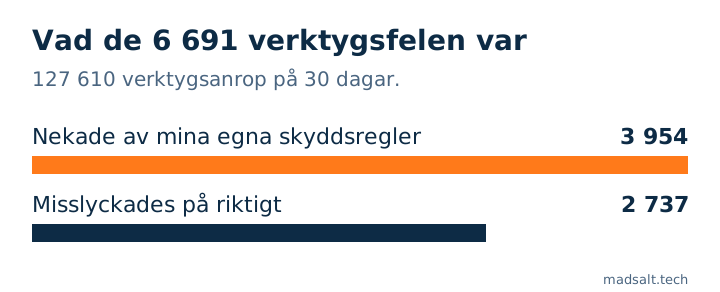
Av 127 610 verktygsanrop kom 6 691 tillbaka som fel: 52 per 1 000 anrop. Sedan delade jag dem efter vad felet sade:
| Verktyg | Anrop | Fel | Varav nekade av en skyddsregel |
|---|---|---|---|
| Shell | 50 960 | 4 985 | 2 970 |
| Redigera fil | 28 244 | 743 | 602 |
| Läs fil | 26 348 | 145 | 1 |
| Skriv fil | 8 238 | 208 | 195 |
| Starta agent | 1 719 | 287 | 132 |
| Webbsökning | 2 527 | 57 | 0 |
3 954 av de 6 691 felen, 59 %, var mina egna regler som sa nej: ett kommando som hade hoppat över en kontroll, en redigering före ett obligatoriskt uppslag, en skrivning till en fil som en annan agent äger. Stiger siffran gör reglerna sitt jobb, eller så kämpar en agent mot dem. De övriga 2 737 är riktiga fel: ett test som misslyckades, ett kommando som kraschade, en sida som inte ville laddas. I ett enda diagram blandas de två: en dag med många nekanden ser ut som en dålig dag, fast inget gick sönder.
Passar en tidsgräns för varje agent?
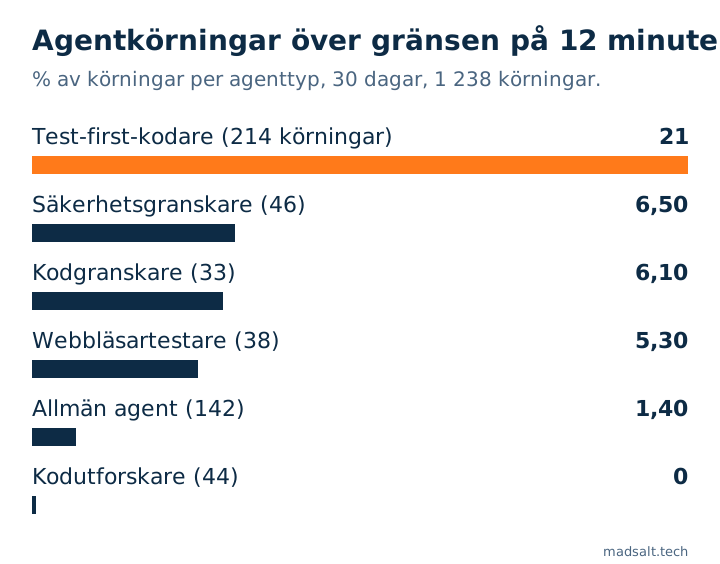
Nej. Jag stoppar en subagent efter 12 minuter eller 80 verktygsanrop, och loggarna visar hur olika typerna är:
| Agenttyp | Körningar | Median (min) | 90:e percentilen | Över 12 minuter | Över 80 verktygsanrop |
|---|---|---|---|---|---|
| Test-first-kodare | 214 | 6,8 | 17,1 | 45 (21 %) | 66 (31 %) |
| Säkerhetsgranskare | 46 | 5,0 | 10,9 | 3 (6,5 %) | 2 |
| Kodgranskare | 33 | 4,8 | 10,2 | 2 (6,1 %) | 3 |
| Webbläsartestare | 38 | 4,3 | 10,5 | 2 (5,3 %) | 2 |
| Allmän agent | 142 | 3,1 | 6,5 | 2 (1,4 %) | 8 |
| Arkitekt | 72 | 5,2 | 8,5 | 0 | 4 |
| Kodutforskare | 44 | 1,9 | 3,4 | 0 | 0 |
| Alla 1 238 körningar | 4,0 | 11,8 | 72 (5,8 %) | 98 (7,9 %) |
En kodagent som skriver ett test, kör det, rättar kod och kör det igen behöver mer tid och fler anrop än en som läser filer. Med en enda gräns avbryts kodaren en femtedel av gångerna, och utforskaren kunde hänga sex gånger sin normala längd innan något märks. Panelen jag skulle bygga visar varje typs 90:e percentil och flaggar en körande agent som passerar sin egen, inte ett globalt tal. Innan jag stoppar en läser jag dess senaste loggade åtgärd: en agent 15 minuter in i en lång testkörning arbetar, en vars senaste åtgärd var för 10 minuter sedan har fastnat.
Vad kostar en körning i tokens?
En mediankörning använde 125 828 tokens och 90:e percentilen 211 884, där allt agenten läste och skrev är räknat. Utforskare låg lägre (median 86 389), allmänna agenter högre (141 495). Priser ändras för ofta för att skrivas ut; dashboarden bör därför spara tokens per körning och modell och använda den aktuella prislistan när den ritar kostnaden. Vad samma arbete kostar på olika modeller finns i Vad kostar en AI-agent? Siffror från 4 projekt.
Av de 1 775 starterna gick 883 till den medelstora modellen, 827 till den största, 33 till den senaste toppmodellen och 32 till andra; 54 % av agenterna fick ändra filer.
Lyckades de körningar som avslutades faktiskt?
Av 1 238 körningar som rapporterade tillbaka slutfördes 1 172, 64 misslyckades och 2 stoppades. De 94,7 % säger att agenten blev klar, inte att dess arbete var rätt. I min uppsättning går varje kodändring fortfarande genom en säkerhetsgranskare och en kodgranskare, som kan skicka tillbaka den; inget av det syns i en körnings status. En dashboard kan visa att en körning tog slut. Om resultatet är korrekt krävs en andra agent, ett test eller en människa.
Vilka verktyg finns för detta?
För en produktionsapp där agenter pratar med kunder täcker hostade spårningsverktyg som Langfuse, LangSmith, Datadog eller Grafanas agentvyer latens, tokens och spår, och vissa kan bedöma utdata. För flera kodagenter på en maskin finns open source-dashboards som läser agenternas hook-händelser in i en lokal databas. Mina egna siffror kommer från de loggar uppsättningen ändå skriver: en startjournal, en rad per start, och sessionstranskripten. För en enskild utvecklare räckte det, och ett skript över de två filerna gav varje tabell här.
Hur en fullständig orkestreringsvy kan se ut, med agentkarta, workflow-byggare och kostnadsdiagram, finns i min prototyp Dashboard för multiagent-orkestrering.
Begränsningar. En utvecklare, en uppsättning, 30 dagar. “Nekad av en skyddsregel” känns igen på felmeddelandet, så några fel kan vara räknade på fel sida. Varaktighet och antal anrop kommer från agenter som kördes i bakgrunden och rapporterade tillbaka; agenter i förgrunden finns inte i varaktighetstabellen. Misslyckanden kunde inte pålitligt kopplas till agenttyper och anges därför bara som en summa.
Kör du agenter i produktion?
Jag jämför gärna erfarenheter om vad som bör mätas. Ingen säljpitch.
Hör av dig