Kurz gesagt
Was kostet ein KI-Agent im Betrieb? Drei Dinge: die Modellaufrufe, die Systeme, die der Agent bedient, und die Schutzmaßnahmen, die ein stilles Scheitern verhindern. Das gewählte Modell bewegt die Tokenrechnung am stärksten: Tausend identische Agentenschritte kosten USD 0,46 mit DeepSeek V4.1 Flash, USD 0,65 mit Claude Haiku 5.5 und USD 26 mit Claude Opus 5.5. In vier Systemen, die ich dieses Jahr gebaut habe, ließen sich die Modellaufrufe auch am leichtesten deckeln: USD 0,05 für eine Hintergrundprüfung, höchstens USD 2,10 für einen kompletten Recherchelauf. Der Proxy-Verkehr für einen Preis-Benchmark-Lauf kostete USD 3,08, und die teuren Überraschungen waren Fehler, die niemand sah, etwa ein Ausfall, der 8 Tage lief, bevor ihn jemand bemerkte.
Ich bin Denys, Full-Stack- und KI-Entwickler. Die meisten Artikel zu dieser Frage nennen breite Spannen ohne ein Projekt dahinter. Unten stehen die Zähler aus vier Dingen, die ich gebaut habe und betreibe, mit der Quelle jeder Zahl: Konfigurationsdateien, Commit-Nachrichten und gemessene Läufe. Wo eine Zahl eine von mir gesetzte Obergrenze ist und keine gezahlte Rechnung, sage ich das.
Was kostet ein KI-Agent im Betrieb, und wofür zahlen Sie?
Drei Zähler, und das Modell ist nur einer davon.
| Projekt | Was die KI tut | Modellkosten je Einheit | Was sonst die Rechnung treibt |
|---|---|---|---|
| Persönlicher Assistent | Chattet auf Telegram, bedient CRM und E-Mail, recherchiert im Web | USD 0,00065 bis 0,026 je Schritt, je nach Modell; Obergrenzen von USD 0,05 bis 2,10 je Lauf | Ein Server, dazu Wiederholungen und Watchdogs |
| Preis-Benchmark für ein Reisebüro | Ein separater KI-Agent startet Benchmark-Läufe über einen MCP-Server | Bei mir null: Dieser Agent zahlt seine Tokens selbst | Proxy-Verkehr, etwa USD 3,08 je Lauf, und ein Server mit 8 Kernen |
| Audioprüfung bei Live-Übertragungen | Erkennt Sprache und gesprochene Sprache auf jedem Kanal | Null je Aufruf: Zwei kleine Modelle laufen auf dem Rechner vor Ort | CPU: Eine Demo mit 32 Kanälen brauchte etwa 0,9 eines Cloud-Servers mit 2 Kernen |
| Immobilienzertifikate | Liest unbekannte Portale wie ein Mensch | Tokens nur für Portale, die die Skripte nicht kennen | Skripte erledigen das bekannte Portal ganz ohne Tokens |
In allen vier Fällen galt dasselbe Muster: Der billigste Token ist der, den Sie nie senden, und die teuren Stunden stecken in den Teilen rund um das Modell.
Was kosten die Modellaufrufe?
Der Assistent ist der einzige der vier, bei dem die Modellrechnung bei mir liegt. Er läuft auf dem Claude Agent SDK von Anthropic, und jeder Agent darin hat im Code eine harte Obergrenze. Das SDK beendet einen Lauf, wenn er das Zuglimit oder das Dollarlimit erreicht.
| Aufgabe | Modell | Obergrenze je Lauf |
|---|---|---|
| Hintergrundprüfung im Leerlauf | Claude Haiku 4.5 | USD 0,05 und insgesamt USD 1,00 pro Tag |
| Recherche: Frage zerlegen | Claude Opus 4.6 | USD 0,10, 1 Zug |
| Recherche: drei Rechercheure parallel | Claude Opus 4.6 | je USD 0,50, 3 Züge, Websuche und Abruf |
| Recherche: Antwort schreiben | Claude Opus 4.6 | USD 0,50, 1 Zug |
| Hauptunterhaltung | Haiku, Sonnet oder Opus, siehe unten | 200 Züge oder USD 50, eher ein Sicherheitsnetz als eine Erwartung |
Ein kompletter Recherchelauf kostet also höchstens USD 0,10 + 3 × 0,50 + 0,50 = USD 2,10. Das ist eine Obergrenze, kein Durchschnitt; was ein Lauf wirklich kostet, hängt vom Modell ab, das der nächste Abschnitt bepreist.
Zwei Entscheidungen senkten die Rechnung stärker als jede Preisänderung:
- Jede Nachricht an das günstigste Modell schicken, das sie bewältigt. Kurze, einfache Nachrichten gehen an Haiku, mittlere an Sonnet, mehrstufige an Opus. Der Router liest Schlüsselwörter und Nachrichtenlänge, das Routing selbst kostet also keinen Modellaufruf. Anfangs liefen alle Agenten auf Opus.
- Aufrufe streichen, die ihren Platz nicht verdienen. Die Hintergrundprüfung bat das Modell früher in jedem Zyklus um einen Statusbericht. Sie hatte keinen Zugriff auf E-Mail oder CRM, konnte also nur Nachrichten schreiben, die niemand brauchte. Ich habe den Modellaufruf ganz entfernt. Das Tageslimit von USD 1,00 steht noch in der Konfiguration und bewacht nichts.
Eine ehrliche Lücke: Das SDK meldet die Kosten jedes Aufrufs, und ich habe sie nie gespeichert. Die Monatssumme steht in der Anthropic-Konsole, nicht in der App. Würde ich es neu bauen, würde ich die Kosten je Aufruf von Tag eins an protokollieren, damit man sieht, welche Aufgabe das Geld ausgibt, und nicht nur, wie viel.
Wie stark verändert die Modellwahl die Rechnung?
Stärker als alles andere auf der Tokenseite. Unten ist ein Agentenschritt auf verschiedenen Modellen bepreist. Der Schritt hat etwa 4.000 Tokens Eingabe und 500 Ausgabe, die Schätzung je Aufruf, die im Code des Assistenten für die Hintergrundprüfung steht. Die Preise sind die Liste von OpenRouter vom 15. Oktober 2026. OpenRouter gibt den Listenpreis jedes Anbieters weiter und nimmt seine Gebühr beim Kauf von Guthaben (5,5 % im Standardtarif), nicht je Anfrage.
| Modell | Preis je 1 Mio. Tokens, Ein / Aus | Ein Schritt | 1.000 Schritte |
|---|---|---|---|
| DeepSeek V4.1 Flash | USD 0,024 / 0,72 | USD 0,00046 | USD 0,46 |
| Claude Haiku 5.5, GPT-6 Luna | USD 0,10 / 0,50 | USD 0,00065 | USD 0,65 |
| Qwen3.8 Flash | USD 0,15 / 0,47 | USD 0,00083 | USD 0,83 |
| Mistral Small 4 | USD 0,15 / 0,60 | USD 0,00090 | USD 0,90 |
| Llama 4 Maverick | USD 0,188 / 0,652 | USD 0,0011 | USD 1,08 |
| Gemini 3.5 Flash Lite | USD 0,30 / 2,50 | USD 0,0025 | USD 2,45 |
| DeepSeek V4 Pro | USD 0,955 / 1,911 | USD 0,0048 | USD 4,78 |
| Gemini 3.8 Flash | USD 0,75 / 3,75 | USD 0,0049 | USD 4,88 |
| Grok 4.7 | USD 2 / 6 | USD 0,011 | USD 11 |
| Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon | USD 2 / 10 | USD 0,013 | USD 13 |
| Claude Opus 5.5 | USD 4 / 20 | USD 0,026 | USD 26 |
| Claude Fable 5.1, GPT-6 Astra | USD 10 / 50 | USD 0,065 | USD 65 |
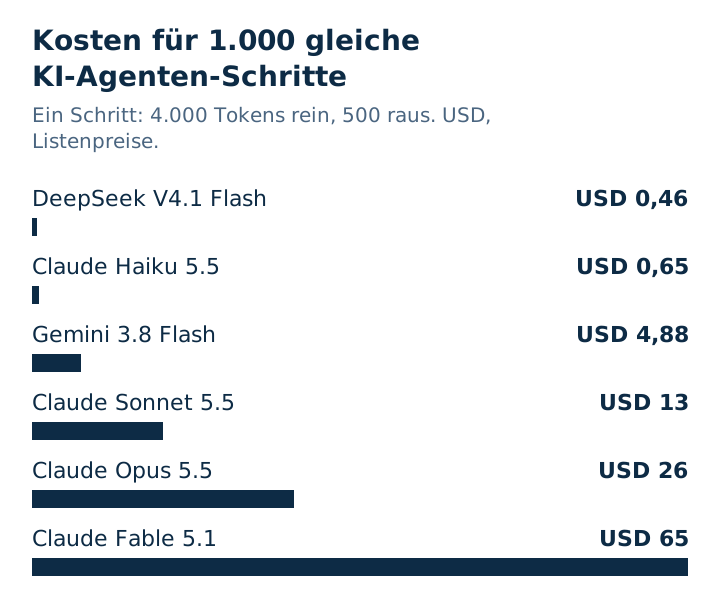
Dieselbe Arbeit kostet von USD 0,46 bis USD 65 je tausend Schritte, eine Spanne von etwa dem 140-Fachen. Drei Dinge folgen daraus:
- Ein kleines Modell bewältigt die meisten Schritte. Eine Nachricht einsortieren, Felder aus einem Dokument ziehen, aus einem bekannten Text antworten: Dafür braucht es selten ein Spitzenmodell. Die großen Modelle sind für Planung und schwieriges Schlussfolgern da, so wie es das Routing oben macht.
- Preise ändern sich schnell. Der Assistent lief auf Claude Haiku 4.5, Sonnet 4.6 und Opus 4.6. In der heutigen Liste kostet der Schritt USD 0,0065 mit Haiku 4.5 und USD 0,00065 mit Haiku 5.5. Anthropic weist darauf hin, dass die neueren Modelle für denselben Text etwa 30 % mehr Tokens zählen; je Schritt ist das neuere also immer noch fast achtmal günstiger. Googles Gemini 4 Argon soll am 1. Dezember 2026 seinen Preis verdoppeln. Prüfen Sie nach, bevor Sie ein Jahr vorausplanen.
- Vergleichen Sie Aufgaben, nicht Tokenpreise. Ein günstigeres Modell, das zwei Versuche oder einen längeren Prompt braucht, um sich richtig zu verhalten, kann je fertiger Aufgabe mehr kosten. Messen Sie vor der Wahl eine Stichprobe echter Aufgaben auf zwei oder drei Modellen.
Ihre eigene Schätzung ist eine Zeile: Schritte je Aufgabe × Aufgaben pro Monat × Schrittpreis Ihres Modells.
Warum war der Kontext das eigentliche Problem und nicht der Preis je Token?
Der Preis je Token ist vorhersehbar. Der Kontext nicht. Die Fehler, die diesem Assistenten wehtaten, drehten sich alle darum, wie viel Text in jeden Aufruf ging:
- Lange Sitzungen zerstörten Antworten. Um schneller zu antworten, hielt die App zwischen Nachrichten eine warme Sitzung offen. Als der Kontext überlief, gab das Modell verstümmelten Text in gemischten Alphabeten zurück. Die Lösung: Die Sitzung nach 20 Nachrichten erneuern und bei einer kaputt wirkenden Antwort in einer frischen wiederholen.
- Ein gespeicherter Checkpoint wurde zu groß. Eines Tages scheiterten Aufrufe mit „Prompt is too long“. Der Checkpoint, der in jeden Aufruf eingefügt wird, ist jetzt auf 2 KB begrenzt.
- Der Systemprompt trug Dateien, die er selten brauchte. Fähigkeiten nur zu laden, wenn eine Nachricht sie braucht, sparte etwa 3.000 Tokens je Aufruf, und drei Referenzdateien aus dem Vorabladen zu nehmen, sparte weitere etwa 1.500. Das sind Schätzungen aus den Commit-Notizen, keine Rechnungszeilen.
- Der Verlauf war länger als nützlich. Der mit jedem Aufruf gesendete Chatverlauf sank von 20 auf 10 Nachrichten.
Jede dieser Änderungen senkt die Kosten und beschleunigt zugleich die Antworten. Behandeln Sie Kontext wie ein Budget, genau wie Geld.
Was kostet die Infrastruktur, die ein Agent bedient?
Im Reisepreis-Benchmark ist der KI-Teil ein separater Agent. Er startet Benchmark-Läufe über einen MCP-Server, den ich gebaut habe, und seine Tokens gehen auf Rechnung dessen, der diesen Agenten betreibt. Wofür der Benchmark selbst zahlt, ist das Scraping dahinter: Residential-Proxys und ein Server voller Browser.
Gemessene Zahlen aus diesem System:
- Proxy-Verkehr: Ein Lauf über zwei Reiseseiten verbrauchte etwa 935 MB, rund USD 3,08, ungefähr 0,23 MB je gespeicherter Preiszeile.
- Tracker blockieren: Auf einer Seite senkte das Blockieren von Tracking-Skripten den Verkehr von 4,2 MB auf 2,5 MB je Suche, bei identischen Preisen in allen sechs Testläufen.
- Kein Browser, wo keiner nötig ist: Die Preise einer Seite ließen sich mit einem einfachen HTTP-Client lesen, der wie ein mobiler Browser auftritt. Die Erfassung stieg von 8 auf 43 Daten pro Minute bei fünf Workern, und der Browsercode für diese Seite wurde gelöscht.
- Die CPU bestimmt die Servergröße, nicht der Speicher: Mit 20 Browsern auf einem Server mit 8 Kernen lag die Last bei etwa 30, während 6 bis 7 GB RAM frei blieben. Ein warmer Browser belegt etwa 345 MB. Dimensionieren Sie den Server nach Kernen.
Bedient Ihr Agent Browser, Proxys oder kostenpflichtige APIs, werden diese Zähler die Modellrechnung wahrscheinlich übersteigen. Messen Sie sie je Aufgabe, bevor Sie ein Modell wählen.
Wann ist KI vor Ort günstiger als eine API?
Wenn die Eingabe das Gebäude nie verlassen muss und das Modell klein ist. Das Übertragungsprojekt prüft live Audiokanäle bei Sportübertragungen: Stille, Störgeräusche, einen Kommentator, der in die falsche Sprache wechselt. Jede Sekunde Audio an eine API zu schicken, würde bei jedem Aufruf Geld kosten und Verzögerung bringen.
Stattdessen laufen zwei offene Modelle auf dem Rechner vor Ort: Eines erkennt Sprache, das andere benennt die Sprache. Zusammen haben sie etwa 24 MB Gewichte, der Spracherkenner braucht etwa 7 MB RAM, und es gibt keine Gebühr je Aufruf. In einer Demo mit 32 Kanälen brauchte die Echtzeitanalyse aller Kanäle etwa 0,9 eines Cloud-Servers mit 2 Kernen.
Der Preis dafür ist Genauigkeit, die Sie selbst belegen müssen. Auf einem öffentlichen Satz sauber vorgelesener Sprache, 30 Clips von drei Sekunden je Sprache, lag das Sprachmodell bei Portugiesisch in 93,3 % der Fälle richtig und bei Spanisch, Englisch und Französisch bei mindestens 96,7 %. Das ist eine Obergrenze, keine Prognose: Publikumslärm und Musik unter einem Kommentator wurden nie gemessen, weil kein Audio aus einer echten Übertragungsstrecke vorlag.
Was kostet es, einen Agenten sicher sich selbst zu überlassen?
Diese Kosten überspringen die meisten Schätzungen, und hier gingen meine Stunden hin. Einige echte Fehler:
- Ein stiller Ausfall über 8 Tage. Ein anderes Projekt auf demselben Server aktualisierte einen gemeinsamen Browser-Cache. Der Pool des Scrapers fiel von 40 funktionierenden Browsern auf 0, Jobs hingen ohne Fehler, und nichts alarmierte jemanden. Die Lösung war klein: dem Scraper einen eigenen Browser-Cache geben. Die Ursache zu finden dauerte 8 Tage, weil es keinen Alarm auf die Bereitschaft des Pools gab.
- Ein Job, der mit nichts „erfolgreich“ war. Ein Lauf ging in 12 Minuten durch 359 Daten, speicherte 0 Zeilen und meldete Erfolg. Jobs brechen jetzt nach 25 leeren Daten in Folge ab und sagen, warum.
- Ein gestoppter Lauf, der weiter Geld ausgab. Ein als gestoppt markierter Benchmark lief 4 Stunden weiter und verbrauchte die ganze Zeit Proxy-Verkehr.
- Ein Proxy-Limit leerte den Pool. Als der Proxy-Tarif sein Verkehrslimit erreichte, schrumpfte der Pool in 12 Minuten von 40 Browsern auf 0 und blieb bis zu einem Neustart dort. Jetzt füllt er sich alle 60 Sekunden selbst wieder auf und weicht bis auf 5 Minuten aus.
- Am ersten Tag zu viele Alarme. Der erste Test des Übertragungswerkzeugs an einem echten Feed mit 16 Kanälen und 49 Minuten Länge erzeugte 3.492 Ereignisse. 92,4 % waren Rauschen und Stimmwechsel-Alarme, und der Operator drückte in 27 Minuten 182-mal auf Löschen. Die Detektoren waren in Ordnung; die Schwellenwerte hatten nie echtes Programmaudio gesehen. Die Lösung war ein Schalter je Profil, keine neue Mathematik.
- Hängende Aufrufe und Ratenlimits. Der Assistent hat jetzt einen Watchdog von 120 Sekunden für einen Aufruf, der verstummt, ein Limit von 300 Sekunden für den ganzen Aufruf und bis zu 3 Wiederholungen nach 30 Sekunden, 2 Minuten und 5 Minuten, wenn die API überlastet oder ratenbegrenzt ist. Ein hängender Werkzeugaufruf fällt nicht auf die Ersatzmodelle zurück, denn ein langsameres Modell behebt kein festgefahrenes Werkzeug.
Nichts davon zeigt sich als Tokenpreis. Es zeigt sich als Stunden und als verlorenes Vertrauen, wenn der Agent „erledigt“ sagt und falsch liegt. Planen Sie es ein: einen ersten Test mit echten Daten, Alarme für alles, was still ausfallen kann, und Prüfungen, dass ein „Erfolg“ auch etwas erzeugt hat.
Wo hat KI ihren Platz, wenn Skripte das meiste erledigen?
An den Rändern. Der Immobilienzertifikat-Service sammelt Unterlagen aus den Online-Konten von Hausverwaltungen und erstellt das Zertifikat, das ein Verkäufer braucht. Ein Skript erledigt das wichtigste bekannte Portal, bei dem 95 % der Dokumente vollständig werden. Bildverstehende KI liest nur die Portale, die die Skripte nicht kennen, und dieser Weg liegt hinter einem Schalter, der ihn sofort abschaltet.
Für die, die sie bestellen, dauert ein Zertifikat jetzt 2 bis 3 Minuten statt 2 bis 3 Wochen und kostet EUR 99 statt EUR 200 bis 300. Die KI ist in dieser Kette absichtlich der kleinere Teil: Skripte sind dort, wo sie funktionieren, günstig und vorhersehbar, und das Modell kommt dort zum Einsatz, wo nur Lesen wie ein Mensch hilft.
Wie schätzen Sie die Betriebskosten Ihres eigenen KI-Agenten?
Schreiben Sie vor der Angebotsanfrage fünf Zahlen auf:
- Aufgaben pro Monat. Nachrichten, Dokumente, Läufe.
- Modellaufrufe je Aufgabe und welches Modell jeder braucht. Die meisten Aufgaben brauchen nicht das Spitzenmodell.
- Tokens je Aufruf. Systemprompt, Verlauf, Dokumente. Hier wachsen die Kosten leise.
- Die anderen Zähler. Proxys je MB, kostenpflichtige APIs je Aufruf, Server je Kern.
- Eine Obergrenze für jeden Job. Ein Dollarlimit je Lauf im Code, nicht nur ein Monatslimit am Konto.
Addieren Sie dann die Kosten, die niemand nennt: einen Test mit echten Daten in Woche eins, Alarme für stille Fehler und jemanden, der sie liest.
Was diese Zahlen nicht sagen
Die Obergrenzen oben sind von mir gesetzte Limits, nicht ausgegebenes Geld, und die Modelltabelle zeigt Listenpreise, nicht meine Rechnungen. Jede Projektzahl stammt aus einem System und einem Zeitraum. Modellpreise ändern sich oft, prüfen Sie also vor der Planung die aktuellen Preisseiten der Anbieter. Und nichts davon sagt, wie lange die Projekte im Bau dauerten oder was ihr Bau kostete; das hängt weit mehr von den Integrationen ab als von der KI.
Wenn Sie einen Agenten planen und sich über die Betriebskosten austauschen möchten, schaue ich mir Ihre Zahlen gern an. Meine Seite zur Entwicklung von KI-Agenten zeigt, wie ich arbeite, und der Fall Immobilienzertifikate, der Fall Audio bei Live-Übertragungen und der Fall Reisepreise zeigen drei dieser Projekte genauer. Bei einem Bot auf WhatsApp wiegen die Kanalgebühren oft schwerer als das Modell; ich habe sie je Land in was ein WhatsApp-KI-Chatbot kostet durchgerechnet.
Quellen
- Anthropic, Claude Agent SDK options:
max_turnsundmax_budget_usdbeenden einen Lauf; jedes Ergebnis meldettotal_cost_usd. - OpenRouter, model list prices und platform fees, gelesen am 15. Oktober 2026.
- Anthropic, Claude pricing, und Google, Gemini API pricing, gelesen am 15. Oktober 2026: der Hinweis zum Tokenizer und die Preisänderung bei Gemini 4 Argon.
- Alle Projektzahlen: die eigenen Konfigurationsdateien, Commit-Nachrichten und gemessenen Läufe der Projekte, 2026.