TL;DR
Jeg hentede 30 dages logs fra det agentsetup, jeg bygger med: 127.610 værktøjskald og 1.238 færdige agentkørsler. Tre ting afgjorde, hvad et overvågningsdashboard bør vise. 59 % af alle værktøjsfejl var mine egne beskyttelsesregler, der afviste noget, ikke noget, der gik i stykker; fejl skal derfor have to tællere. Én tidsgrænse til alle agenter er forkert: 21 % af mine test-first-kodeagenter løb over 12 minutter, mod 0 % af kodeudforskerne. Og 1 ud af 5 agentstarter blev afvist, før de begyndte, hvilket intet diagram over “kørsler pr. dag” viser.
Jeg hedder Denys og er full-stack- og AI-udvikler. Jeg bygger med én ledende kodesession, der giver arbejde videre til specialiserede agenter: udforskere, en planlægger, test-first-kodere, sikkerheds- og kodereviewere. I Multi-agent orchestration: hvad gik galt i 3.315 kørsler talte jeg fejlene. Her er spørgsmålet et andet, set fra AI agent monitoring: hvad hører hjemme på dashboardet?
Data. Sessionslogs og startjournalen fra mit eget setup, 24. september til 23. oktober 2026. Hvert tal nedenfor er beregnet ud fra dem med ét script; kunde- og projektnavne indgår ikke i de data, jeg brugte. Det er én persons arbejdsbyrde, ikke en benchmark.
Hvad skal et AI agent monitoring dashboard vise?
Leverandørguides, som Grafanas dokumentation om agent-observerbarhed, drejer sig om latenstid, tokens, pris og fejl. Mine logs siger, at de fire er nødvendige, men ikke nok. Fem paneler:
- Starter: påbegyndt, afvist, færdig, fejlet, pr. dag.
- Fejl delt i “afvist af en regel” og “gik i stykker”, pr. værktøj.
- Varighed og værktøjskald pr. agenttype, som median og 90. percentil, med en grænse pr. type.
- Tokens pr. kørsel, altså prisen.
- Hvad kører lige nu, med hver kørsels forløbne tid mod den normale vifte for dens type.
Resten af artiklen er tallene bag hver af dem.
Hvor mange agentstarter begynder aldrig?
| Starter, 30 dage | Antal |
|---|---|
| Startforsøg | 1.775 |
| Afvist før start | 352 (19,8 %) |
| Travleste dag | 258 starter |
| Median-dag | 40 starter |
Mit setup tjekker hver start: om briefen nævner de filer, agenten må ændre, om en anden kørende agent allerede holder dem, hvilken model et risikabelt trin kræver. Én start ud af fem bestod ikke. Et diagram over kørsler tæller kun de starter, der begyndte, og skjuler dem alle.
Hvorfor skal værktøjsfejl have to tællere?
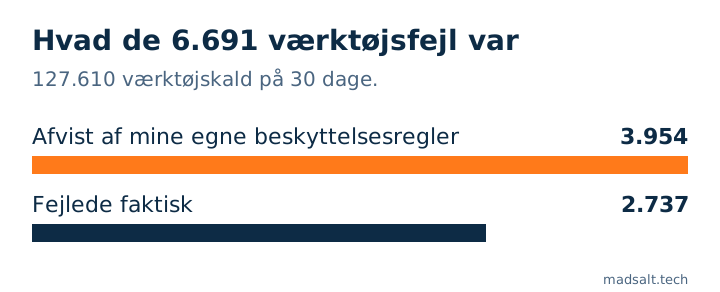
Af 127.610 værktøjskald kom 6.691 tilbage som fejl: 52 pr. 1.000 kald. Så delte jeg dem efter, hvad fejlen sagde:
| Værktøj | Kald | Fejl | Heraf afvist af en beskyttelsesregel |
|---|---|---|---|
| Shell | 50.960 | 4.985 | 2.970 |
| Rediger fil | 28.244 | 743 | 602 |
| Læs fil | 26.348 | 145 | 1 |
| Skriv fil | 8.238 | 208 | 195 |
| Start agent | 1.719 | 287 | 132 |
| Websøgning | 2.527 | 57 | 0 |
3.954 af de 6.691 fejl, 59 %, var mine egne regler, der sagde nej: en kommando, der ville have sprunget et tjek over, en redigering før et påkrævet opslag, en skrivning til en fil, en anden agent ejer. Stiger tallet, gør reglerne deres arbejde, eller en agent kæmper imod dem. De øvrige 2.737 er rigtige fejl: en test, der fejlede, en kommando, der gik ned, en side, der ikke ville indlæses. På ét diagram blandes de to: en dag med mange afvisninger ligner en dårlig dag, selv om intet gik i stykker.
Passer én tidsgrænse til alle agenter?
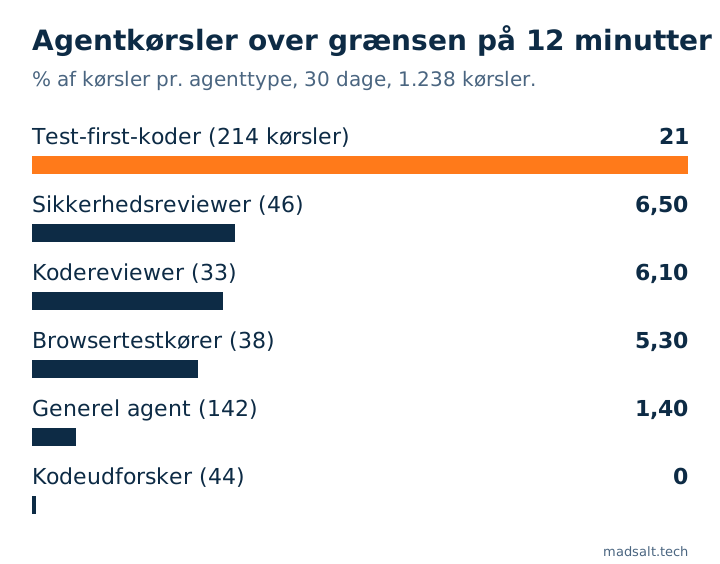
Nej. Jeg stopper en subagent efter 12 minutter eller 80 værktøjskald, og logs viser, hvor forskellige typerne er:
| Agenttype | Kørsler | Median (min.) | 90. percentil | Over 12 minutter | Over 80 værktøjskald |
|---|---|---|---|---|---|
| Test-first-koder | 214 | 6,8 | 17,1 | 45 (21 %) | 66 (31 %) |
| Sikkerhedsreviewer | 46 | 5,0 | 10,9 | 3 (6,5 %) | 2 |
| Kodereviewer | 33 | 4,8 | 10,2 | 2 (6,1 %) | 3 |
| Browsertestkører | 38 | 4,3 | 10,5 | 2 (5,3 %) | 2 |
| Generel agent | 142 | 3,1 | 6,5 | 2 (1,4 %) | 8 |
| Arkitekt | 72 | 5,2 | 8,5 | 0 | 4 |
| Kodeudforsker | 44 | 1,9 | 3,4 | 0 | 0 |
| Alle 1.238 kørsler | 4,0 | 11,8 | 72 (5,8 %) | 98 (7,9 %) |
En kodeagent, der skriver en test, kører den, retter kode og kører den igen, har brug for mere tid og flere kald end en, der læser filer. Med én grænse bliver koderen afbrudt en femtedel af gangene, og udforskeren kunne hænge seks gange sin normale længde, før nogen opdager det. Det panel, jeg ville bygge, viser hver types 90. percentil og markerer en kørende agent, der overskrider sin egen, ikke et globalt tal. Før jeg stopper en, læser jeg dens sidste loggede handling: en agent 15 minutter inde i en lang testkørsel arbejder, en hvis sidste handling var for 10 minutter siden, sidder fast.
Hvad koster en kørsel i tokens?
En median-kørsel brugte 125.828 tokens og 90. percentil 211.884, hvor alt agenten læste og skrev er talt med. Udforskere lå lavere (median 86.389), generelle agenter højere (141.495). Priser ændrer sig for ofte til at trykke dem; dashboardet bør derfor gemme tokens pr. kørsel og model og anvende den gældende prisliste, når det tegner prisen. Hvad det samme arbejde koster på forskellige modeller, står i Hvad koster en AI-agent i drift?.
Af de 1.775 starter gik 883 til den mellemstore model, 827 til den største, 33 til den nyeste topmodel og 32 til andre; 54 % af agenterne måtte ændre filer.
Lykkedes de kørsler, der blev færdige, faktisk?
Af 1.238 kørsler, der meldte tilbage, blev 1.172 gennemført, 64 fejlede og 2 blev stoppet. De 94,7 % siger, at agenten blev færdig, ikke at dens arbejde var rigtigt. I mit setup går hver kodeændring stadig gennem en sikkerhedsreviewer og en kodereviewer, som kan sende den tilbage; intet af det kan ses i en kørsels status. Et dashboard kan vise, at en kørsel sluttede. Om resultatet er korrekt, kræver en anden agent, en test eller et menneske.
Hvilke værktøjer findes til det?
Til en produktionsapp, hvor agenter taler med kunder, dækker hostede sporingsværktøjer som Langfuse, LangSmith, Datadog eller Grafanas agentvisninger latenstid, tokens og spor, og nogle kan bedømme output. Til flere kodeagenter på én maskine findes open source-dashboards, der læser agenternes hook-hændelser ind i en lokal database. Mine egne tal kommer fra de logs, setuppet skriver alligevel: en startjournal, én linje pr. start, og sessionstranskriptionerne. For en enkelt udvikler var det nok, og et script over de to filer producerede hver tabel her.
Hvordan en fuld orkestreringsvisning kan se ud, med agentkort, workflow-builder og prisdiagrammer, står i min prototype Dashboard til multiagent-orkestrering.
Begrænsninger. Én udvikler, ét setup, 30 dage. “Afvist af en beskyttelsesregel” genkendes på fejlteksten, så nogle fejl kan være talt på den forkerte side. Varighed og antal kald kommer fra agenter, der kørte i baggrunden og meldte tilbage; agenter i forgrunden er ikke i varighedstabellen. Fejl kunne ikke pålideligt henføres til agenttyper og angives derfor kun som en total.
Kører du agenter i produktion?
Jeg udveksler gerne erfaringer om, hvad du bør måle. Ingen salgstale.
Kontakt mig