Em resumo
Extraí 30 dias de logs da configuração de agentes com que trabalho: 127.610 chamadas a ferramentas e 1.238 execuções de agentes concluídas. Três coisas decidiram o que um dashboard de monitorização deve mostrar. 59% de todos os erros de ferramentas eram as minhas próprias regras de proteção a recusar algo, não algo a partir-se, por isso os erros precisam de dois contadores. Um único limite de tempo para todos os agentes está errado: 21% dos meus agentes de código com teste primeiro passaram dos 12 minutos, contra 0% dos exploradores de código. E 1 em cada 5 lançamentos de agentes foi recusado antes de começar, o que nenhum gráfico de “execuções por dia” mostra.
Sou o Denys, engenheiro full-stack e de IA. Construo com uma sessão principal de código que entrega o trabalho a agentes especializados: exploradores, um planeador, programadores com teste primeiro, revisores de segurança e de código. Em o que falhou em 3.315 execuções de agentes contei as falhas. Este texto faz outra pergunta: o que deve ir no dashboard?
Dados. Logs de sessão e registo de lançamentos da minha própria configuração, de 24 de setembro a 23 de outubro de 2026. Cada número abaixo sai deles com um único script; os nomes de clientes e projetos não estão nos dados que usei. É a carga de trabalho de uma pessoa, não um benchmark.
O que deve mostrar um dashboard de monitorização de agentes de IA?
Os guias dos fornecedores, como a documentação de observabilidade de agentes da Grafana, giram em torno de latência, tokens, custo e erros. Os meus logs dizem que esses quatro são necessários e não chegam. Cinco painéis:
- Lançamentos: iniciados, recusados, concluídos, falhados, por dia.
- Erros divididos em “recusados por uma regra” e “partiu-se”, por ferramenta.
- Duração e chamadas a ferramentas por tipo de agente, como mediana e percentil 90, com um limite por tipo.
- Tokens por execução, que é o custo.
- O que está a correr agora, com o tempo decorrido de cada execução face ao intervalo normal do seu tipo.
O resto deste texto são os números por trás de cada um.
Quantos lançamentos de agentes nunca começam?
| Lançamentos, 30 dias | Quantidade |
|---|---|
| Tentativas de lançamento | 1.775 |
| Recusados antes de começar | 352 (19,8%) |
| Dia mais intenso | 258 lançamentos |
| Dia mediano | 40 lançamentos |
A minha configuração verifica cada lançamento: se o pedido nomeia os ficheiros que o agente pode alterar, se outro agente em execução já tem esses ficheiros, que modelo um passo de risco exige. Um lançamento em cada cinco não passou. Um gráfico de execuções conta só os lançamentos que começaram, por isso esconde-os todos.
Porque é que os erros de ferramentas precisam de dois contadores?
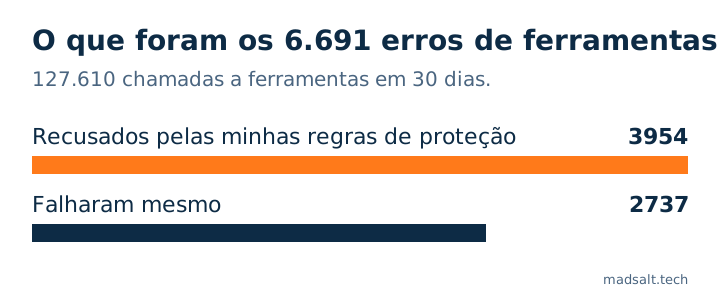
Em 127.610 chamadas a ferramentas, 6.691 voltaram como erros: 52 por 1000 chamadas. Depois dividi-os pelo que o erro dizia:
| Ferramenta | Chamadas | Erros | Destes, recusados por uma regra de proteção |
|---|---|---|---|
| Terminal | 50.960 | 4.985 | 2.970 |
| Editar ficheiro | 28.244 | 743 | 602 |
| Ler ficheiro | 26.348 | 145 | 1 |
| Escrever ficheiro | 8.238 | 208 | 195 |
| Lançar agente | 1.719 | 287 | 132 |
| Pesquisa na web | 2.527 | 57 | 0 |
3.954 dos 6.691 erros, 59%, foram as minhas próprias regras a dizer que não: um comando que saltaria uma verificação, uma edição antes de uma consulta obrigatória, uma escrita num ficheiro que pertence a outro agente. Esse número a subir significa que as regras estão a cumprir a sua função ou que um agente luta contra elas. Os outros 2.737 são falhas reais: um teste que falhou, um comando que rebentou, uma página que não carregou. Num só gráfico os dois misturam-se: um dia com muitas recusas parece um mau dia, quando nada se partiu.
Serve um único limite de tempo para todos os agentes?
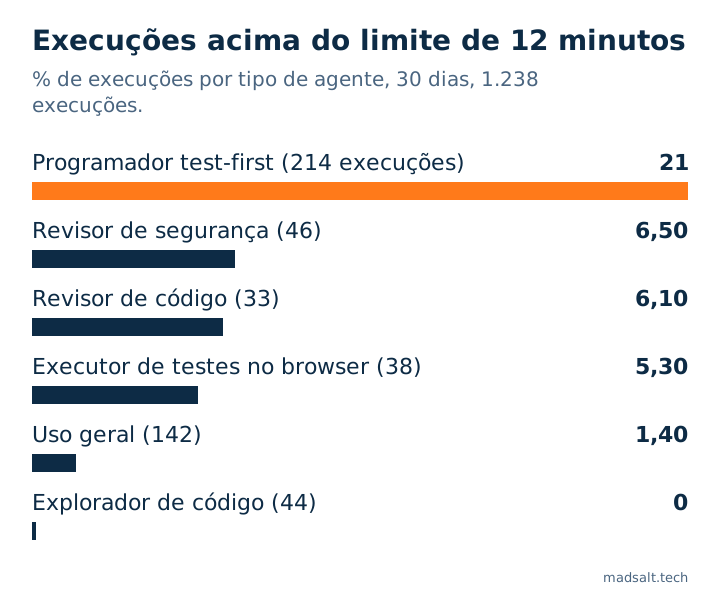
Não. Paro um subagente ao fim de 12 minutos ou 80 chamadas a ferramentas, e os logs mostram como os tipos são diferentes:
| Tipo de agente | Execuções | Mediana (min) | Percentil 90 | Mais de 12 minutos | Mais de 80 chamadas |
|---|---|---|---|---|---|
| Programador test-first | 214 | 6,8 | 17,1 | 45 (21%) | 66 (31%) |
| Revisor de segurança | 46 | 5,0 | 10,9 | 3 (6,5%) | 2 |
| Revisor de código | 33 | 4,8 | 10,2 | 2 (6,1%) | 3 |
| Executor de testes no browser | 38 | 4,3 | 10,5 | 2 (5,3%) | 2 |
| Uso geral | 142 | 3,1 | 6,5 | 2 (1,4%) | 8 |
| Arquiteto | 72 | 5,2 | 8,5 | 0 | 4 |
| Explorador de código | 44 | 1,9 | 3,4 | 0 | 0 |
| As 1.238 execuções | 4,0 | 11,8 | 72 (5,8%) | 98 (7,9%) |
Um agente de código que escreve um teste, o executa, corrige código e volta a executar precisa de mais tempo e mais chamadas do que um que lê ficheiros. Com um único limite, o programador é cortado numa quinta parte das vezes e o explorador podia ficar preso seis vezes a sua duração normal antes de alguém notar. O painel que eu construiria mostra o percentil 90 de cada tipo e assinala um agente em execução que passa o seu, não um número global. Antes de parar um, leio a sua última ação registada: um agente a 15 minutos de uma execução longa de testes está a trabalhar; um cuja última ação foi há 10 minutos está encravado.
Quanto custa uma execução em tokens?
Uma execução mediana usou 125.828 tokens e o percentil 90, 211.884, contando tudo o que o agente leu e escreveu. Os exploradores ficaram mais abaixo (mediana de 86.389), os agentes de uso geral mais acima (141.495). Os preços mudam demasiado para os imprimir, por isso o dashboard deve guardar os tokens por execução e modelo, e aplicar a tabela de preços atual ao desenhar o custo. O que o mesmo trabalho custa em modelos diferentes está em quanto custa um agente de IA.
Dos 1.775 lançamentos, 883 foram para o modelo de tamanho médio, 827 para o maior, 33 para o modelo de topo mais recente e 32 para outros; 54% dos agentes tinham permissão para alterar ficheiros.
As execuções que terminaram tiveram mesmo sucesso?
Das 1.238 execuções que reportaram, 1.172 concluíram, 64 falharam e 2 foram paradas. Esses 94,7% dizem que o agente terminou, não que o seu trabalho esteja certo. Na minha configuração cada alteração de código continua a passar por um revisor de segurança e um de código, que a podem devolver; nada disso se vê no estado de uma execução. Um dashboard pode mostrar que uma execução acabou. Saber se o resultado está correto exige um segundo agente, um teste ou uma pessoa.
Que ferramentas existem para isto?
Para uma app em produção com agentes a falar com clientes, as ferramentas de tracing alojadas como Langfuse, LangSmith, Datadog ou as vistas de agentes da Grafana cobrem latência, tokens e traces, e algumas conseguem pontuar as saídas. Para vários agentes de código numa máquina, há dashboards de código aberto que leem os eventos de hooks dos agentes para uma base de dados local. Os meus números vêm dos logs que a configuração escreve de qualquer modo: um registo de lançamentos, uma linha por lançamento, e as transcrições de sessão. Para um único programador chegou, e um script sobre esses dois ficheiros produziu todas as tabelas aqui.
Como pode ser uma vista completa de orquestração, com um mapa de agentes, um construtor de fluxos e gráficos de custo, está no meu protótipo de painel de orquestração multiagente.
Limites. Um programador, uma configuração, 30 dias. “Recusado por uma regra de proteção” é identificado pelo texto do erro, por isso alguns erros podem ser contados do lado errado. A duração e as chamadas a ferramentas vêm de agentes que correram em segundo plano e reportaram; os agentes em primeiro plano não estão na tabela de duração. As falhas não puderam ser atribuídas de forma fiável a tipos de agente, por isso são reportadas só como total.