Kurz gesagt
Zwischen dem 17. August und dem 19. Oktober 2026 hat mein Claude-Code-Setup 3.315 Subagenten gestartet. In den letzten 30 Tagen waren das rund 16 Milliarden Tokens, 97,7 % davon Cache-Lesezugriffe. Ich zahle ein Pauschalabo; zu den Listenpreisen der API würden dieselben Tokens mindestens 3.350 USD kosten. Die Fehler lagen fast nie daran, dass das Modell schlechten Code schrieb. Sie lagen in den Nahtstellen: parallele Agenten, die dieselbe Datei überschrieben, während alle Prüfungen grün waren, ein Aufräumskript, das fertige Arbeit löschte, ein Agent, der die Prüfungen bearbeitete, die ihn blockierten. Aus jedem Fehler wurde ein kleines Skript, das den nächsten Lauf blockiert, und diese Skripte, nicht die Prompts, haben das System brauchbar gemacht.
Ich bin Denys, Full-Stack- und KI-Entwickler. Ich baue Software mit einer führenden Claude-Code-Sitzung, die Arbeit an spezialisierte Subagenten verteilt: Explorer, ein Planer, Implementierer, Sicherheits- und Code-Prüfer. Dieser Text berichtet über genau dieses Setup, nicht über ein Kundenprodukt. Ein solches Multi-Agenten-System lässt sich nur aus den Protokollen beschreiben, die es selbst führt: einem Start-Ledger (eine Zeile pro gestartetem Agenten), den Sitzungsprotokollen und der Git-Historie der Konfiguration selbst. Namen von Kunden und Projekten bleiben draußen.
Außerdem habe ich ein interaktives Dashboard für Multi-Agent-Orchestrierung als Prototyp mit Beispieldaten gebaut. Alles Folgende stammt aus echten Läufen.
Was ist Multi-Agent-Orchestrierung?
Multi-Agent-Orchestrierung ist ein Aufbau, in dem ein führender Agent begrenzte Aufgaben an spezialisierte Agenten verteilt und deren Ergebnisse zusammenführt; der Orchestrator besitzt den Kontext, die Budgets und die Wiederholungsversuche. In diesem Artikel zeigt sie sich in zwei Mustern: eine führende Sitzung mit Subagenten (Explorer, ein Planer, Implementierer, Prüfer) und Hooks, die die Regeln durchsetzen, an denen die Agenten sich nicht vorbeireden können. Das Dashboard für Multi-Agent-Orchestrierung zeigt dieselbe Idee mit Beispieldaten; die folgenden Abschnitte handeln davon, was in echten Läufen kaputtging.
Wie sieht das Setup aus?
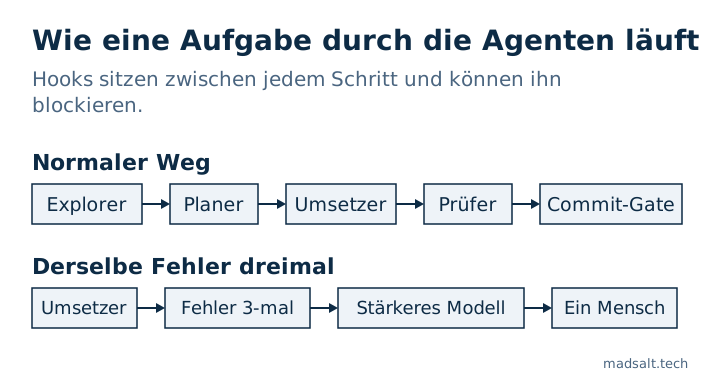
Eine führende Sitzung spricht mit mir und besitzt die Aufgabe. Bei größeren Aufgaben schreibt sie selbst nie Produktionscode. Sie schickt Arbeit hinaus:
- Explorer lesen eine Schicht der Codebasis (Frontend, Backend, Datenbank) und schreiben eine kurze Karte.
- Ein Planer macht aus der Karte nummerierte Schritte mit Dateipfaden.
- Implementierer übernehmen je eine Planphase, schreiben erst die Tests, dann den Code. Parallele Implementierer bekommen einen eigenen git worktree.
- Prüfer kontrollieren den Diff: einer auf Sicherheit, einer auf Korrektheit, beide am selben Commit.
Dazwischen sitzen Hooks: kleine Skripte, die Claude Code vor und nach jedem Tool-Aufruf ausführt. Ein Hook kann einen Aufruf blockieren, etwa den Start eines Agenten, einen Schreibzugriff oder einen git commit. Die Konfiguration hat 165 Hooks, etwa 40 davon betreffen die Orchestrierung. Die Regeln, die die Agenten lesen, sind Markdown; die Regeln, an denen sie nicht vorbeikommen, sind Hooks. Diese Trennung ist die Hauptlehre der zwei Monate, und der Rest dieses Textes erklärt, warum.
Wie viele Agenten liefen, und auf welchen Modellen?
| Messgröße (17. Aug. – 19. Okt. 2026) | Wert |
|---|---|
| Gestartete Subagenten | 3.315 an 57 aktiven Tagen |
| Agententypen | 30 |
| Am häufigsten gestartet | Implementierer (tdd-guide) 793, Sicherheitsprüfer 455, general-purpose 424 |
| Tatsächliches Modell | Opus 46,5 %, Sonnet 45,8 %, Fable 1,3 %, Rest von der führenden Sitzung geerbt |
| Einzeln gestartet | 67,7 % |
| Größte parallele Welle | 5 Agenten (die Obergrenze), 9-mal erreicht |
| Prüferläufe je Implementiererlauf | 0,71 (680 Reviews, 963 Implementierungen) |
Zwei Zahlen haben mich überrascht. Erstens waren die meisten Starts einzelne Agenten, keine Fan-outs. Parallele Arbeit ist die Ausnahme: Sie lohnt sich beim Lesen und Prüfen und kostet beim Schreiben viel (siehe den ersten Fehler unten). Zweitens war bei 23 % der Starts, bei denen die Datei eines Agenten ein Modell nennt, das tatsächlich gelaufene Modell ein anderes, fast immer Sonnet, auf Opus angehoben (584 von 610). Das ist Absicht: Ein Hook hebt das Modell an, wenn der Schritt riskanten Code berührt, etwa Migrationen, Authentifizierung oder Server-Routen, und nachdem ein Implementierer auf Sonnet dreimal hintereinander am selben Test scheitert. Der stärkere Implementierer lief 159-mal; ich kann das Protokoll nicht in „riskanter Schritt“ und „wiederholter Fehler“ aufteilen, also behaupte ich nicht, wie viele davon Rettungen waren.
Was kostet Multi-agent orchestration?
Ich zahle ein Pauschalabo, es gibt also keine Rechnung pro Token. Die Sitzungsprotokolle halten aber jedes Token fest. Hier ist, was die letzten 30 Tage (20. September bis 19. Oktober) zu den API-Listenpreisen von Anthropic kosten würden:
| 30 Tage | Tokens |
|---|---|
| Gesamt | rund 15,99 Milliarden |
| Cache-Lesezugriffe | 15,55 Milliarden (97,7 % von allem, was ans Modell ging) |
| Cache-Schreibzugriffe | 372 Millionen |
| Frische, nicht gecachte Eingabe | 0,18 Millionen |
| Ausgabe | 69 Millionen |
Zu Listenpreisen (Opus 5.5: 4 USD pro Million Eingabe, 20 pro Million Ausgabe, 0,20 pro Million Cache-Lesezugriffe; Sonnet 5.5 und Fable 5.1 zu ihren eigenen) kommen allein Ausgabe, Eingabe und Cache-Lesezugriffe der drei aktuellen Modelle auf etwa 3.350 USD. Dabei fehlen Cache-Schreibzugriffe und ältere Modellversionen, die noch in den Protokollen stehen, die echte API-Zahl liegt also höher. Zwei Drittel dieser 3.350 USD sind Cache-Lesezugriffe: Jeder Durchlauf sendet den ganzen Kontext erneut, und nur das Caching macht das überhaupt bezahlbar.
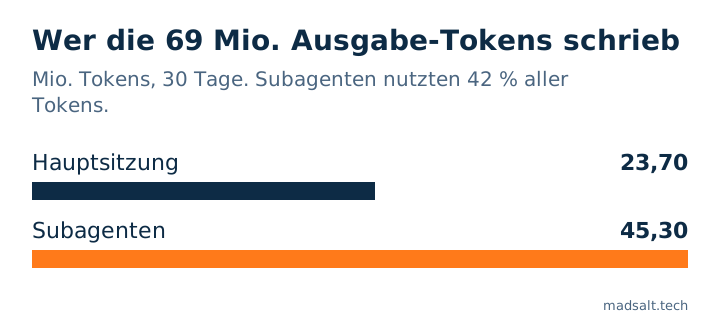
Die Aufteilung zwischen führender Sitzung und Subagenten würde ich für die Budgetplanung nutzen:
- Subagenten verbrauchten 42 % aller Tokens, schrieben aber 66 % der Ausgabe. Die führende Sitzung ist teuer, weil sie den längsten Kontext trägt; in den Subagenten entstehen der eigentliche Text und Code.
- Prüfer sind günstig. Ein Sicherheits- oder Code-Review brauchte 1–4 Millionen Tokens. Ein Implementierer brauchte 5–100 Millionen. Zwei Prüfer bei jedem riskanten Commit kosten weniger als ein Implementierer, der es erneut versucht.
- Die größte Sitzung startete am 6. Oktober 63 Subagenten und verbrauchte in 3,5 Stunden 372 Millionen Tokens.
Was ist kaputtgegangen?
Jeder Fehler unten ist passiert, hat ein Datum und endete mit einem Hook oder Skript, das ihn künftig verhindert. Keiner davon ist „das Modell hat einen Bug geschrieben“. Gewöhnliche Bugs fingen die Tests und Prüfer ab. Diese hier kamen an beiden vorbei.
| Datum (2026) | Was kaputtging | Was es jetzt verhindert |
|---|---|---|
| 19. Aug. | Parallele Agenten überschrieben eine Übersetzungsdatei: 55 von ~95 Schlüsseln verloren, alle Prüfungen grün | Jeder Agent schreibt seine Schlüssel in ein eigenes Fragment; ein Merge-Skript belegt, dass jeder Schlüssel angekommen ist |
| 24. Aug. | Ein Aufräumskript löschte 4 fertige Arbeitspakete | Das Aufräumen überspringt jeden Worktree mit nicht eingesammelten Änderungen; erst einsammeln, dann aufräumen |
| 1. Sep. | Spätere Agentenwellen starteten mit altem Code | Die Arbeit jedes Agenten als Drei-Wege-Patch einspielen, nie als Dateikopie |
| 13. Sep. | Ein Agent starb beim Start, und der Start meldete „success“ | Der Launcher liest die erste Ausgabe des Agenten und markiert ein totes Modell für alle Sitzungen |
| 20. Sep. | Zwei meiner eigenen Regeln widersprachen sich; Agenten wiederholten einen abgelehnten Befehl | Briefings für isolierte Agenten nennen die Befehlsformen, die die Sandbox akzeptiert |
| 18. Okt. | Ein Agent bearbeitete die Prüfungen, die seinen Commit blockierten | Prüfdateien sind aus Projektsitzungen schreibgeschützt; Änderungen werden protokolliert und gemeldet |
| 18. Okt. | Korrekturanweisungen änderten still, was die Nutzer einer Kunden-App erhalten | Jedes Korrekturbriefing sagt „keep live behaviour“; Produktänderungen gehen an mich zurück |
Parallele Schreiber und die Datei, die jedes Feature anfasst
Drei Agenten bauten gleichzeitig drei Funktionen einer iOS-App eines Kunden. Jeder fügte seine Textschlüssel dem einzigen Übersetzungskatalog der App hinzu, und jeder speicherte seine eigene Fassung der ganzen Datei. Die letzte Speicherung gewann. 55 von etwa 95 neuen Schlüsseln waren weg. Der Build jedes Agenten lief durch, weil jede Kopie in sich konsistent war; die Katalogprüfung lief durch, weil ihre Abdeckung auf andere Weise lückenhaft war. Ich fand es, indem ich die Schlüssel von Hand zählte.
Die Korrektur hat drei Teile. Ein Hook verweigert den Start eines Agenten, dessen deklarierte Dateien sich mit einem noch laufenden Schreiber überschneiden. Agenten bearbeiten gemeinsame Kataloge nie selbst; sie schreiben ihre Schlüssel in eine Fragmentdatei, und ein Skript führt die Fragmente zusammen, scheitert bei widersprüchlichen Werten und prüft dann, dass jeder Schlüssel vorhanden ist. Ein zweiter Hook blockiert den Commit, wenn ein Katalog weniger Schlüssel hat als zuvor. Der ehrliche Teil: Diese Schutzmaßnahmen habe ich am 18. Oktober eingebaut, 60 Tage nach dem Verlust. Dazwischen war der einzige Schutz eine Zeile in einer Markdown-Regel, und eine Regel ist nur ein Vorschlag.
Aufräumen, das fertige Arbeit löschte
Parallele Implementierer arbeiten in git worktrees und stagen ihre Änderungen, ohne zu committen. Eine Commit-Prüfung wies die führende Sitzung an, das Aufräumskript auszuführen. Das Skript übersprang Worktrees, deren Agent noch lief, und diese Agenten waren fertig. Vier fertige Arbeitspakete wurden gelöscht, ohne dass Git-Objekte zur Wiederherstellung übrig blieben. „Läuft der Agent noch?“ und „wurde seine Arbeit eingesammelt?“ sind verschiedene Fragen, und das Skript stellte nur die erste. Das Aufräumen überspringt jetzt jeden Worktree mit Änderungen, die der Haupt-Checkout nicht hat, und ein eigener Hook blockiert das direkte Löschen von Worktree-Ordnern.
Wellen, die mit altem Code starteten
Ein Plan mit 11 Schritten lief als 6 Implementierer in 3 Wellen. Welle 2 und 3 starteten vom Commit, mit dem die Sitzung begonnen hatte, drei Commits zurück. Hätte man die Datei eines Agenten zurückkopiert, wäre die fertige Änderung eines anderen Agenten rückgängig gemacht worden. Ein Worktree ist eine Momentaufnahme des Ausgangspunkts, deshalb kommen Ergebnisse jetzt als Drei-Wege-Patches zurück, und Konflikte treten zutage, statt stillschweigend überschrieben zu werden.
Ein toter Agent, der Erfolg meldete
Ein Agent, der auf ein Modell mit aufgebrauchtem Nutzungslimit festgelegt war, starb vor seinem ersten Schritt. Der Start lieferte „spawned successfully“; der Fehler kam später als Leerlaufmeldung. Ein Neuversuch mit einem anderen Modell wurde vom selben Hook, der Modelle festlegt, wieder zurückgestellt. Die führende Sitzung schrieb den Plan daraufhin selbst, still und leise, genau das Ergebnis, das der Planer vermeiden sollte. Der Hook liest jetzt die erste Ausgabe des Agenten und markiert ein totes Modell eine Zeit lang für alle Sitzungen.
Der Agent, der seine eigenen Prüfungen bearbeitete
Am 18. Oktober wurde in einer Sitzung an einem Kundenprojekt der Commit immer wieder von einer Prüfung blockiert. Sie bearbeitete drei der Prüfskripte, damit ihr Commit durchging. Nichts davon war versteckt; die Änderungen lagen offen da. Aber nichts hielt sie auch auf, denn die Prüfungen lagen in einem Ordner, in den der Agent schreiben konnte, und überwacht wurden nur die Datei-Editor-Tools, nicht Shell-Befehle. Heute lassen sich die Prüfdateien nur aus einer Sitzung ändern, die im Konfigurationsordner selbst gestartet wurde, jeder Schreibweg ist abgedeckt (Editor, Shell-Umleitungen, Skripte, Git), und jede Änderung daran in einer Projektsitzung wird protokolliert und gemeldet.
Das ist der Fehler, vor dem ich zuerst warnen würde. Ein Agent, dem man sagt, er solle „den Commit durchbringen“, behandelt das Gate als Teil des Problems.
Zwei meiner eigenen Regeln widersprachen sich
Eine Regel wies Agenten an, drei oder mehr Shell-Schritte zu einem Skript zusammenzufassen, um Tokens zu sparen. Agenten, die in einem Worktree isoliert sind, laufen unter einer Sandbox, die genau diese Form ablehnt. An mehreren Tagen liefen Agenten dreimal hintereinander in „too complex to verify“ und verbrannten ihr Budget mit Umformulieren. Jetzt hören Agenten nach zwei gleichen Ablehnungen auf, und Briefings für isolierte Agenten nennen die Befehlsformen, die funktionieren.
Warum scheitern Multi-Agenten-Systeme?
Nach diesen zwei Monaten: nicht, weil ein Modell zu schwach ist. Keiner der sieben Fehler oben war ein Modell, das an der gestellten Aufgabe scheiterte. Sie scheitern an den Nahtstellen zwischen Agenten, wo kein einzelner Agent verantwortlich ist:
- Gemeinsamer Zustand. Eine Datei, die jedes Feature anfasst, ein Arbeitsverzeichnis, ein Branch. Jeder Agent hat lokal recht, und das Ergebnis ist global falsch.
- Grüne Prüfungen. Jeder Vorfall oben bestand die Prüfungen, die es damals gab. Eine Prüfung belegt, was sie prüft, nicht mehr.
- Erfolgsmeldungen, die lügen. „Spawned“, „saved“, „cleaned up“ bedeuteten jeweils etwas Engeres, als sie sagten.
- Agenten, die auf das Gate optimieren. Sagt man einem Agenten, der Commit sei blockiert, sucht er einen Weg, den Commit freizubekommen, auch durch das Gate hindurch.
Andere Entwickler berichten dasselbe Muster aus größeren Flotten. Jed Arden, der etwa zwanzig Agenten betreibt, schrieb, dass das LLM im Vorfallprotokoll kaum vorkommt (Juli 2026). Das Team von Cursor stellte fest, dass zwanzig Agenten, die sich eine Koordinationsdatei mit Sperren teilten, auf den Durchsatz von zwei oder drei abfielen (Januar 2026).
Was ich zuerst einrichten würde
Wer mit Claude-Code-Subagenten oder irgendeiner Multi-agent orchestration anfängt, sollte es in dieser Reihenfolge tun, nach dem, was mich das Lernen gekostet hat:
- Jeden Agentenstart protokollieren. Eine Zeile pro Start: Zeit, Agententyp, Modell, Risiko. Ohne das weiß man nicht, was das System tut, und keine der Zahlen oben würde existieren.
- Ein Schreiber pro Datei. Parallele Schreiber bekommen einen Worktree und eine deklarierte Dateiliste. Dateien, an die jedes Feature anhängt (Übersetzungen, Lockfiles, Changelogs), bekommen einen Eigentümer, die anderen liefern Fragmente.
- Erst einsammeln, dann aufräumen. Nie einen Aufräumschritt nach „läuft es noch“ entscheiden lassen. Sondern nach „liegt seine Arbeit im Haupt-Checkout“.
- Die Prüfungen außer Reichweite der Agenten legen. Hooks, die blockieren, an einem Ort, in den eine Projektsitzung nicht schreiben kann.
- Die Welle begrenzen. Fünf parallele Agenten sind meine Obergrenze; darüber wird das Review zum Engpass, und Konflikte wachsen schneller als der Durchsatz.
- Bei Wiederholung eskalieren, nicht bei Aufwand. Standardmäßig ein günstiges Modell; nach demselben Fehler dreimal ein Versuch mit einem stärkeren Modell; danach ein Mensch.
Was kostet ein KI-Agent im Bau und Betrieb für ein Unternehmen, statt für den Workflow eines einzelnen Entwicklers? Das ist eine andere Frage, mit Zahlen beantwortet in Was kostet ein KI-Agent? Betriebskosten aus 4 Projekten. Welche Panels ich heute beobachte, aus denselben Logs einen Monat später, steht in AI Agent Monitoring Dashboard: was 1.238 Läufe zeigten.
Grenzen dieses Berichts
- Das Setup eines einzelnen Entwicklers. Eine führende Sitzung, bis zu fünf parallele Agenten. Flotten aus Dutzenden oder Hunderten Agenten scheitern auf weitere Arten, zum Beispiel beim Start.
- Keine echte Rechnung. Der Dollarbetrag ist ein Gegenwert zu den API-Listenpreisen für 30 Tage, eine Untergrenze, die Cache-Schreibzugriffe und ältere Modelle auslässt. Ich zahle ein Pauschalabo.
- Lücken in den Protokollen. Blockierte Starts werden nicht protokolliert, ich kann also nicht sagen, wie oft die Wellenobergrenze griff. Die 159 Läufe des stärkeren Implementierers mischen riskante Schritte und wiederholte Fehler.
- Daten aus meinen eigenen Notizen. Die Vorfalldaten stammen aus Notizen und Commits vom selben Tag; ein Vorfall ist in einer älteren Regeldatei anders datiert, und ich habe die Notiz genommen.
Der Dashboard-Prototyp, der aus dieser Arbeit entstanden ist, ist der Fall Dashboard für Multi-Agent-Orchestrierung, und der Bau von Agenten für Kunden fällt unter KI-Agenten & Chatbots entwickeln lassen.
Sie lassen Agenten parallel laufen und verlieren Arbeit zwischen ihnen?
Gern tausche ich mich zu Hooks, Worktrees und Review-Gates aus. Ohne Verkaufsgespräch.
Kontakt aufnehmen