TL;DR
J’ai extrait 30 jours de logs du dispositif d’agents avec lequel je travaille : 127 610 appels d’outils et 1 238 exécutions d’agents terminées. Trois constats ont décidé de ce qu’un tableau de bord de monitoring doit montrer. 59 % de toutes les erreurs d’outils étaient mes propres règles de garde qui refusaient quelque chose, et non une panne ; les erreurs demandent donc deux compteurs. Une seule limite de temps pour tous les agents est une erreur : 21 % de mes agents codeurs test-first ont dépassé 12 minutes, contre 0 % des explorateurs de code. Et 1 lancement d’agent sur 5 a été refusé avant de démarrer, ce qu’aucun graphique « exécutions par jour » ne montre.
Je suis Denys, ingénieur full-stack et IA. Je travaille avec une session de code principale qui confie le travail à des agents spécialisés : explorateurs, un planificateur, des codeurs test-first, des relecteurs sécurité et code. Dans Multi-agent orchestration : 3 315 lancements, ce qui a cassé, j’ai compté les pannes. Ici, pour l’AI agent monitoring, la question est autre : qu’est-ce qui mérite une place sur le tableau de bord ?
Données. Les logs de session et le registre de lancements de mon propre dispositif, du 24 septembre au 23 octobre 2026. Chaque chiffre ci-dessous en est calculé par un seul script ; aucun nom de client ou de projet ne figure dans les données utilisées. C’est la charge de travail d’une personne, pas un benchmark.
Que doit montrer un tableau de bord d’AI agent monitoring ?
Les guides des éditeurs, comme la documentation d’observabilité d’agents de Grafana, tournent autour de la latence, des tokens, du coût et des erreurs. Mes logs disent que ces quatre-là sont nécessaires mais insuffisants. Cinq panneaux :
- Lancements : démarrés, refusés, terminés, échoués, par jour.
- Erreurs séparées en « refusées par une règle » et « cassées », par outil.
- Durée et appels d’outils par type d’agent, en médiane et au 90e centile, avec une limite par type.
- Tokens par exécution, soit le coût.
- Ce qui tourne en ce moment, avec le temps écoulé de chaque exécution face à la plage normale de son type.
Le reste de l’article donne les chiffres derrière chacun.
Combien de lancements d’agents ne démarrent jamais ?
| Lancements, 30 jours | Nombre |
|---|---|
| Tentatives de lancement | 1 775 |
| Refusés avant de démarrer | 352 (19,8 %) |
| Jour le plus chargé | 258 lancements |
| Jour médian | 40 lancements |
Mon dispositif vérifie chaque lancement : si le brief nomme les fichiers que l’agent peut modifier, si un autre agent en cours détient déjà ces fichiers, quel modèle une étape risquée exige. Un lancement sur cinq n’a pas passé. Un graphique d’exécutions ne compte que les lancements qui ont démarré, et les cache donc tous.
Pourquoi les erreurs d’outils demandent-elles deux compteurs ?
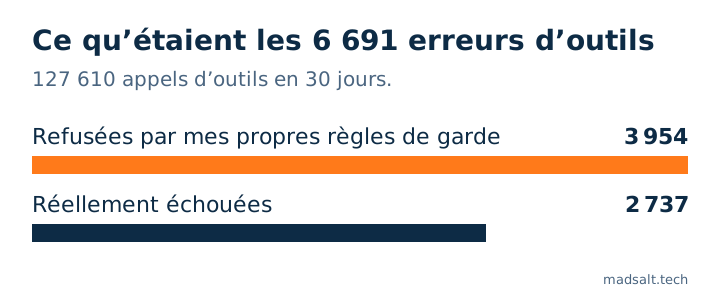
Sur 127 610 appels d’outils, 6 691 sont revenus en erreur : 52 pour 1 000 appels. Je les ai ensuite séparées selon ce que disait l’erreur :
| Outil | Appels | Erreurs | Dont refusées par une règle de garde |
|---|---|---|---|
| Shell | 50 960 | 4 985 | 2 970 |
| Modifier un fichier | 28 244 | 743 | 602 |
| Lire un fichier | 26 348 | 145 | 1 |
| Écrire un fichier | 8 238 | 208 | 195 |
| Lancer un agent | 1 719 | 287 | 132 |
| Recherche web | 2 527 | 57 | 0 |
3 954 des 6 691 erreurs, soit 59 %, étaient mes propres règles qui disaient non : une commande qui aurait sauté une vérification, une modification avant une consultation obligatoire, une écriture dans un fichier qui appartient à un autre agent. Si ce chiffre monte, les règles font leur travail ou un agent se bat contre elles. Les 2 737 autres sont de vraies défaillances : un test échoué, une commande plantée, une page qui ne chargeait pas. Sur un seul graphique, les deux se mélangent : une journée de nombreux refus ressemble à une mauvaise journée, alors que rien n’a cassé.
Une seule limite de temps convient-elle à tous les agents ?
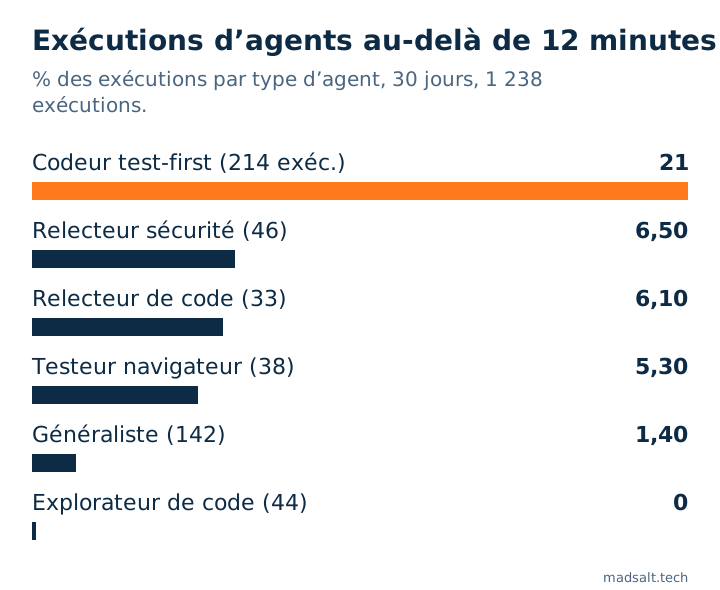
Non. J’arrête un subagent après 12 minutes ou 80 appels d’outils, et les logs montrent à quel point les types diffèrent :
| Type d’agent | Exécutions | Minutes médianes | 90e centile | Plus de 12 minutes | Plus de 80 appels d’outils |
|---|---|---|---|---|---|
| Codeur test-first | 214 | 6,8 | 17,1 | 45 (21 %) | 66 (31 %) |
| Relecteur sécurité | 46 | 5,0 | 10,9 | 3 (6,5 %) | 2 |
| Relecteur de code | 33 | 4,8 | 10,2 | 2 (6,1 %) | 3 |
| Testeur navigateur | 38 | 4,3 | 10,5 | 2 (5,3 %) | 2 |
| Généraliste | 142 | 3,1 | 6,5 | 2 (1,4 %) | 8 |
| Architecte | 72 | 5,2 | 8,5 | 0 | 4 |
| Explorateur de code | 44 | 1,9 | 3,4 | 0 | 0 |
| Les 1 238 exécutions | 4,0 | 11,8 | 72 (5,8 %) | 98 (7,9 %) |
Un agent de code qui écrit un test, le lance, corrige le code et le relance a besoin de plus de temps et de plus d’appels qu’un agent qui lit des fichiers. Avec une seule limite, le codeur est coupé une fois sur cinq, et l’explorateur pourrait rester bloqué six fois sa durée normale avant que quiconque le remarque. Le panneau que je construirais montre le 90e centile de chaque type et signale un agent en cours qui dépasse le sien, pas un chiffre global. Avant d’en arrêter un, je lis sa dernière action enregistrée : un agent à 15 minutes d’un long test travaille, un agent dont la dernière action date de 10 minutes est bloqué.
Combien coûte une exécution en tokens ?
Une exécution médiane a utilisé 125 828 tokens et le 90e centile 211 884, en comptant tout ce que l’agent a lu et écrit. Les explorateurs étaient plus bas (médiane de 86 389), les agents généralistes plus haut (141 495). Les prix changent trop souvent pour être imprimés ; le tableau de bord doit donc stocker les tokens par exécution et par modèle, et appliquer la grille de prix actuelle au moment de tracer le coût. Ce que coûte le même travail sur différents modèles est dans Prix d’un agent IA : les coûts réels de 4 projets.
Sur les 1 775 lancements, 883 sont allés au modèle de taille moyenne, 827 au plus grand, 33 au dernier modèle haut de gamme et 32 à d’autres ; 54 % des agents avaient le droit de modifier des fichiers.
Les exécutions terminées ont-elles vraiment réussi ?
Sur 1 238 exécutions qui ont rendu compte, 1 172 se sont terminées, 64 ont échoué et 2 ont été arrêtées. Ces 94,7 % disent que l’agent a fini, pas que son travail était juste. Dans mon dispositif, chaque modification de code passe encore par un relecteur sécurité et un relecteur de code, qui peuvent la renvoyer ; rien de cela n’est visible dans le statut d’une exécution. Un tableau de bord peut montrer qu’une exécution s’est terminée. Savoir si le résultat est correct demande un second agent, un test ou une personne.
Quels outils existent pour cela ?
Pour une application en production où des agents parlent à des clients, des outils de traçage hébergés comme Langfuse, LangSmith, Datadog ou les vues d’agents de Grafana couvrent la latence, les tokens et les traces, et certains peuvent noter les sorties. Pour plusieurs agents de code sur une machine, il existe des tableaux de bord open source qui lisent les événements de hook des agents dans une base locale. Mes propres chiffres viennent des logs que le dispositif écrit de toute façon : un registre de lancements, une ligne par lancement, et les transcriptions de session. Pour un seul développeur, cela suffisait, et un script sur ces deux fichiers a produit chaque tableau ici.
À quoi peut ressembler une vue d’orchestration complète, avec carte des agents, constructeur de workflows et graphiques de coût, c’est dans mon prototype Dashboard d’orchestration multi-agents.
Limites. Un développeur, un dispositif, 30 jours. « Refusée par une règle de garde » est repérée par le texte de l’erreur ; quelques erreurs peuvent donc être comptées du mauvais côté. La durée et le nombre d’appels viennent d’agents exécutés en arrière-plan qui ont rendu compte ; les agents au premier plan ne figurent pas dans le tableau des durées. Les échecs n’ont pas pu être attribués de façon fiable aux types d’agents, ils ne sont donc donnés qu’en total.
Des agents en production ?
Je compare volontiers nos façons de faire pour savoir quoi mesurer. Sans démarchage.
Me contacter