TL;DR
Stiahol som 30 dní logov z nastavenia agentov, s ktorým pracujem: 127 610 volaní nástrojov a 1 238 dokončených behov agentov. O tom, čo má monitorovací dashboard ukazovať, rozhodli tri veci. 59 % všetkých chýb nástrojov tvorili moje vlastné ochranné pravidlá, ktoré niečo odmietli, nie nič, čo by sa pokazilo, takže chyby potrebujú dva čítače. Jeden časový limit pre všetkých agentov je zlý: 21 % mojich implementátorov píšucich testy najprv prekročilo 12 minút, oproti 0 % pri prieskumníkoch kódu. A 1 z 5 spustení agenta bolo odmietnuté skôr, než sa začalo, čo žiadny graf „behov za deň“ neukáže.
Som Denys, full-stack a AI inžinier. Staviam s jednou hlavnou programátorskou reláciou, ktorá odovzdáva prácu špecializovaným agentom: prieskumníkom, plánovačovi, implementátorom píšucim testy najprv, bezpečnostným a kódovým revízorom. V článku Multi-agent orchestration: čo sa pokazilo v 3 315 behoch som počítal zlyhania. Tento sa pýta na niečo iné: čo patrí na AI agent monitoring dashboard?
Dáta. Logy relácií a evidencia spustení môjho vlastného nastavenia, 24. septembra až 23. októbra 2026. Každé číslo nižšie z nich vypočítal jeden skript; mená klientov a projektov v dátach, ktoré som použil, nie sú. Je to záťaž jednej osoby, nie benchmark.
Čo má ukazovať AI agent monitoring dashboard?
Návody dodávateľov, napríklad dokumentácia Grafany k observabilite agentov, sa sústreďujú na latenciu, tokeny, náklady a chyby. Moje logy hovoria, že týchto štyroch je nutných, ale nestačí. Päť panelov:
- Spustenia: začaté, odmietnuté, dokončené, zlyhané, po dňoch.
- Chyby rozdelené na „odmietnuté pravidlom“ a „pokazilo sa“, po nástrojoch.
- Trvanie a počet volaní nástrojov podľa typu agenta, ako medián a 90. percentil, s limitom pre každý typ.
- Tokeny na beh, teda náklady.
- Čo beží práve teraz, s uplynutým časom každého behu voči obvyklému rozsahu jeho typu.
Zvyšok článku sú čísla za každým z nich.
Koľko spustení agentov sa nikdy nezačne?
| Spustenia, 30 dní | Počet |
|---|---|
| Pokusov o spustenie | 1 775 |
| Odmietnuté pred štartom | 352 (19,8 %) |
| Najvyťaženejší deň | 258 spustení |
| Medián dňa | 40 spustení |
Moje nastavenie kontroluje každé spustenie: či zadanie uvádza súbory, ktoré smie agent meniť, či tieto súbory už nedrží iný bežiaci agent, aký model vyžaduje rizikový krok. Jedno spustenie z piatich neprešlo. Graf behov počíta len spustenia, ktoré sa začali, takže všetky tieto skrýva.
Prečo chyby nástrojov potrebujú dva čítače?
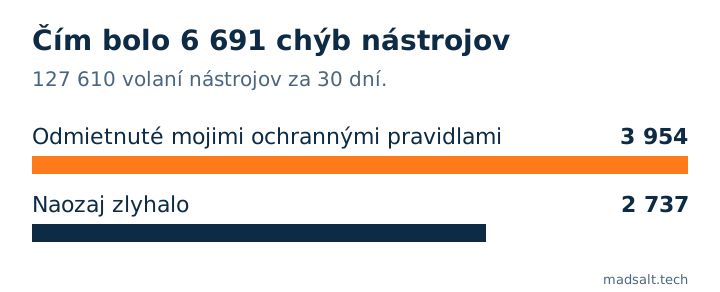
Zo 127 610 volaní nástrojov sa 6 691 vrátilo ako chyba: 52 na 1 000 volaní. Potom som ich rozdelil podľa toho, čo chyba hovorila:
| Nástroj | Volaní | Chýb | Z toho odmietnuté ochranným pravidlom |
|---|---|---|---|
| Shell | 50 960 | 4 985 | 2 970 |
| Úprava súboru | 28 244 | 743 | 602 |
| Čítanie súboru | 26 348 | 145 | 1 |
| Zápis súboru | 8 238 | 208 | 195 |
| Spustenie agenta | 1 719 | 287 | 132 |
| Webové vyhľadávanie | 2 527 | 57 | 0 |
3 954 zo 6 691 chýb, teda 59 %, boli moje vlastné pravidlá, ktoré povedali nie: príkaz, ktorý by preskočil kontrolu, úprava pred povinným dohľadaním, zápis do súboru, ktorý vlastní iný agent. Keď toto číslo rastie, pravidlá robia svoju prácu, alebo s nimi agent bojuje. Zvyšných 2 737 sú skutočné zlyhania: test, ktorý neprešiel, príkaz, ktorý spadol, stránka, ktorá sa nenačítala. Na jednom grafe sa oboje zmieša: deň s mnohými odmietnutiami vyzerá ako zlý deň, hoci sa nič nepokazilo.
Je jeden časový limit správny pre všetkých agentov?
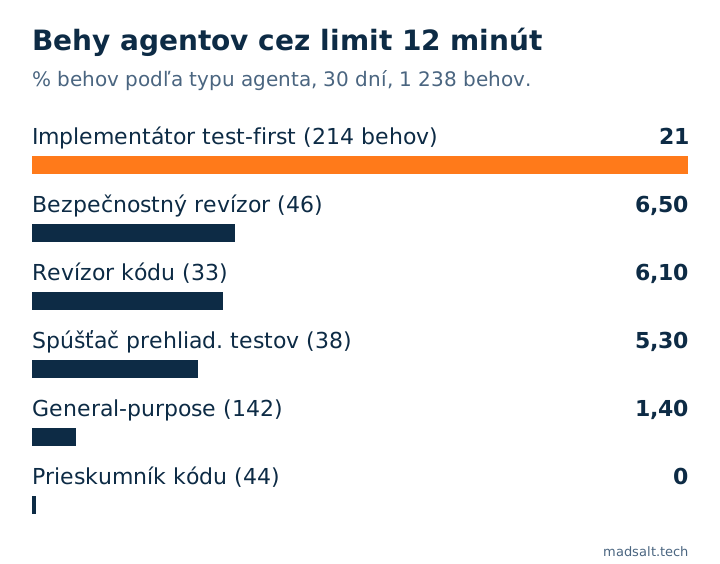
Nie. Subagenta zastavujem po 12 minútach alebo 80 volaniach nástrojov a logy ukazujú, ako veľmi sa typy líšia:
| Typ agenta | Behov | Medián minút | 90. percentil | Cez 12 minút | Cez 80 volaní nástrojov |
|---|---|---|---|---|---|
| Implementátor (test-first) | 214 | 6,8 | 17,1 | 45 (21 %) | 66 (31 %) |
| Bezpečnostný revízor | 46 | 5,0 | 10,9 | 3 (6,5 %) | 2 |
| Revízor kódu | 33 | 4,8 | 10,2 | 2 (6,1 %) | 3 |
| Spúšťač prehliadačových testov | 38 | 4,3 | 10,5 | 2 (5,3 %) | 2 |
| General-purpose | 142 | 3,1 | 6,5 | 2 (1,4 %) | 8 |
| Architekt | 72 | 5,2 | 8,5 | 0 | 4 |
| Prieskumník kódu | 44 | 1,9 | 3,4 | 0 | 0 |
| Všetkých 1 238 behov | 4,0 | 11,8 | 72 (5,8 %) | 98 (7,9 %) |
Agent, ktorý napíše test, spustí ho, opraví kód a spustí ho znova, potrebuje viac času a viac volaní než ten, ktorý číta súbory. S jedným limitom je implementátor useknutý pätinu času a prieskumník by mohol visieť šesťkrát dlhšie, než je u neho obvyklé, kým si niečo všimne. Panel, ktorý by som postavil, ukazuje 90. percentil každého typu a označí bežiaceho agenta, ktorý prekročí ten svoj, nie globálne číslo. Skôr než jedného zastavím, prečítam si jeho poslednú zaznamenanú akciu: agent, ktorý je 15 minút v dlhom behu testov, pracuje, ten, ktorého posledná akcia bola pred 10 minútami, uviazol.
Koľko tokenov stojí jeden beh?
Mediánový beh spotreboval 125 828 tokenov a 90. percentil 211 884, vrátane všetkého, čo agent prečítal a napísal. Prieskumníci boli nižšie (medián 86 389), agenti general-purpose vyššie (141 495). Ceny sa menia príliš často na to, aby som ich tlačil, takže dashboard má ukladať tokeny na beh a model a pri kreslení nákladov použiť aktuálny cenník. Koľko rovnaká práca stojí na rôznych modeloch, je v článku Koľko stojí AI agent? Prevádzka podľa 4 projektov.
Z 1 775 spustení išlo 883 na stredne veľký model, 827 na najväčší, 33 na najnovší špičkový model a 32 na iné; 54 % agentov smelo meniť súbory.
Uspeli behy, ktoré skončili, naozaj?
Z 1 238 behov, ktoré sa ohlásili, ich 1 172 dokončilo, 64 zlyhalo a 2 boli zastavené. Tých 94,7 % hovorí, že agent skončil, nie že jeho práca bola správna. V mojom nastavení každá zmena kódu stále prechádza bezpečnostným a kódovým revízorom, ktorí ju môžu vrátiť; nič z toho nie je vidieť v stave behu. Dashboard vie ukázať, že beh skončil. Či je výsledok správny, vyžaduje druhého agenta, test alebo človeka.
Aké nástroje na to existujú?
Pre produkčnú aplikáciu s agentmi komunikujúcimi so zákazníkmi pokrývajú hostované tracingové nástroje, ako Langfuse, LangSmith, Datadog alebo pohľady na agentov v Grafane, latenciu, tokeny a trasy a niektoré z nich vedia hodnotiť výstupy. Pre niekoľko programátorských agentov na jednom stroji existujú open-source dashboardy, ktoré čítajú udalosti hookov agentov do lokálnej databázy. Moje vlastné čísla pochádzajú z logov, ktoré nastavenie aj tak zapisuje: z evidencie spustení, jeden riadok na spustenie, a z prepisov relácií. Pre jedného vývojára to stačilo a skript nad týmito dvoma súbormi vytvoril každú tabuľku tu.
Ako môže vyzerať celý pohľad na orchestráciu, s mapou agentov, nástrojom na tvorbu workflow a grafmi nákladov, je v mojom prototype Dashboard na orchestráciu agentov.
Limity. Jeden vývojár, jedno nastavenie, 30 dní. „Odmietnuté ochranným pravidlom“ sa určuje z textu chyby, takže niekoľko chýb môže byť započítaných na zlú stranu. Trvanie a počty nástrojov pochádzajú od agentov, ktorí bežali na pozadí a ohlásili sa; agenti z popredia v tabuľke trvaní nie sú. Zlyhania sa nepodarilo spoľahlivo priradiť k typom agentov, preto sú uvedené len ako súčet.