TL;DR
Stáhl jsem 30 dní logů z nastavení agentů, se kterým pracuji: 127 610 volání nástrojů a 1 238 dokončených běhů agentů. O tom, co má monitorovací dashboard ukazovat, rozhodly tři věci. 59 % všech chyb nástrojů tvořila moje vlastní ochranná pravidla, která něco odmítla, ne nic, co by se rozbilo, takže chyby potřebují dva čítače. Jeden časový limit pro všechny agenty je špatně: 21 % mých implementátorů píšících testy napřed přesáhlo 12 minut, oproti 0 % u průzkumníků kódu. A 1 z 5 spuštění agenta byl odmítnut dřív, než začal, což žádný graf „běhů za den“ neukáže.
Jsem Denys, full-stack a AI inženýr. Stavím s jednou hlavní programátorskou relací, která předává práci specializovaným agentům: průzkumníkům, plánovači, implementátorům píšícím testy napřed, bezpečnostním a kódovým revizorům. V článku Multi-agent orchestration: co se rozbilo za 3 315 běhů jsem počítal selhání. Tento se ptá na něco jiného: co patří na AI agent monitoring dashboard?
Data. Logy relací a evidence spuštění mého vlastního nastavení, 24. září až 23. října 2026. Každé číslo níže z nich spočítal jeden skript; jména klientů a projektů v datech, která jsem použil, nejsou. Je to zátěž jedné osoby, ne benchmark.
Co má ukazovat AI agent monitoring dashboard?
Návody dodavatelů, například dokumentace Grafany k observabilitě agentů, se soustředí na latenci, tokeny, náklady a chyby. Moje logy říkají, že těchto čtyř je nutných, ale nestačí. Pět panelů:
- Spuštění: zahájená, odmítnutá, dokončená, selhaná, po dnech.
- Chyby rozdělené na „odmítnuto pravidlem“ a „rozbilo se“, po nástrojích.
- Doba trvání a počet volání nástrojů podle typu agenta, jako medián a 90. percentil, s limitem pro každý typ.
- Tokeny na běh, tedy náklady.
- Co běží právě teď, s uplynulým časem každého běhu proti obvyklému rozsahu jeho typu.
Zbytek článku jsou čísla za každým z nich.
Kolik spuštění agentů se nikdy nezačne?
| Spuštění, 30 dní | Počet |
|---|---|
| Pokusů o spuštění | 1 775 |
| Odmítnuto před startem | 352 (19,8 %) |
| Nejvytíženější den | 258 spuštění |
| Medián dne | 40 spuštění |
Moje nastavení kontroluje každé spuštění: zda zadání uvádí soubory, které smí agent měnit, zda tyto soubory už nedrží jiný běžící agent, jaký model vyžaduje rizikový krok. Jedno spuštění z pěti neprošlo. Graf běhů počítá jen spuštění, která začala, takže všechna tato skrývá.
Proč chyby nástrojů potřebují dva čítače?
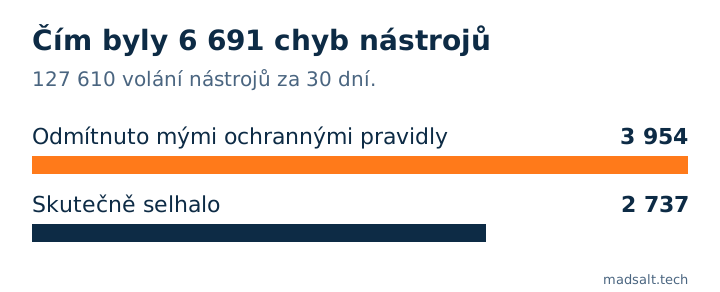
Ze 127 610 volání nástrojů se 6 691 vrátilo jako chyba: 52 na 1 000 volání. Pak jsem je rozdělil podle toho, co chyba říkala:
| Nástroj | Volání | Chyb | Z toho odmítnuto ochranným pravidlem |
|---|---|---|---|
| Shell | 50 960 | 4 985 | 2 970 |
| Úprava souboru | 28 244 | 743 | 602 |
| Čtení souboru | 26 348 | 145 | 1 |
| Zápis souboru | 8 238 | 208 | 195 |
| Spuštění agenta | 1 719 | 287 | 132 |
| Webové vyhledávání | 2 527 | 57 | 0 |
3 954 ze 6 691 chyb, tedy 59 %, byla moje vlastní pravidla, která řekla ne: příkaz, který by přeskočil kontrolu, úprava před povinným dohledáním, zápis do souboru, který vlastní jiný agent. Když toto číslo roste, pravidla dělají svou práci, nebo s nimi agent bojuje. Zbylých 2 737 jsou skutečná selhání: test, který neprošel, příkaz, který spadl, stránka, která se nenačetla. Na jednom grafu se obojí smíchá: den s mnoha odmítnutími vypadá jako špatný den, ačkoli se nic nerozbilo.
Je jeden časový limit správný pro všechny agenty?
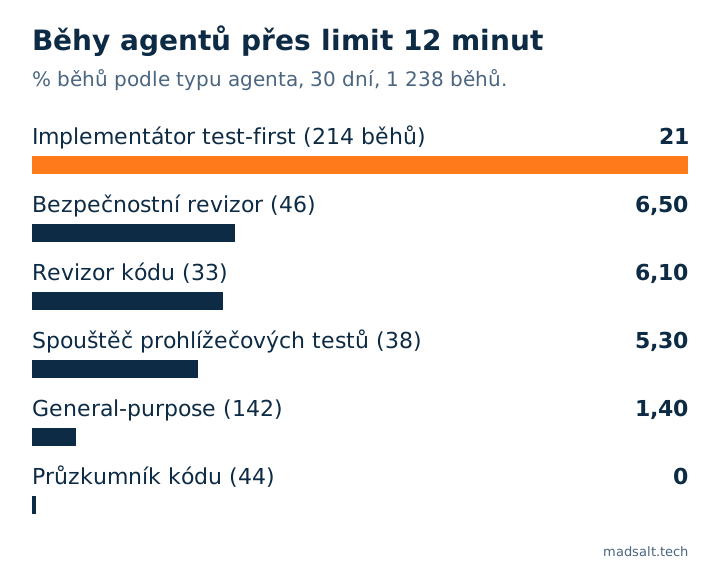
Ne. Subagenta zastavuji po 12 minutách nebo 80 voláních nástrojů a logy ukazují, jak moc se typy liší:
| Typ agenta | Běhů | Medián minut | 90. percentil | Přes 12 minut | Přes 80 volání nástrojů |
|---|---|---|---|---|---|
| Implementátor (test-first) | 214 | 6,8 | 17,1 | 45 (21 %) | 66 (31 %) |
| Bezpečnostní revizor | 46 | 5,0 | 10,9 | 3 (6,5 %) | 2 |
| Revizor kódu | 33 | 4,8 | 10,2 | 2 (6,1 %) | 3 |
| Spouštěč prohlížečových testů | 38 | 4,3 | 10,5 | 2 (5,3 %) | 2 |
| General-purpose | 142 | 3,1 | 6,5 | 2 (1,4 %) | 8 |
| Architekt | 72 | 5,2 | 8,5 | 0 | 4 |
| Průzkumník kódu | 44 | 1,9 | 3,4 | 0 | 0 |
| Všech 1 238 běhů | 4,0 | 11,8 | 72 (5,8 %) | 98 (7,9 %) |
Agent, který napíše test, spustí ho, opraví kód a spustí ho znovu, potřebuje víc času a víc volání než ten, který čte soubory. S jedním limitem je implementátor useknut pětinu času a průzkumník by mohl viset šestkrát déle, než je u něj obvyklé, než si toho něco všimne. Panel, který bych postavil, ukazuje 90. percentil každého typu a označí běžícího agenta, který překročí ten svůj, ne globální číslo. Než jednoho zastavím, přečtu si jeho poslední zaznamenanou akci: agent, který je 15 minut v dlouhém běhu testů, pracuje, ten, jehož poslední akce byla před 10 minutami, uvázl.
Kolik tokenů stojí jeden běh?
Mediánový běh spotřeboval 125 828 tokenů a 90. percentil 211 884, včetně všeho, co agent přečetl a napsal. Průzkumníci byli níž (medián 86 389), agenti general-purpose výš (141 495). Ceny se mění příliš často na to, abych je tiskl, takže dashboard má ukládat tokeny na běh a model a při kreslení nákladů použít aktuální ceník. Kolik stejná práce stojí na různých modelech, je v článku Kolik stojí AI agent a jeho provoz? Čísla ze 4 projektů.
Z 1 775 spuštění šlo 883 na středně velký model, 827 na největší, 33 na nejnovější špičkový model a 32 na jiné; 54 % agentů smělo měnit soubory.
Uspěly běhy, které skončily, doopravdy?
Z 1 238 běhů, které se ohlásily, jich 1 172 dokončilo, 64 selhalo a 2 byly zastaveny. Těch 94,7 % říká, že agent skončil, ne že jeho práce byla správná. V mém nastavení každá změna kódu stále prochází bezpečnostním a kódovým revizorem, kteří ji mohou vrátit; nic z toho není vidět ve stavu běhu. Dashboard umí ukázat, že běh skončil. Zda je výsledek správný, vyžaduje druhého agenta, test nebo člověka.
Jaké nástroje na to existují?
Pro produkční aplikaci s agenty komunikujícími se zákazníky pokrývají hostované tracingové nástroje, jako Langfuse, LangSmith, Datadog nebo pohledy na agenty v Grafaně, latenci, tokeny a trasy a některé z nich umí hodnotit výstupy. Pro několik programátorských agentů na jednom stroji existují open-source dashboardy, které čtou události hooků agentů do lokální databáze. Moje vlastní čísla pocházejí z logů, které nastavení stejně zapisuje: z evidence spuštění, jeden řádek na spuštění, a z přepisů relací. Pro jednoho vývojáře to stačilo a skript nad těmito dvěma soubory vytvořil každou tabulku zde.
Jak může vypadat celý pohled na orchestraci, s mapou agentů, nástrojem na tvorbu workflow a grafy nákladů, je v mém prototypu Dashboard pro orchestraci agentů.
Limity. Jeden vývojář, jedno nastavení, 30 dní. „Odmítnuto ochranným pravidlem“ se určuje z textu chyby, takže několik chyb může být započítáno na špatnou stranu. Doba trvání a počty nástrojů pocházejí od agentů, kteří běželi na pozadí a ohlásili se; agenti z popředí v tabulce dob nejsou. Selhání se nepodařilo spolehlivě přiřadit k typům agentů, proto jsou uvedena jen jako součet.