TL;DR
Jeg hentet 30 dagers logger fra agentoppsettet jeg bygger med: 127 610 verktøykall og 1 238 ferdige agentkjøringer. Tre ting avgjorde hva et overvåkingsdashboard bør vise. 59 % av alle verktøyfeil var mine egne beskyttelsesregler som avviste noe, ikke noe som gikk i stykker; feil trenger derfor to tellere. Én tidsgrense for alle agenter er feil: 21 % av test-first-kodeagentene mine kjørte over 12 minutter, mot 0 % av kodeutforskerne. Og 1 av 5 agentstarter ble avvist før den begynte, noe ingen graf over «kjøringer per dag» viser.
Jeg heter Denys og er full-stack- og AI-utvikler. Jeg bygger med én ledende kodeøkt som gir arbeid videre til spesialiserte agenter: utforskere, en planlegger, test-first-kodere, sikkerhets- og kodegranskere. I Multi-agent orchestration: det som sviktet i 3 315 kjøringer talte jeg feilene. Her er spørsmålet et annet, sett som AI agent monitoring: hva hører hjemme på dashboardet?
Data. Øktlogger og startjournalen fra mitt eget oppsett, 24. september til 23. oktober 2026. Hvert tall under er regnet ut fra dem med ett skript; kunde- og prosjektnavn er ikke i dataene jeg brukte. Det er én persons arbeidsmengde, ikke en benchmark.
Hva bør et AI agent monitoring dashboard vise?
Leverandørguider, som Grafanas dokumentasjon om agent-observerbarhet, dreier seg om ventetid, tokens, kostnad og feil. Loggene mine sier at de fire er nødvendige, men ikke nok. Fem paneler:
- Starter: påbegynt, avvist, ferdig, mislykket, per dag.
- Feil delt i «avvist av en regel» og «gikk i stykker», per verktøy.
- Varighet og verktøykall per agenttype, som median og 90. persentil, med en grense per type.
- Tokens per kjøring, altså kostnaden.
- Hva som kjører nå, med hver kjørings forløpte tid mot det normale spennet for typen.
Resten av artikkelen er tallene bak hvert av dem.
Hvor mange agentstarter begynner aldri?
| Starter, 30 dager | Antall |
|---|---|
| Startforsøk | 1 775 |
| Avvist før start | 352 (19,8 %) |
| Travleste dag | 258 starter |
| Mediandag | 40 starter |
Oppsettet mitt sjekker hver start: om oppdraget nevner filene agenten får endre, om en annen kjørende agent allerede holder dem, hvilken modell et risikabelt steg krever. Én start av fem besto ikke. En graf over kjøringer teller bare startene som begynte, og skjuler dermed alle disse.
Hvorfor trenger verktøyfeil to tellere?
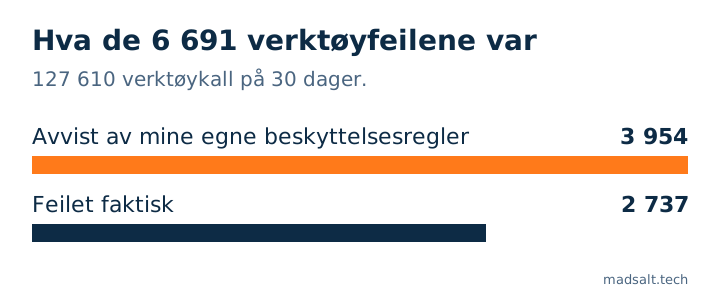
Av 127 610 verktøykall kom 6 691 tilbake som feil: 52 per 1 000 kall. Så delte jeg dem etter hva feilen sa:
| Verktøy | Kall | Feil | Av dem avvist av en beskyttelsesregel |
|---|---|---|---|
| Shell | 50 960 | 4 985 | 2 970 |
| Rediger fil | 28 244 | 743 | 602 |
| Les fil | 26 348 | 145 | 1 |
| Skriv fil | 8 238 | 208 | 195 |
| Start agent | 1 719 | 287 | 132 |
| Nettsøk | 2 527 | 57 | 0 |
3 954 av de 6 691 feilene, 59 %, var mine egne regler som sa nei: en kommando som ville ha hoppet over en sjekk, en redigering før et påkrevd oppslag, en skriving til en fil en annen agent eier. Stiger tallet, gjør reglene jobben sin, eller en agent kjemper mot dem. De øvrige 2 737 er ekte feil: en test som feilet, en kommando som krasjet, en side som ikke ville laste. På én graf blandes de to: en dag med mange avvisninger ser ut som en dårlig dag, selv om ingenting gikk i stykker.
Passer én tidsgrense for alle agenter?
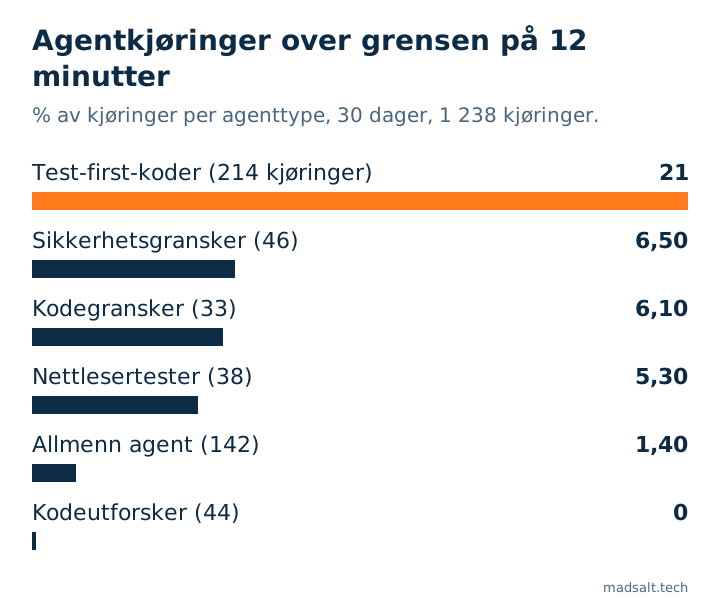
Nei. Jeg stopper en subagent etter 12 minutter eller 80 verktøykall, og loggene viser hvor ulike typene er:
| Agenttype | Kjøringer | Median (min) | 90. persentil | Over 12 minutter | Over 80 verktøykall |
|---|---|---|---|---|---|
| Test-first-koder | 214 | 6,8 | 17,1 | 45 (21 %) | 66 (31 %) |
| Sikkerhetsgransker | 46 | 5,0 | 10,9 | 3 (6,5 %) | 2 |
| Kodegransker | 33 | 4,8 | 10,2 | 2 (6,1 %) | 3 |
| Nettlesertester | 38 | 4,3 | 10,5 | 2 (5,3 %) | 2 |
| Allmenn agent | 142 | 3,1 | 6,5 | 2 (1,4 %) | 8 |
| Arkitekt | 72 | 5,2 | 8,5 | 0 | 4 |
| Kodeutforsker | 44 | 1,9 | 3,4 | 0 | 0 |
| Alle 1 238 kjøringer | 4,0 | 11,8 | 72 (5,8 %) | 98 (7,9 %) |
En kodeagent som skriver en test, kjører den, retter kode og kjører den igjen, trenger mer tid og flere kall enn en som leser filer. Med én grense blir koderen avbrutt en femtedel av gangene, og utforskeren kunne henge seks ganger sin normale lengde før noen merker det. Panelet jeg ville bygge, viser hver types 90. persentil og flagger en kjørende agent som passerer sin egen, ikke et globalt tall. Før jeg stopper en, leser jeg dens siste loggførte handling: en agent 15 minutter inne i en lang testkjøring jobber, en hvis siste handling var for 10 minutter siden, sitter fast.
Hva koster en kjøring i tokens?
En median-kjøring brukte 125 828 tokens og 90. persentil 211 884, der alt agenten leste og skrev er talt med. Utforskere lå lavere (median 86 389), allmenne agenter høyere (141 495). Priser endrer seg for ofte til å trykkes; dashboardet bør derfor lagre tokens per kjøring og modell og bruke gjeldende prisliste når det tegner kostnaden. Hva det samme arbeidet koster på ulike modeller, står i Hva koster en AI-agent? Tall fra 4 prosjekter.
Av de 1 775 startene gikk 883 til den mellomstore modellen, 827 til den største, 33 til den nyeste toppmodellen og 32 til andre; 54 % av agentene fikk endre filer.
Lyktes kjøringene som ble ferdige faktisk?
Av 1 238 kjøringer som meldte tilbake, ble 1 172 fullført, 64 feilet og 2 ble stoppet. De 94,7 % sier at agenten ble ferdig, ikke at arbeidet var riktig. I oppsettet mitt går hver kodeendring fortsatt gjennom en sikkerhetsgransker og en kodegransker, som kan sende den tilbake; ingenting av det synes i en kjørings status. Et dashboard kan vise at en kjøring tok slutt. Om resultatet er riktig, krever en annen agent, en test eller et menneske.
Hvilke verktøy finnes for dette?
For en produksjonsapp der agenter snakker med kunder, dekker hostede sporingsverktøy som Langfuse, LangSmith, Datadog eller Grafanas agentvisninger ventetid, tokens og spor, og noen kan vurdere output. For flere kodeagenter på én maskin finnes open source-dashboards som leser agentenes hook-hendelser inn i en lokal database. Mine egne tall kommer fra loggene oppsettet skriver uansett: en startjournal, én linje per start, og øktutskriftene. For én enkelt utvikler var det nok, og et skript over de to filene ga hver tabell her.
Hvordan en full orkestreringsvisning kan se ut, med agentkart, workflow-bygger og kostnadsgrafer, står i prototypen min Dashboard for multiagentorkestrering.
Begrensninger. Én utvikler, ett oppsett, 30 dager. «Avvist av en beskyttelsesregel» gjenkjennes på feilteksten, så noen feil kan være talt på feil side. Varighet og antall kall kommer fra agenter som kjørte i bakgrunnen og meldte tilbake; agenter i forgrunnen er ikke med i varighetstabellen. Feil kunne ikke pålitelig knyttes til agenttyper og oppgis derfor bare som en sum.
Kjører du agenter i produksjon?
Utveksler gjerne erfaringer om hva du bør måle. Ingen salgstale.
Ta kontakt