TL;DR
Ho estratto 30 giorni di log dal sistema di agenti con cui lavoro: 127.610 chiamate a strumenti e 1.238 esecuzioni di agenti concluse. Tre cose hanno deciso cosa dovrebbe mostrare una dashboard di monitoraggio. Il 59% di tutti gli errori degli strumenti erano le mie stesse regole di guardia che rifiutavano qualcosa, non qualcosa che si rompeva; gli errori hanno quindi bisogno di due contatori. Un solo limite di tempo per tutti gli agenti è sbagliato: il 21% dei miei agenti di codice test-first ha superato i 12 minuti, contro lo 0% degli esploratori di codice. E 1 avvio di agente su 5 è stato rifiutato prima di partire, cosa che nessun grafico “esecuzioni al giorno” mostra.
Sono Denys, ingegnere full-stack e AI. Lavoro con una sessione di codice principale che affida il lavoro ad agenti specializzati: esploratori, un pianificatore, coder test-first, revisori di sicurezza e di codice. In Multi-agent orchestration: cosa si è rotto in 3.315 avvii ho contato i guasti. Qui, per l’AI agent monitoring, la domanda è un’altra: cosa merita un posto nella dashboard?
Dati. I log di sessione e il registro degli avvii del mio sistema, dal 24 settembre al 23 ottobre 2026. Ogni numero qui sotto è calcolato da essi con un unico script; nei dati che ho usato non ci sono nomi di clienti o progetti. È il carico di lavoro di una persona, non un benchmark.
Cosa dovrebbe mostrare una dashboard di AI agent monitoring?
Le guide dei fornitori, come la documentazione di Grafana sull’osservabilità degli agenti, ruotano attorno a latenza, token, costo ed errori. I miei log dicono che questi quattro sono necessari ma non bastano. Cinque pannelli:
- Avvii: partiti, rifiutati, conclusi, falliti, al giorno.
- Errori divisi in “rifiutati da una regola” e “rotti”, per strumento.
- Durata e chiamate a strumenti per tipo di agente, come mediana e 90° percentile, con un limite per tipo.
- Token per esecuzione, cioè il costo.
- Cosa è in corso adesso, con il tempo trascorso di ogni esecuzione rispetto all’intervallo normale del suo tipo.
Il resto dell’articolo sono i numeri dietro ciascuno.
Quanti avvii di agenti non partono mai?
| Avvii, 30 giorni | Numero |
|---|---|
| Tentativi di avvio | 1.775 |
| Rifiutati prima di partire | 352 (19,8%) |
| Giorno più intenso | 258 avvii |
| Giorno mediano | 40 avvii |
Il mio sistema controlla ogni avvio: se il brief indica i file che l’agente può modificare, se un altro agente in corso detiene già quei file, quale modello richiede un passo rischioso. Un avvio su cinque non è passato. Un grafico delle esecuzioni conta solo gli avvii partiti, quindi li nasconde tutti.
Perché gli errori degli strumenti hanno bisogno di due contatori?
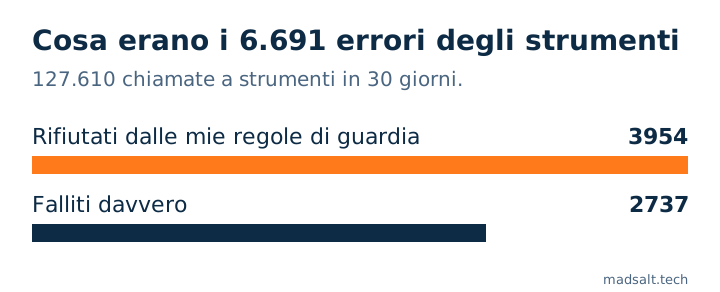
Su 127.610 chiamate a strumenti, 6.691 sono tornate come errori: 52 ogni 1.000 chiamate. Poi li ho divisi in base a ciò che diceva l’errore:
| Strumento | Chiamate | Errori | Di cui rifiutati da una regola di guardia |
|---|---|---|---|
| Shell | 50.960 | 4.985 | 2.970 |
| Modifica file | 28.244 | 743 | 602 |
| Leggi file | 26.348 | 145 | 1 |
| Scrivi file | 8.238 | 208 | 195 |
| Avvia agente | 1.719 | 287 | 132 |
| Ricerca web | 2.527 | 57 | 0 |
3.954 dei 6.691 errori, il 59%, erano le mie stesse regole che dicevano no: un comando che avrebbe saltato un controllo, una modifica prima di una consultazione obbligatoria, una scrittura su un file di un altro agente. Se questo numero sale, le regole fanno il loro lavoro o un agente lotta contro di esse. Gli altri 2.737 sono guasti veri: un test fallito, un comando andato in crash, una pagina che non si caricava. In un solo grafico i due si mescolano: un giorno con molti rifiuti sembra un brutto giorno, mentre non si è rotto nulla.
Un solo limite di tempo va bene per ogni agente?
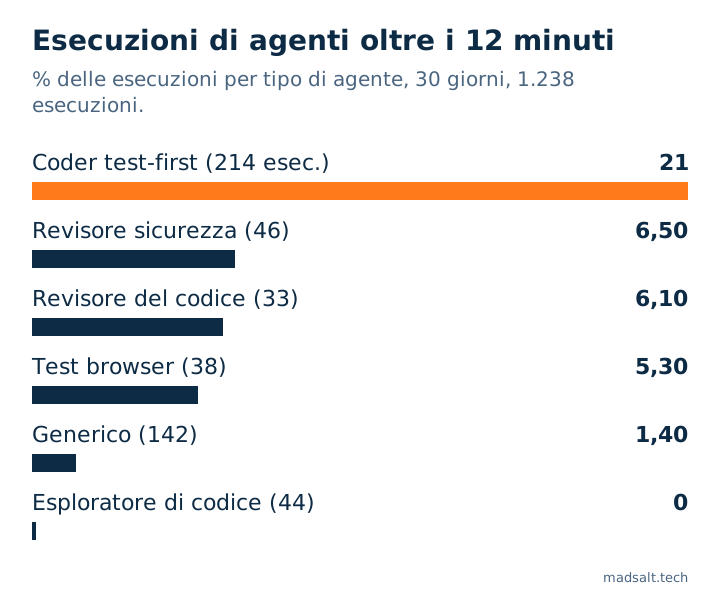
No. Fermo un subagente dopo 12 minuti o 80 chiamate a strumenti, e i log mostrano quanto i tipi siano diversi:
| Tipo di agente | Esecuzioni | Minuti mediani | 90° percentile | Oltre 12 minuti | Oltre 80 chiamate |
|---|---|---|---|---|---|
| Coder test-first | 214 | 6,8 | 17,1 | 45 (21%) | 66 (31%) |
| Revisore di sicurezza | 46 | 5,0 | 10,9 | 3 (6,5%) | 2 |
| Revisore del codice | 33 | 4,8 | 10,2 | 2 (6,1%) | 3 |
| Esecutore test browser | 38 | 4,3 | 10,5 | 2 (5,3%) | 2 |
| Generico | 142 | 3,1 | 6,5 | 2 (1,4%) | 8 |
| Architetto | 72 | 5,2 | 8,5 | 0 | 4 |
| Esploratore di codice | 44 | 1,9 | 3,4 | 0 | 0 |
| Tutte le 1.238 esecuzioni | 4,0 | 11,8 | 72 (5,8%) | 98 (7,9%) |
Un agente di codice che scrive un test, lo esegue, corregge il codice e lo riesegue ha bisogno di più tempo e più chiamate di uno che legge file. Con un solo limite, il coder viene interrotto un quinto delle volte e l’esploratore potrebbe restare bloccato sei volte la sua durata normale prima che qualcuno se ne accorga. Il pannello che costruirei mostra il 90° percentile di ogni tipo e segnala un agente in corso che supera il proprio, non un numero globale. Prima di fermarne uno, leggo la sua ultima azione registrata: un agente a 15 minuti da un lungo test sta lavorando, uno la cui ultima azione risale a 10 minuti fa è bloccato.
Quanto costa un’esecuzione in token?
Un’esecuzione mediana ha usato 125.828 token e il 90° percentile 211.884, contando tutto ciò che l’agente ha letto e scritto. Gli esploratori stavano più in basso (mediana 86.389), gli agenti generici più in alto (141.495). I prezzi cambiano troppo spesso per stamparli, quindi la dashboard dovrebbe salvare i token per esecuzione e modello e applicare il listino attuale quando disegna il costo. Quanto costa lo stesso lavoro su modelli diversi è in Quanto costa un agente IA? Numeri di 4 progetti reali.
Dei 1.775 avvii, 883 sono andati al modello di taglia media, 827 al più grande, 33 al più recente modello di punta e 32 ad altri; il 54% degli agenti poteva modificare file.
Le esecuzioni concluse hanno davvero avuto successo?
Delle 1.238 esecuzioni che hanno riferito, 1.172 si sono concluse, 64 sono fallite e 2 sono state fermate. Quel 94,7% dice che l’agente ha finito, non che il suo lavoro fosse giusto. Nel mio sistema ogni modifica al codice passa comunque da un revisore di sicurezza e da un revisore del codice, che possono rimandarla indietro; niente di questo è visibile nello stato di un’esecuzione. Una dashboard può mostrare che un’esecuzione è finita. Se il risultato sia corretto richiede un secondo agente, un test o una persona.
Quali strumenti esistono per questo?
Per un’app in produzione in cui gli agenti parlano con i clienti, strumenti di tracciamento ospitati come Langfuse, LangSmith, Datadog o le viste agente di Grafana coprono latenza, token e trace, e alcuni possono valutare gli output. Per più agenti di codice su una macchina esistono dashboard open source che leggono gli eventi hook degli agenti in un database locale. I miei numeri vengono dai log che il sistema scrive comunque: un registro degli avvii, una riga per avvio, e le trascrizioni di sessione. Per un singolo sviluppatore bastava, e uno script su quei due file ha prodotto ogni tabella qui.
Come può essere una vista completa dell’orchestrazione, con mappa degli agenti, workflow builder e grafici dei costi, è nel mio prototipo Dashboard di orchestrazione multi-agente.
Limiti. Uno sviluppatore, un sistema, 30 giorni. “Rifiutato da una regola di guardia” è riconosciuto dal testo dell’errore, quindi alcuni errori possono essere contati dalla parte sbagliata. Durata e numero di chiamate vengono dagli agenti eseguiti in background che hanno riferito; gli agenti in primo piano non sono nella tabella delle durate. I fallimenti non sono stati attribuibili in modo affidabile ai tipi di agente e sono quindi riportati solo come totale.