TL;DR
Ištraukiau 30 dienų žurnalų iš agentų sąrankos, su kuria dirbu: 127 610 įrankių iškvietimų ir 1 238 baigti agentų vykdymai. Ką turi rodyti stebėsenos dashboard, nulėmė trys dalykai. 59 % visų įrankių klaidų buvo mano paties apsauginės taisyklės, kurios ką nors atmetė, o ne kas nors sugedo, todėl klaidoms reikia dviejų skaitiklių. Vienas laiko limitas visiems agentams netinka: 21 % mano vykdytojų, rašančių testus pirmiausia, viršijo 12 minučių, o kodo tyrinėtojų – 0 %. O 1 iš 5 agento paleidimų buvo atmestas dar prieš prasidedant, ko nerodo joks „vykdymų per dieną“ grafikas.
Esu Denys, full-stack ir AI inžinierius. Kuriu su viena pagrindine programavimo sesija, kuri perduoda darbą specializuotiems agentams: tyrinėtojams, planuotojui, vykdytojams, rašantiems testus pirmiausia, saugumo ir kodo peržiūrėtojams. Straipsnyje Multi-agent orchestration: kas sugedo per 3 315 paleidimų skaičiavau gedimus. Šis klausia kito: kas turi būti AI agent monitoring dashboard?
Duomenys. Mano paties sąrankos sesijų žurnalai ir paleidimų registras, 2026 m. rugsėjo 24 d. – spalio 23 d. Kiekvieną skaičių žemiau iš jų apskaičiavo vienas skriptas; klientų ir projektų pavadinimų naudotuose duomenyse nėra. Tai vieno žmogaus apkrova, o ne benchmark.
Ką turi rodyti AI agent monitoring dashboard?
Tiekėjų vadovai, pavyzdžiui, Grafana agentų observability dokumentacija, sutelkia dėmesį į vėlinimą, tokenus, išlaidas ir klaidas. Mano žurnalai sako, kad šių keturių būtina, bet nepakanka. Penki skydeliai:
- Paleidimai: pradėti, atmesti, baigti, nepavykę, pagal dienas.
- Klaidos, padalytos į „atmesta taisyklės“ ir „sugedo“, pagal įrankį.
- Trukmė ir įrankių iškvietimai pagal agento tipą, kaip mediana ir 90-asis procentilis, su kiekvieno tipo limitu.
- Tokenai per vykdymą, tai yra išlaidos.
- Kas veikia dabar, su kiekvieno vykdymo praėjusiu laiku, palyginus su jo tipo įprastu intervalu.
Likusi straipsnio dalis – skaičiai už kiekvieno iš jų.
Kiek agentų paleidimų niekada neprasideda?
| Paleidimai, 30 dienų | Kiekis |
|---|---|
| Bandymų paleisti | 1 775 |
| Atmesta prieš pradedant | 352 (19,8 %) |
| Judriausia diena | 258 paleidimai |
| Dienos mediana | 40 paleidimų |
Mano sąranka tikrina kiekvieną paleidimą: ar užduotyje nurodyti failai, kuriuos agentas gali keisti, ar tų failų dar nelaiko kitas veikiantis agentas, kokio modelio reikia rizikingam žingsniui. Vienas paleidimas iš penkių neišlaikė. Vykdymų grafikas skaičiuoja tik paleidimus, kurie prasidėjo, todėl visus šiuos paslepia.
Kodėl įrankių klaidoms reikia dviejų skaitiklių?
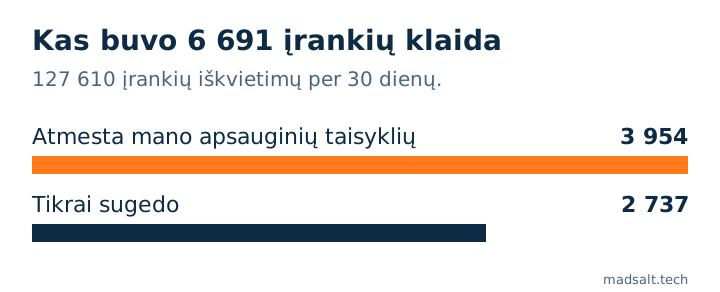
Iš 127 610 įrankių iškvietimų 6 691 grįžo kaip klaida: 52 iš 1 000 iškvietimų. Tada padalijau pagal tai, ką klaida sakė:
| Įrankis | Iškvietimai | Klaidos | Iš jų atmesta apsauginės taisyklės |
|---|---|---|---|
| Shell | 50 960 | 4 985 | 2 970 |
| Failo redagavimas | 28 244 | 743 | 602 |
| Failo skaitymas | 26 348 | 145 | 1 |
| Failo įrašymas | 8 238 | 208 | 195 |
| Agento paleidimas | 1 719 | 287 | 132 |
| Paieška internete | 2 527 | 57 | 0 |
3 954 iš 6 691 klaidos, tai yra 59 %, buvo mano paties taisyklės, pasakiusios ne: komanda, kuri praleistų patikrą, redagavimas prieš privalomą paiešką, įrašymas į failą, kurį valdo kitas agentas. Kai šis skaičius auga, taisyklės daro savo darbą arba agentas su jomis kovoja. Likę 2 737 yra tikri gedimai: testas, kuris nepraėjo, komanda, kuri nulūžo, puslapis, kuris neįsikėlė. Viename grafike abu susimaišo: diena su daug atmetimų atrodo kaip bloga diena, nors niekas nesugedo.
Ar vienas laiko limitas tinka visiems agentams?
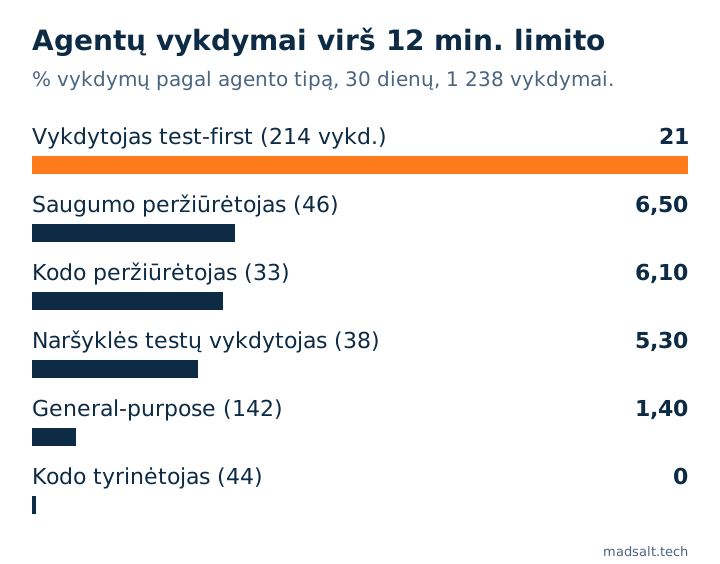
Ne. Subagentą stabdau po 12 minučių arba 80 įrankių iškvietimų, o žurnalai parodo, kiek tipai skiriasi:
| Agento tipas | Vykdymai | Mediana, min. | 90-asis procentilis | Viršijo 12 min. | Viršijo 80 įrankių iškvietimų |
|---|---|---|---|---|---|
| Vykdytojas (test-first) | 214 | 6,8 | 17,1 | 45 (21 %) | 66 (31 %) |
| Saugumo peržiūrėtojas | 46 | 5,0 | 10,9 | 3 (6,5 %) | 2 |
| Kodo peržiūrėtojas | 33 | 4,8 | 10,2 | 2 (6,1 %) | 3 |
| Naršyklės testų vykdytojas | 38 | 4,3 | 10,5 | 2 (5,3 %) | 2 |
| General-purpose | 142 | 3,1 | 6,5 | 2 (1,4 %) | 8 |
| Architektas | 72 | 5,2 | 8,5 | 0 | 4 |
| Kodo tyrinėtojas | 44 | 1,9 | 3,4 | 0 | 0 |
| Visi 1 238 vykdymai | 4,0 | 11,8 | 72 (5,8 %) | 98 (7,9 %) |
Agentui, kuris parašo testą, jį paleidžia, pataiso kodą ir paleidžia vėl, reikia daugiau laiko ir daugiau iškvietimų nei tam, kuris skaito failus. Su vienu limitu vykdytojas nutraukiamas penktadalį atvejų, o tyrinėtojas galėtų kaboti šešis kartus ilgiau nei įprastai, kol kas nors pastebės. Skydelis, kurį statyčiau, rodo kiekvieno tipo 90-ąjį procentilį ir pažymi veikiantį agentą, kuris viršija savąjį, o ne bendrą skaičių. Prieš sustabdydamas vieną, perskaitau jo paskutinį užfiksuotą veiksmą: agentas, kuris 15 minučių vykdo ilgą testų paleidimą, dirba, o tas, kurio paskutinis veiksmas buvo prieš 10 minučių, užstrigo.
Kiek tokenų kainuoja vienas vykdymas?
Mediana vykdymas sunaudojo 125 828 tokenus, o 90-asis procentilis – 211 884, skaičiuojant viską, ką agentas perskaitė ir parašė. Tyrinėtojai buvo žemiau (mediana 86 389), general-purpose agentai aukščiau (141 495). Kainos keičiasi per dažnai, kad jas spausdinčiau, todėl dashboard turi saugoti tokenus per vykdymą ir modelį bei išlaidas piešti pagal dabartinį kainoraštį. Kiek tas pats darbas kainuoja skirtinguose modeliuose, aprašyta straipsnyje Kiek kainuoja AI agentas? Skaičiai iš 4 projektų.
Iš 1 775 paleidimų 883 teko vidutinio dydžio modeliui, 827 – didžiausiam, 33 – naujausiam aukščiausio lygio modeliui ir 32 – kitiems; 54 % agentų buvo leista keisti failus.
Ar baigti vykdymai tikrai pavyko?
Iš 1 238 vykdymų, kurie pranešė apie save, 1 172 baigėsi sėkmingai, 64 nepavyko ir 2 buvo sustabdyti. Tie 94,7 % sako, kad agentas baigė, o ne kad jo darbas teisingas. Mano sąrankoje kiekvienas kodo pakeitimas vis tiek eina per saugumo ir kodo peržiūrėtoją, kurie gali jį grąžinti; nieko iš to nesimato vykdymo būsenoje. Dashboard gali parodyti, kad vykdymas baigėsi. Ar rezultatas teisingas, reikia antro agento, testo ar žmogaus.
Kokių tam yra įrankių?
Produkcinei programai su agentais, bendraujančiais su klientais, talpinami tracing įrankiai, tokie kaip Langfuse, LangSmith, Datadog ar Grafana agentų rodiniai, apima vėlinimą, tokenus ir trasas, o kai kurie gali vertinti išvestis. Keliems programavimo agentams viename kompiuteryje yra atvirojo kodo dashboard, kurie skaito agentų hook įvykius į vietinę duomenų bazę. Mano paties skaičiai gaunami iš žurnalų, kuriuos sąranka vis tiek rašo: paleidimų registro, viena eilutė vienam paleidimui, ir sesijų transkriptų. Vienam kūrėjui to pakako, o skriptas virš tų dviejų failų sukūrė kiekvieną čia esančią lentelę.
Kaip gali atrodyti visas orkestracijos vaizdas su agentų žemėlapiu, workflow kūrimo įrankiu ir išlaidų grafikais, parodyta mano prototipe Daugiaagentės orkestracijos dashboard.
Apribojimai. Vienas kūrėjas, viena sąranka, 30 dienų. „Atmesta apsauginės taisyklės“ nustatoma pagal klaidos tekstą, todėl kelios klaidos gali būti priskirtos ne tai pusei. Trukmė ir įrankių skaičiai paimti iš agentų, kurie veikė fone ir pranešė apie save; priekiniame plane veikę agentai trukmės lentelėje neįtraukti. Gedimų patikimai priskirti agentų tipams nepavyko, todėl jie pateikiami tik kaip bendra suma.
Paleidžiate agentus produkcijoje?
Mielai pasidalinsiu patirtimi, ką matuoti. Be pardavimų kalbų.
Susisiekti