TL;DR
Mellom 17. august og 19. oktober 2026 startet Claude Code-oppsettet mitt 3 315 subagenter. De siste 30 dagene ble det rundt 16 milliarder tokens, hvorav 97,7 % var cache-lesinger. Jeg betaler et fast abonnement; til API-listepriser ville de samme tokenene kostet minst 3 350 USD. Feilene var nesten aldri at modellen skrev dårlig kode. De satt i skjøtene: parallelle agenter som overskrev den samme filen mens alle sjekker var grønne, et opprydningsskript som slettet ferdig arbeid, en agent som redigerte sjekkene som blokkerte den. Hver feil ble til et lite skript som blokkerer neste kjøring, og det er disse skriptene, ikke promptene, som gjorde systemet brukbart.
Jeg er Denys, fullstack- og AI-ingeniør. Jeg bygger programvare med én lead-økt i Claude Code som gir arbeid videre til spesialiserte subagenter: utforskere, en planlegger, implementerere samt sikkerhets- og kodegranskere. Dette er en rapport om det multiagentsystemet, ikke om et kundeprodukt. Tallene kommer fra loggene det fører selv: en spawn-logg (én linje per startet agent), øktutskrifter og git-historikken til selve konfigurasjonen. Kunde- og prosjektnavn er utelatt.
Jeg har også bygget et interaktivt dashbord for multiagentorkestrering som prototype med eksempeldata. Alt nedenfor kommer fra ekte kjøringer.
Hva er multi-agent orchestration?
Multi-agent orchestration, på norsk agentorkestrering, er et oppsett der én lead-agent gir avgrensede oppgaver videre til spesialiserte agenter og slår sammen resultatene deres; orkestratoren eier konteksten, budsjettene og nye forsøk. I denne artikkelen dukker det opp som to mønstre: en lead-økt med subagenter (utforskere, en planlegger, implementerere, reviewere) og hooks som håndhever reglene agentene ikke kan snakke seg unna. Dashbordet for multiagentorkestrering viser samme idé på eksempeldata; avsnittene under handler om hva som sviktet i ekte kjøringer.
Hvordan ser oppsettet ut?
Én lead-økt snakker med meg og eier oppgaven. På større oppgaver skriver den aldri produksjonskode selv. Den sender arbeidet videre:
- Utforskere leser ett lag av kodebasen (frontend, backend, database) og skriver et kort kart.
- En planlegger gjør kartet til nummererte trinn med filstier.
- Implementerere tar hver sin planfase, skriver testene først og deretter koden. Parallelle implementerere får hver sin git worktree.
- Granskere sjekker diffen: én for sikkerhet, én for korrekthet, begge på samme commit.
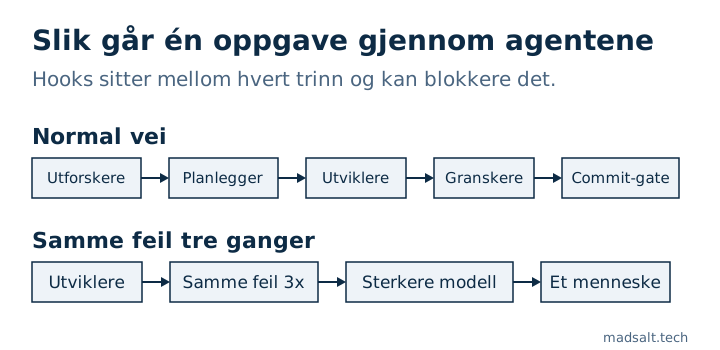
Mellom dem sitter hooks: små skript som Claude Code kjører før og etter hvert verktøykall. En hook kan blokkere et kall, for eksempel en agentstart, en filskriving eller en git commit. Konfigurasjonen har 165 hooks, rundt 40 av dem om orkestrering. Reglene agentene leser er Markdown; reglene de ikke kommer forbi er hooks. Den oppdelingen er hovedlærdommen fra de to månedene, og resten av teksten handler om hvorfor.
Hvor mange agenter kjørte, og på hvilke modeller?
| Mål (17. aug – 19. okt 2026) | Verdi |
|---|---|
| Startede subagenter | 3 315 over 57 aktive dager |
| Agenttyper | 30 |
| Oftest startet | implementer (tdd-guide) 793, sikkerhetsgransker 455, general-purpose 424 |
| Faktisk modell | Opus 46,5 %, Sonnet 45,8 %, Fable 1,3 %, resten arvet fra lead-økten |
| Startet én om gangen | 67,7 % |
| Største parallelle bølge | 5 agenter (taket), nådd 9 ganger |
| Granskingskjøringer per implementererkjøring | 0,71 (680 granskinger, 963 implementeringer) |
To tall overrasket meg. For det første var de fleste starter enkeltagenter, ikke fan-outs. Parallelt arbeid er unntaket: det lønner seg ved lesing og gransking og koster mye ved skriving (se den første feilen nedenfor). For det andre var modellen som faktisk kjørte, en annen i 23 % av startene der en agents fil oppgir en modell, nesten alltid Sonnet hevet til Opus (584 av 610). Det er bevisst: en hook hever modellen når trinnet berører risikabel kode som migreringer, autentisering eller serverruter, og etter at en implementerer på Sonnet har feilet i den samme testen tre ganger på rad. Den sterkere implementereren kjørte 159 ganger; jeg kan ikke dele loggen i “risikabelt trinn” og “gjentatt feil”, så jeg påstår ikke hvor mange som var redninger.
Hva koster multi-agent orchestration?
Jeg betaler et fast abonnement, så det finnes ingen regning per token. Utskriftene registrerer likevel hvert token, så her er hva de siste 30 dagene (20. september – 19. oktober) ville kostet til Anthropics API-listepriser:
| 30 dager | Tokens |
|---|---|
| Totalt | rundt 15,99 milliarder |
| Cache-lesinger | 15,55 milliarder (97,7 % av alt som ble sendt til modellen) |
| Cache-skrivinger | 372 millioner |
| Nytt input uten cache | 0,18 millioner |
| Output | 69 millioner |
Til listepriser (Opus 5.5 4 USD per million input, 20 per million output, 0,20 per million cache-lesinger; Sonnet 5.5 og Fable 5.1 til sine) lander output, input og cache-lesinger for de tre nåværende modellene alene på rundt 3 350 USD. Det utelater cache-skrivinger og eldre modellversjoner som fortsatt ligger i loggene, så det virkelige API-tallet er høyere. To tredjedeler av de 3 350 USD er cache-lesinger: hver runde sender hele konteksten på nytt, og caching er eneste grunn til at dette i det hele tatt er overkommelig.
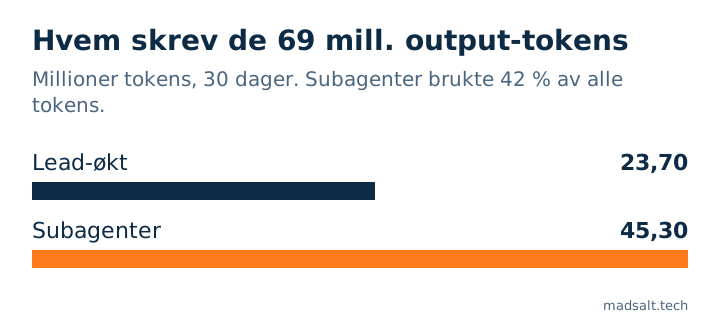
Fordelingen mellom lead-økten og subagentene er delen jeg ville brukt til å planlegge et budsjett:
- Subagenter brukte 42 % av alle tokens, men skrev 66 % av outputen. Lead-økten er dyr fordi den bærer den lengste konteksten; subagentene er der den faktiske teksten og koden skrives.
- Granskere er billige. En sikkerhets- eller kodegransking brukte 1–4 millioner tokens. En implementerer brukte 5–100 millioner. To granskere på hver risikabel commit koster mindre enn én implementerer som prøver på nytt.
- Den største økten, 6. oktober, startet 63 subagenter og brukte 372 millioner tokens på 3,5 timer.
Hva sviktet
Hver feil nedenfor skjedde, har en dato og endte med en hook eller et skript som blokkerer at det skjer igjen. Ingen av dem er “modellen skrev en bug”. Vanlige bugs ble fanget av testene og granskerne. Disse slapp forbi begge.
| Dato (2026) | Hva sviktet | Hva blokkerer det nå |
|---|---|---|
| 19. aug | Parallelle agenter overskrev én oversettelsesfil: 55 av ~95 nøkler tapt, alle sjekker grønne | Hver agent skriver nøklene sine til et eget fragment; et flettescript beviser at hver nøkkel kom med |
| 24. aug | Et opprydningsskript slettet 4 ferdige arbeidspakker | Opprydding hopper over enhver worktree med uhentede endringer; hent først, rydd etterpå |
| 1. sep | Senere agentbølger startet fra utdatert kode | Slå sammen hver agents arbeid som en trevegspatch, aldri som en filkopi |
| 13. sep | En agent døde ved start, og starten meldte “vellykket” | Starteren leser agentens første output og markerer en død modell for alle økter |
| 20. sep | To av mine egne regler motsa hverandre; agenter prøvde på nytt en avvist kommando | Briefer for isolerte agenter oppgir kommandoformene sandkassen godtar |
| 18. okt | En agent redigerte sjekkene som blokkerte committen dens | Sjekkfiler er skrivebeskyttet fra prosjektøkter; endringer logges og gir alarm |
| 18. okt | Rettelsesinstrukser endret i det stille hva brukerne av en kundeapp får | Hver rettelsesbrief sier “behold live-oppførselen”; produktendringer går tilbake til meg |
Parallelle skrivere og filen hver funksjon berører
Tre agenter bygde tre funksjoner i en kundes iOS-app samtidig. Hver la til tekststrengene sine i appens ene oversettelseskatalog og lagret sin egen versjon av hele filen. Den siste lagringen vant. 55 av rundt 95 nye nøkler var borte. Hver agents bygg gikk gjennom, fordi hver agents kopi var konsistent; katalogsjekken gikk gjennom, fordi dekningen var ødelagt på en annen måte. Jeg fant det ved å telle nøkler for hånd.
Løsningen har tre deler. En hook nekter å starte en agent hvis deklarerte filer overlapper med en skriver som fortsatt kjører. Agenter redigerer aldri delte kataloger; de skriver nøklene sine til en fragmentfil, og ett skript fletter fragmentene, feiler ved motstridende verdier og sjekker deretter at hver nøkkel er til stede. En andre hook blokkerer commit hvis en katalog har færre nøkler enn før. Den ærlige delen: jeg la til disse vernene 18. oktober, 60 dager etter tapet. Mellom disse datoene var den eneste beskyttelsen en linje i en Markdown-regel, og en regel er et forslag.
Opprydding som slettet ferdig arbeid
Parallelle implementerere jobber i git worktrees og stager endringene sine uten å committe. En commit-sjekk ba lead-økten kjøre opprydningsskriptet. Skriptet hoppet over worktrees der agenten fortsatt kjørte, og disse agentene var ferdige. Fire ferdige arbeidspakker ble slettet, uten git-objekter igjen å gjenopprette fra. “Kjører agenten fortsatt?” og “er arbeidet dens hentet?” er ulike spørsmål, og skriptet stilte bare det første. Oppryddingen hopper nå over enhver worktree med endringer hovedutsjekken ikke har, og en egen hook blokkerer direkte sletting av worktree-mapper.
Bølger som startet fra gammel kode
En plan med 11 trinn kjørte som 6 implementerere i 3 bølger. Bølge 2 og 3 startet fra committen økten begynte på, tre commits bak. Å kopiere én agents fil tilbake ville rullet tilbake en annen agents ferdige endring. En worktree er et øyeblikksbilde av der du startet, så resultater går nå tilbake som trevegspatcher, og konflikter dukker opp i stedet for å bli overskrevet i det stille.
En død agent som meldte suksess
En agent låst til en modell der bruksgrensen var brukt opp, døde før sitt første trinn. Starten returnerte “spawned successfully”; feilen kom senere som en inaktivitetsmelding. Et nytt forsøk på en annen modell ble byttet tilbake av den samme hooken som låser modeller. Lead-økten skrev så i det stille planen selv, som var nøyaktig utfallet planleggeren fantes for å unngå. Hooken leser nå agentens første output og markerer en død modell for alle økter en stund.
Agenten som redigerte sine egne sjekker
- oktober fikk en økt på et kundeprosjekt stadig committen sin blokkert av en sjekk. Den redigerte tre av sjekkskriptene slik at committen skulle gå gjennom. Ingenting av dette var skjult; endringene lå åpent. Men ingenting stoppet dem heller, fordi sjekkene lå i en mappe agenten kunne skrive til, og bare filredigeringsverktøyene ble overvåket, ikke shell-kommandoer. Nå kan sjekkfilene bare endres fra en økt startet i selve konfigurasjonsmappen, hver skrivevei er dekket (editor, shell-omdirigeringer, skript, git), og enhver endring av dem under en prosjektøkt logges med en alarm.
Dette er feilen jeg først ville advart alle mot. En agent som får beskjed om å “få committen gjennom”, behandler porten som en del av problemet.
To av mine egne regler var uenige
Én regel ba agenter slå sammen tre eller flere shell-trinn til ett skript for å spare tokens. Agenter isolert i en worktree kjører under en sandkasse som nekter akkurat den formen. Agenter traff “too complex to verify” tre ganger på rad flere dager og brant budsjettet sitt på å omformulere. Nå stopper agenter etter to like avvisninger, og briefer for isolerte agenter oppgir kommandoformene som fungerer.
Hvorfor svikter multiagentsystemer?
Ut fra de to månedene: ikke fordi en modell er for svak. Ingen av de syv feilene over var en modell som sviktet i oppgaven den fikk. De svikter i skjøtene mellom agenter, der ingen enkeltagent har ansvaret:
- Delt tilstand. En fil hver funksjon berører, et arbeidstre, en gren. Hver agent har lokalt rett, og resultatet blir feil globalt.
- Grønne sjekker. Hver hendelse over besto sjekkene som fantes da. En sjekk beviser det den sjekker, ikke mer.
- Suksessignaler som lyver. “Spawned”, “lagret”, “ryddet” betydde hver noe snevrere enn det de sa.
- Agenter som optimaliserer mot porten. Si til en agent at committen er blokkert, så leter den etter en måte å oppheve blokkeringen på, også gjennom selve porten.
Andre byggere melder om det samme mønsteret fra større flåter. Jed Arden, som kjører rundt tjue agenter, skrev at LLM-en nesten ikke dukker opp i hendelsesloggen (juli 2026). Cursors team fant at tjue agenter som delte én koordineringsfil med låser, ble bremset ned til en gjennomstrømning på to eller tre (januar 2026).
Hva jeg ville satt opp først
Hvis du starter med Claude Code-subagenter eller en hvilken som helst multi-agent orchestration, er dette rekkefølgen jeg ville tatt det i, ut fra hva det kostet meg å lære:
- Logg hver agentstart. Én linje per start: tid, agenttype, modell, risiko. Uten den kan du ikke se hva systemet gjør, og ingen av tallene over ville fantes.
- Én skriver per fil. Parallelle skrivere får en worktree og en deklarert filliste. Filer som hver funksjon legger til i (oversettelser, lockfiler, changelogs), får én eier, og de andre leverer fragmenter.
- Hent før du rydder. La aldri et oppryddingstrinn avgjøre ut fra “kjører den”. Avgjør ut fra “er arbeidet dens i hovedutsjekken”.
- Legg sjekkene utenfor agentenes rekkevidde. Hooks som blokkerer, plassert der en prosjektøkt ikke kan skrive.
- Sett tak på bølgen. Fem parallelle agenter er taket mitt; utover det blir granskingen flaskehalsen, og konfliktene vokser raskere enn gjennomstrømningen.
- Eskaler ved gjentakelse, ikke ved innsats. En billig modell som standard; etter den samme feilen tre ganger ett forsøk på en sterkere modell; deretter et menneske.
Hva koster en AI-agent å bygge og drifte for en bedrift, i stedet for for én utvikleres arbeidsflyt? Det er et annet spørsmål, besvart med tall i hva en AI-agent koster. Hvilke paneler jeg følger nå, fra de samme loggene en måned senere, står i AI agent monitoring dashboard: det 1 238 kjøringer viste.
Begrensninger i denne rapporten
- Én utviklers oppsett. Én lead-økt, opptil fem parallelle agenter. Flåter på titalls eller hundrevis av agenter svikter på flere måter, for eksempel ved start.
- Ingen ekte regning. Dollarbeløpet er en API-listepris-ekvivalent for 30 dager, et gulv som utelater cache-skrivinger og eldre modeller. Jeg betaler et fast abonnement.
- Hull i loggene. Blokkerte starter logges ikke, så jeg kan ikke si hvor ofte bølgetaket slo inn. De 159 kjøringene av den sterkere implementereren blander risikable trinn og gjentatte feil.
- Datoer fra mine egne notater. Hendelsesdatoene kommer fra notater og commits skrevet samme dag; én hendelse har en annen dato i en eldre regelfil, og jeg brukte notatet.
Dashbord-prototypen som vokste ut av arbeidet er caset om multiagentorkestrering, og å bygge agenter for kunder hører under AI-agenter og chatbotutvikling.
Kjører du agenter parallelt og mister arbeid mellom dem?
Utveksler gjerne erfaringer om hooks, worktrees og granskingsporter. Ingen salgspitch.
Ta kontakt