TL;DR
Hva koster en AI-agent i drift? Det kommer an på tre ting: modellkallene, systemene den styrer og sikringene som hindrer at den feiler i det stille. Modellen du velger påvirker tokenregningen mest: tusen like agentsteg koster USD 0,46 på DeepSeek V4.1 Flash, USD 0,65 på Claude Haiku 5.5 og USD 26 på Claude Opus 5.5. I fire systemer jeg bygde i år var modellkallene også det enkleste å sette tak på: USD 0,05 for en sjekk i bakgrunnen og høyst USD 2,10 for en full researchkjøring. Proxytrafikk for én prissammenligning kostet USD 3,08, og de dyre overraskelsene var feil ingen så, som et avbrudd som varte i 8 dager før noen la merke til det.
Jeg er Denys, fullstack- og AI-ingeniør. De fleste artikler om dette spørsmålet oppgir brede intervaller uten noe prosjekt bak. Under er målerne fra fire ting jeg har bygget og driver, med kilden til hvert tall: konfigurasjonsfiler, commit-meldinger og målte kjøringer. Der et tall er et tak jeg satte og ikke en regning jeg betalte, sier jeg det.
Hva koster en AI-agent når den først er i drift?
Tre målere, og modellen er bare én av dem.
| Prosjekt | Hva AI-en gjør | Modellkostnad per enhet | Hva annet som utgjør regningen |
|---|---|---|---|
| Personlig assistent | Chatter på Telegram, jobber i CRM og e-post, søker på nettet | USD 0,00065–0,026 per steg, avhengig av modell; tak fra USD 0,05 til 2,10 per kjøring | Én server, pluss nye forsøk og vaktfunksjoner |
| Prissammenligning for et reisebyrå | En egen AI-agent starter sammenligninger via en MCP-server | Null på min side: den agenten betaler sine egne tokens | Proxytrafikk, ca. USD 3,08 per kjøring, og en server med 8 kjerner |
| Lydkontroll av direktesendinger | Oppdager tale og talespråk på hver kanal | Null per kall: to små modeller kjører på stedets egen maskin | Prosessor: en demo med 32 kanaler brukte ca. 0,9 av en skyserver med 2 kjerner |
| Eiendomsattester | Leser ukjente portaler som et menneske | Tokens bare for portaler skriptene ikke kjenner | Skript håndterer den kjente portalen helt uten tokens |
Mønsteret holdt i alle fire: den billigste tokenen er den du aldri sender, og de dyre timene går til delene rundt modellen.
Hva koster modellkallene?
Assistenten er den eneste av de fire der modellregningen er min. Den kjører på Anthropics Claude Agent SDK, og hver agent i den har et hardt tak i koden. SDK-en stopper en kjøring når grensen for runder eller dollar nås.
| Jobb | Modell | Tak per kjøring |
|---|---|---|
| Sjekk i bakgrunnen når det er stille | Claude Haiku 4.5 | USD 0,05, og USD 1,00 per dag totalt |
| Research: del opp spørsmålet | Claude Opus 4.6 | USD 0,10, 1 runde |
| Research: tre researchere parallelt | Claude Opus 4.6 | USD 0,50 hver, 3 runder, nettsøk og henting av sider |
| Research: skriv svaret | Claude Opus 4.6 | USD 0,50, 1 runde |
| Hovedsamtalen | Haiku, Sonnet eller Opus, se under | 200 runder eller USD 50, et sikkerhetsnett og ikke en forventning |
Det meste en full researchkjøring kan koste, er altså USD 0,10 + 3 × 0,50 + 0,50 = USD 2,10. Det er et tak, ikke et snitt; hva en kjøring faktisk koster, avhenger av modellen, som neste avsnitt priser.
To valg kuttet regningen mer enn noen prisendring:
- Send hver melding til den billigste modellen som klarer den. Korte, enkle meldinger går til Haiku, middels til Sonnet, flertrinns til Opus. Ruteren leser nøkkelord og meldingslengde, så selve rutingen koster ikke noe modellkall. Først kjørte alle agentene på Opus.
- Slett kall som ikke fortjener plassen sin. Sjekken i bakgrunnen ba modellen om en statusrapport i hver syklus. Den hadde ikke tilgang til e-post eller CRM, så alt den kunne gjøre, var å skrive meldinger ingen trengte. Jeg fjernet modellkallet helt. Dagstaket på USD 1,00 står fortsatt i konfigurasjonen og beskytter ingenting.
Ett ærlig hull: SDK-en rapporterer kostnaden for hvert kall, og jeg lagret den aldri. Månedssummen finnes i Anthropic-konsollen, ikke i appen. Hvis jeg bygde den på nytt, ville jeg logget kostnad per kall fra dag én, slik at du ser hvilken jobb som bruker pengene, ikke bare hvor mye.
Hvor mye endrer modellvalget regningen?
Mer enn noe annet på tokensiden. Under er ett agentsteg priset på ulike modeller. Steget er ca. 4 000 tokens inn og 500 ut, anslaget per kall som står i assistentens egen kode for sjekken i bakgrunnen. Prisene er OpenRouters liste 15. oktober 2026. OpenRouter videreformidler hver leverandørs listepris og tar sitt gebyr når du kjøper kreditter (5,5 % på standardplanen), ikke per forespørsel.
| Modell | Pris per 1 million tokens, inn / ut | Ett steg | 1 000 steg |
|---|---|---|---|
| DeepSeek V4.1 Flash | USD 0,024 / 0,72 | USD 0,00046 | USD 0,46 |
| Claude Haiku 5.5, GPT-6 Luna | USD 0,10 / 0,50 | USD 0,00065 | USD 0,65 |
| Qwen3.8 Flash | USD 0,15 / 0,47 | USD 0,00083 | USD 0,83 |
| Mistral Small 4 | USD 0,15 / 0,60 | USD 0,00090 | USD 0,90 |
| Llama 4 Maverick | USD 0,188 / 0,652 | USD 0,0011 | USD 1,08 |
| Gemini 3.5 Flash Lite | USD 0,30 / 2,50 | USD 0,0025 | USD 2,45 |
| DeepSeek V4 Pro | USD 0,955 / 1,911 | USD 0,0048 | USD 4,78 |
| Gemini 3.8 Flash | USD 0,75 / 3,75 | USD 0,0049 | USD 4,88 |
| Grok 4.7 | USD 2 / 6 | USD 0,011 | USD 11 |
| Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon | USD 2 / 10 | USD 0,013 | USD 13 |
| Claude Opus 5.5 | USD 4 / 20 | USD 0,026 | USD 26 |
| Claude Fable 5.1, GPT-6 Astra | USD 10 / 50 | USD 0,065 | USD 65 |
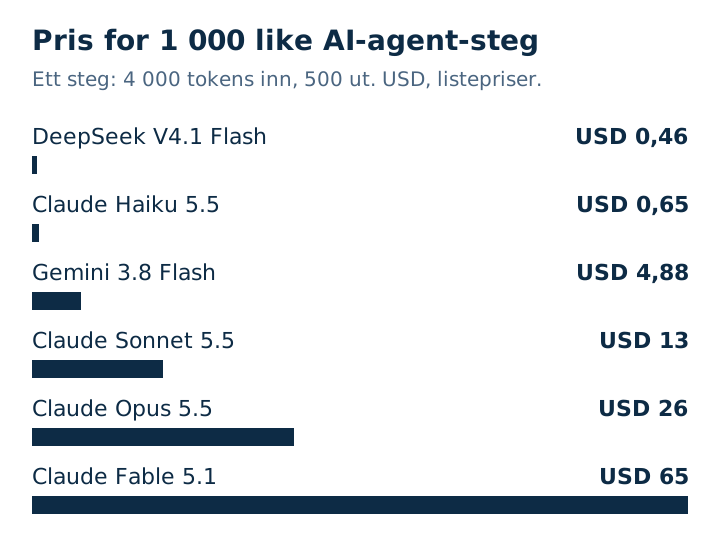
Det samme arbeidet koster fra USD 0,46 til USD 65 per tusen steg, en forskjell på rundt 140 ganger. Tre ting følger av det:
- En liten modell håndterer de fleste stegene. Å sortere en melding, hente felt fra et dokument, svare ut fra en kjent tekst: det krever sjelden en toppmodell. Spar de store til planlegging og vanskelig resonnering, slik rutingen over gjør.
- Prisene endrer seg raskt. Assistenten kjørte på Claude Haiku 4.5, Sonnet 4.6 og Opus 4.6. Etter dagens liste koster steget USD 0,0065 på Haiku 4.5 og USD 0,00065 på Haiku 5.5. Anthropic oppgir at de nyere modellene teller omtrent 30 % flere tokens for samme tekst, så per steg er den nyere likevel nesten åtte ganger billigere. Googles Gemini 4 Argon skal doble prisen 1. desember 2026. Sjekk på nytt før du planlegger et år frem.
- Sammenlign oppgaver, ikke tokenpriser. En billigere modell som trenger to forsøk, eller en lengre prompt for å oppføre seg, kan koste mer per ferdig oppgave. Mål et utvalg ekte oppgaver på to eller tre modeller før du velger.
Ditt eget anslag er én linje: steg per oppgave × oppgaver per måned × stegprisen for modellen din.
Hvorfor var konteksten det virkelige problemet, ikke prisen per token?
Prisen per token er forutsigbar. Konteksten er det ikke. Feilene som gjorde vondt i denne assistenten, handlet alle om hvor mye tekst som gikk inn i hvert kall:
- Lange økter ødela svar. For å svare raskere holdt appen en varm økt åpen mellom meldingene. Når konteksten rant over, begynte modellen å returnere uleselig tekst blandet fra flere alfabeter. Løsningen: bytt ut økten etter 20 meldinger og prøv på nytt i en fersk økt når et svar ser ødelagt ut.
- Et lagret sjekkpunkt ble for stort. En dag feilet kall med “Prompt is too long”. Sjekkpunktet som legges inn i hvert kall, er nå begrenset til 2 KB.
- Systemprompten bar filer den sjelden trengte. Å laste ferdigheter bare når en melding trenger dem, sparte ca. 3 000 tokens per kall, og å ta tre referansefiler ut av forhåndslastingen sparte ca. 1 500 til. Dette er anslag fra commit-notatene, ikke fakturalinjer.
- Historikken var lengre enn nyttig. Samtalehistorikken som ble sendt med hvert kall, gikk fra 20 til 10 meldinger.
Alle disse tiltakene senker kostnaden og gjør svarene raskere samtidig. Behandle kontekst som et budsjett, på samme måte som penger.
Hva koster infrastrukturen en agent styrer?
I reiseprissammenligningen er AI-delen en egen agent. Den starter sammenligninger via en MCP-server jeg bygde, og tokenene faktureres den som kjører agenten. Det selve systemet betaler for, er datainnsamlingen bak: boligproxyer og en server full av nettlesere.
Målte tall fra det systemet:
- Proxytrafikk: én kjøring over to reisenettsteder brukte ca. 935 MB, ca. USD 3,08, omtrent 0,23 MB per lagrede prisrad.
- Blokkering av sporere: på ett nettsted kuttet blokkering av sporingsskript trafikken fra 4,2 MB til 2,5 MB per søk, med identiske priser i alle seks testkjøringene.
- Ingen nettleser der den ikke trengs: prisene på ett nettsted kunne leses med en vanlig HTTP-klient som ser ut som en mobilnettleser. Innsamlingen gikk fra 8 til 43 datoer i minuttet på fem arbeidere, og nettlesekoden for det nettstedet ble slettet.
- Prosessoren, ikke minnet, avgjør serverstørrelsen: med 20 nettlesere på en server med 8 kjerner var lasten ca. 30 mens 6–7 GB RAM sto ledig. En varm nettleser tar ca. 345 MB. Dimensjoner serveren etter kjerner.
Hvis agenten din styrer nettlesere, proxyer eller betalte API-er, vil disse målerne trolig vokse forbi modellregningen. Mål dem per oppgave før du velger modell.
Når er AI på enheten billigere enn et API?
Når inndataene aldri trenger å forlate lokalet og modellen er liten. Sendeprosjektet kontrollerer direkte lydkanaler under sportssendinger: stillhet, knitring, en kommentator som bytter til feil språk. Å sende hvert sekund lyd til et API ville kostet penger ved hvert kall og lagt til forsinkelse.
I stedet kjører to åpne modeller på stedets egen maskin: den ene oppdager tale, den andre sier hvilket språk som snakkes. Til sammen har de ca. 24 MB vekter, taledetektoren legger til ca. 7 MB RAM, og det er ingen pris per kall. I en demo med 32 kanaler brukte analyse av hver kanal i sanntid ca. 0,9 av en skyserver med 2 kjerner.
Kompromisset er presisjon du må bevise selv. På et offentlig sett med ren opplest tale, 30 klipp på tre sekunder per språk, hadde språkmodellen rett i 93,3 % av tilfellene for portugisisk og minst 96,7 % for spansk, engelsk og fransk. Det er et tak, ikke en prognose: publikumsstøy og musikk under en kommentator ble aldri målt, fordi det ikke fantes lyd fra en ekte sendekrets.
Hva koster det å gjøre en agent trygg å la være i fred?
Dette er kostnaden de fleste anslag hopper over, og det er her timene mine gikk. Noen ekte feil:
- Et stille avbrudd på 8 dager. Et annet prosjekt på samme server oppdaterte en delt nettleserbuffer. Innsamlerens pool gikk fra 40 fungerende nettlesere til 0, jobbene hang uten feilmelding, og ingen fikk varsel. Løsningen var liten: gi innsamleren sin egen nettleserbuffer. Å finne årsaken tok 8 dager, fordi det ikke fantes noe varsel på at poolen var klar.
- En jobb som “lyktes” med ingenting. Én kjøring gikk gjennom 359 datoer på 12 minutter, lagret 0 rader og meldte suksess. Nå stopper jobber etter 25 tomme datoer på rad og sier hvorfor.
- En stoppet kjøring som fortsatte å bruke penger. En sammenligning som var markert som stoppet, fortsatte i 4 timer og brukte proxytrafikk hele tiden.
- En proxygrense tømte poolen. Da proxyabonnementet nådde trafikkgrensen, krympet poolen fra 40 nettlesere til 0 på 12 minutter og ble stående slik til en omstart. Nå fyller den seg selv opp hvert 60. sekund, med økende pause opp til 5 minutter.
- For mange varsler første dag. Den første testen av sendeverktøyet på en ekte sending med 16 kanaler og 49 minutters lengde ga 3 492 hendelser. 92,4 % var støy og varsler om stemmeskifte, og operatøren trykket Tøm 182 ganger på 27 minutter. Detektorene var i orden; terskelene hadde bare aldri møtt ekte programlyd. Løsningen var en bryter per profil, ikke ny matematikk.
- Hengende kall og forbruksgrenser. Assistenten har nå en vaktfunksjon på 120 sekunder for et kall som blir stille, en grense på 300 sekunder for hele kallet og opptil 3 nye forsøk etter 30 sekunder, 2 minutter og 5 minutter når API-et er overbelastet eller har nådd forbruksgrensen. Et hengende verktøykall faller ikke over til reservemodellene, fordi en tregere modell ikke fikser et fastlåst verktøy.
Ingenting av dette vises som en tokenpris. Det vises som timer, og som tillit som går tapt når agenten sier “ferdig” og tar feil. Sett av budsjett: en første test på ekte data, varsler på det som kan bli stille, og sjekker av at en “suksess” faktisk ga noe.
Hvor passer AI inn når skript kan gjøre det meste av jobben?
I kantene. Eiendomsattesttjenesten henter papirer fra eiendomsforvalteres nettkontoer og bygger attesten en selger trenger. Et skript håndterer den kjente hovedportalen, der 95 % av dokumentene blir ferdige. Bilde-AI leser bare portalene skriptene ikke kjenner, og den veien ligger bak en bryter som slår den av øyeblikkelig.
For dem som bestiller dem, tar en attest nå 2–3 minutter i stedet for 2–3 uker, og koster EUR 99 i stedet for EUR 200–300. AI-en er med vilje den minste delen av rørledningen: skript er billige og forutsigbare der de virker, og modellen brukes der bare det å lese som et menneske duger.
Hvordan anslår du driftskostnaden for din egen agent?
Før du ber om et tilbud, skriv ned fem tall:
- Oppgaver per måned. Meldinger, dokumenter, kjøringer.
- Modellkall per oppgave, og hvilken modell hver trenger. De fleste oppgaver trenger ikke toppmodellen.
- Tokens per kall. Systemprompt, historikk, dokumenter. Her vokser kostnadene stille.
- De andre målerne. Proxyer per MB, betalte API-er per kall, servere per kjerne.
- Et tak for hver jobb. En dollargrense per kjøring i koden, ikke bare en månedsgrense på kontoen.
Legg så til kostnaden ingen oppgir: en test på ekte data i uke én, varsler for stille feil og noen som leser dem.
Hva disse tallene ikke forteller deg
Takene over er grenser jeg satte, ikke beløp som ble brukt, og modelltabellen viser listepriser, ikke mine fakturaer. Hvert prosjekttall kommer fra ett system og én periode. Modellpriser endrer seg ofte, så sjekk leverandørenes gjeldende prissider før du planlegger. Og ingenting av dette sier hvor lang tid byggene tok eller hva de kostet å bygge; det avhenger av integrasjonene langt mer enn av AI-en.
Hvis du planlegger en agent og vil sammenligne notater om hva den kommer til å koste i drift, ser jeg gjerne på tallene dine. Siden min om AI-agentutvikling viser hvordan jeg jobber, og eiendomsattest-caset, sendelyd-caset og reisepris-caset viser tre av disse byggene mer i detalj. For en bot på WhatsApp veier kanalgebyrene ofte tyngre enn modellen; jeg regnet dem ut per land i hva en WhatsApp-chatbot for bedrifter koster.
Kilder
- Anthropic, Claude Agent SDK-alternativer:
max_turnsogmax_budget_usdstopper en kjøring; hvert resultat rapporterertotal_cost_usd. - OpenRouter, modellistepriser og plattformgebyrer, lest 15. oktober 2026.
- Anthropic, Claude-priser, og Google, Gemini API-priser, lest 15. oktober 2026: merknaden om tokenizeren og prisendringen for Gemini 4 Argon.
- Alle prosjekttall: prosjektenes egne konfigurasjonsfiler, commit-meldinger og målte kjøringer, 2026.