In breve
Quanto costa un agente IA? Tre voci: le chiamate al modello, i sistemi che l’agente comanda e le protezioni che gli impediscono di fallire in silenzio. Il modello scelto pesa di più sul conto dei token: mille passaggi identici di un agente costano USD 0,46 con DeepSeek V4.1 Flash, USD 0,65 con Claude Haiku 5.5 e USD 26 con Claude Opus 5.5. In quattro sistemi che ho costruito quest’anno, le chiamate al modello erano anche la voce più facile da limitare: USD 0,05 per un controllo in background, al massimo USD 2,10 per una ricerca completa. Il traffico proxy di un’esecuzione di benchmark dei prezzi è costato USD 3,08, e le brutte sorprese sono stati i guasti che nessuno ha visto, come un’interruzione durata 8 giorni prima che qualcuno se ne accorgesse.
Sono Denys, ingegnere full-stack e di IA. La maggior parte degli articoli su questo tema dà intervalli molto ampi, senza alcun progetto dietro. Qui sotto trova i contatori di quattro sistemi che ho costruito e che faccio girare, con la fonte di ogni numero: file di configurazione, messaggi di commit ed esecuzioni misurate. Quando un numero è un tetto che ho impostato e non una fattura pagata, lo dico.
Quanto costa far girare un agente IA e per cosa si paga?
Tre contatori, e il modello è solo uno di essi.
| Progetto | Cosa fa l’IA | Costo del modello per unità | Cos’altro pesa sul conto |
|---|---|---|---|
| Agente personale | Chatta su Telegram, lavora su CRM ed e-mail, fa ricerche sul web | Da USD 0,00065 a 0,026 per passaggio, secondo il modello; tetti da USD 0,05 a 2,10 per esecuzione | Un server, più i nuovi tentativi e i watchdog |
| Benchmark dei prezzi per un’agenzia di viaggi | Un altro agente IA avvia i benchmark tramite un server MCP | Zero da parte mia: quell’agente paga i propri token | Traffico proxy, circa USD 3,08 per esecuzione, e un server a 8 core |
| Controllo audio di trasmissioni in diretta | Rileva il parlato e la lingua parlata su ogni canale | Zero per chiamata: due piccoli modelli girano sul computer del sito | CPU: una demo a 32 canali ha usato circa 0,9 di un server cloud a 2 core |
| Certificati immobiliari | Legge portali sconosciuti come farebbe una persona | Token solo per i portali che gli script non conoscono | Gli script gestiscono il portale noto senza alcun token |
Lo schema si è ripetuto in tutti e quattro: il token più economico è quello che non si invia mai, e le ore costose vanno nelle parti attorno al modello.
Quanto costano le chiamate al modello?
L’assistente è l’unico dei quattro in cui il conto del modello è mio. Gira sul Claude Agent SDK di Anthropic, e ogni agente ha un tetto rigido nel codice. L’SDK ferma l’esecuzione quando raggiunge il limite di turni o il limite in dollari.
| Compito | Modello | Tetto per esecuzione |
|---|---|---|
| Controllo in background a riposo | Claude Haiku 4.5 | USD 0,05, e USD 1,00 al giorno in totale |
| Ricerca: dividere la domanda | Claude Opus 4.6 | USD 0,10, 1 turno |
| Ricerca: tre ricercatori in parallelo | Claude Opus 4.6 | USD 0,50 ciascuno, 3 turni, ricerca e lettura sul web |
| Ricerca: scrivere la risposta | Claude Opus 4.6 | USD 0,50, 1 turno |
| Conversazione principale | Haiku, Sonnet o Opus, vedi sotto | 200 turni o USD 50, una rete di sicurezza e non una previsione |
Una ricerca completa costa quindi al massimo USD 0,10 + 3 × 0,50 + 0,50 = USD 2,10. È un tetto, non una media; il costo reale di un’esecuzione dipende dal modello, che la sezione successiva quantifica.
Due scelte hanno ridotto il conto più di qualsiasi calo di prezzo:
- Indirizzare ogni messaggio al modello più economico in grado di gestirlo. I messaggi brevi e semplici vanno a Haiku, quelli medi a Sonnet, quelli a più passaggi a Opus. Il router legge parole chiave e lunghezza del messaggio, quindi l’instradamento stesso non costa alcuna chiamata al modello. All’inizio, ogni agente girava su Opus.
- Eliminare le chiamate che non servono. Il controllo in background chiedeva al modello un rapporto di stato a ogni ciclo. Non aveva accesso a e-mail né a CRM, quindi poteva solo scrivere messaggi che nessuno voleva. Ho tolto del tutto la chiamata al modello. Il tetto giornaliero di USD 1,00 è ancora nella configurazione, e non protegge più nulla.
Una lacuna, con onestà: l’SDK riporta il costo di ogni chiamata, e io non l’ho mai salvato. Il totale mensile sta nella console di Anthropic, non nell’app. Se lo rifacessi, registrerei il costo per chiamata dal primo giorno, per vedere quale compito spende il denaro e non solo quanto.
Quanto cambia il conto la scelta del modello?
Più di ogni altra cosa sul lato token. Qui sotto un passaggio di agente è calcolato su modelli diversi. Il passaggio è di circa 4.000 token in ingresso e 500 in uscita, la stima per chiamata scritta nel codice stesso dell’assistente per il suo controllo in background. I prezzi sono il listino di OpenRouter del 15 ottobre 2026. OpenRouter inoltra il prezzo di listino di ogni fornitore e trattiene la propria commissione quando si acquistano crediti (5,5% sul piano standard), non per richiesta.
| Modello | Prezzo per milione di token, in / out | Un passaggio | 1.000 passaggi |
|---|---|---|---|
| DeepSeek V4.1 Flash | USD 0,024 / 0,72 | USD 0,00046 | USD 0,46 |
| Claude Haiku 5.5, GPT-6 Luna | USD 0,10 / 0,50 | USD 0,00065 | USD 0,65 |
| Qwen3.8 Flash | USD 0,15 / 0,47 | USD 0,00083 | USD 0,83 |
| Mistral Small 4 | USD 0,15 / 0,60 | USD 0,00090 | USD 0,90 |
| Llama 4 Maverick | USD 0,188 / 0,652 | USD 0,0011 | USD 1,08 |
| Gemini 3.5 Flash Lite | USD 0,30 / 2,50 | USD 0,0025 | USD 2,45 |
| DeepSeek V4 Pro | USD 0,955 / 1,911 | USD 0,0048 | USD 4,78 |
| Gemini 3.8 Flash | USD 0,75 / 3,75 | USD 0,0049 | USD 4,88 |
| Grok 4.7 | USD 2 / 6 | USD 0,011 | USD 11 |
| Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon | USD 2 / 10 | USD 0,013 | USD 13 |
| Claude Opus 5.5 | USD 4 / 20 | USD 0,026 | USD 26 |
| Claude Fable 5.1, GPT-6 Astra | USD 10 / 50 | USD 0,065 | USD 65 |
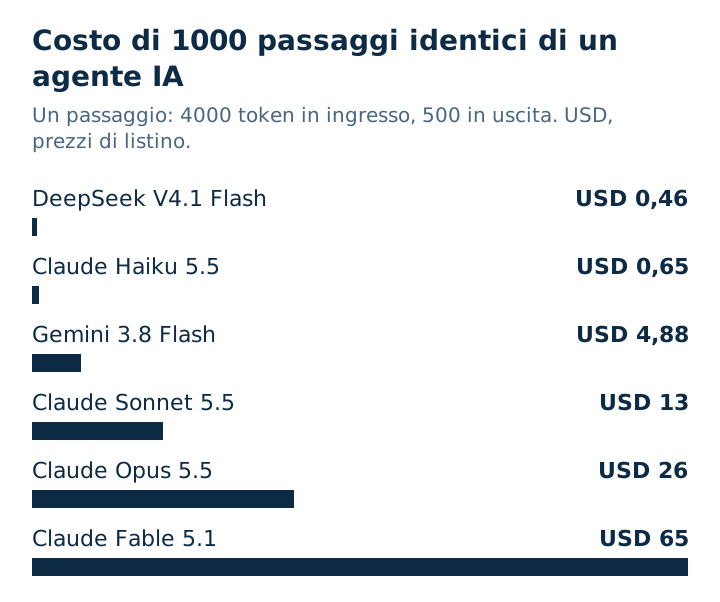
Lo stesso lavoro costa da USD 0,46 a USD 65 per mille passaggi, una differenza di circa 140 volte. Ne seguono tre cose:
- Un modello piccolo gestisce la maggior parte dei passaggi. Smistare un messaggio, estrarre campi da un documento, rispondere da un testo noto: raramente serve un modello di punta. Tenga i modelli grandi per la pianificazione e i ragionamenti difficili, come fa l’instradamento descritto sopra.
- I prezzi cambiano in fretta. L’assistente girava su Claude Haiku 4.5, Sonnet 4.6 e Opus 4.6. Sul listino di oggi, il passaggio costa USD 0,0065 su Haiku 4.5 e USD 0,00065 su Haiku 5.5. Anthropic segnala che i suoi modelli più recenti contano circa il 30% di token in più per lo stesso testo; per passaggio, il più recente resta quindi quasi otto volte più economico. Gemini 4 Argon di Google raddoppierà il prezzo il 1° dicembre 2026. Ricontrolli prima di pianificare un anno.
- Confronti i compiti, non i prezzi dei token. Un modello più economico che richiede due tentativi, o un prompt più lungo per comportarsi bene, può costare di più per compito completato. Misuri un campione di compiti reali su due o tre modelli prima di scegliere.
La sua stima è una riga sola: passaggi per compito × compiti al mese × prezzo del passaggio del suo modello.
Perché il vero problema era il contesto e non il prezzo per token?
Il prezzo per token è prevedibile. Il contesto no. I bug che hanno fatto male a questo assistente riguardavano tutti quanto testo entrava in ogni chiamata:
- Le sessioni lunghe rovinavano le risposte. Per rispondere più in fretta, l’app teneva aperta una sessione calda tra un messaggio e l’altro. Quando il contesto traboccava, il modello restituiva un testo confuso, in alfabeti misti. La correzione: riciclare la sessione dopo 20 messaggi e riprovare in una sessione nuova quando una risposta sembra rotta.
- Un checkpoint salvato è diventato troppo grande. Un giorno le chiamate sono fallite con “Prompt is too long”. Il checkpoint iniettato in ogni chiamata ora è limitato a 2 KB.
- Il prompt di sistema portava con sé file usati di rado. Caricare le competenze solo quando un messaggio le richiede ha risparmiato circa 3.000 token per chiamata, e togliere tre file di riferimento dal precaricamento circa altri 1.500. Sono stime tratte dalle note di commit, non righe di fattura.
- La cronologia era più lunga del necessario. La cronologia della chat inviata a ogni chiamata è passata da 20 messaggi a 10.
Ognuna di queste correzioni abbassa il costo e rende le risposte più rapide allo stesso tempo. Tratti il contesto come un budget, come tratta il denaro.
Quanto costa l’infrastruttura che un agente comanda?
Nel benchmark dei prezzi di viaggio, la parte di IA è un agente separato. Avvia i benchmark tramite un server MCP che ho costruito, e i suoi token sono fatturati a chi esegue quell’agente. Ciò che il benchmark paga di suo è lo scraping che sta dietro: proxy residenziali e un server pieno di browser.
Numeri misurati su quel sistema:
- Traffico proxy: un’esecuzione su due siti di viaggi ha usato circa 935 MB, circa USD 3,08, all’incirca 0,23 MB per riga di prezzo salvata.
- Blocco dei tracker: su un sito, bloccare gli script di tracciamento ha ridotto il traffico da 4,2 MB a 2,5 MB per ricerca, con prezzi identici in tutte e sei le prove.
- Nessun browser dove non serve: i prezzi di un sito si potevano leggere con un normale client HTTP che imita un browser mobile. La raccolta è passata da 8 a 43 date al minuto su cinque worker, e il codice del browser per quel sito è stato eliminato.
- La CPU, non la memoria, decide la taglia del server: con 20 browser su un server a 8 core, il carico era circa 30 mentre 6-7 GB di RAM restavano liberi. Un browser attivo occupa circa 345 MB. Dimensioni il server sui core.
Se il suo agente comanda browser, proxy o API a pagamento, quei contatori probabilmente supereranno il conto del modello. Li misuri per compito prima di scegliere un modello.
Quando l’IA in locale costa meno di un’API?
Quando i dati non devono uscire dall’edificio e il modello è piccolo. Il progetto di trasmissione controlla canali audio in diretta durante eventi sportivi: silenzio, disturbi, un commentatore che passa alla lingua sbagliata. Inviare a un’API ogni secondo di audio costerebbe a ogni chiamata e aggiungerebbe ritardo.
Invece, due modelli aperti girano sul computer della sede: uno rileva il parlato, l’altro riconosce la lingua. Insieme occupano circa 24 MB di pesi, il rilevatore di parlato aggiunge circa 7 MB di RAM e non c’è alcun costo per chiamata. In una demo a 32 canali, analizzare ogni canale in tempo reale ha usato circa 0,9 di un server cloud a 2 core.
Il compromesso è una precisione che si deve dimostrare da soli. Su un set pubblico di parlato letto e pulito, 30 clip da tre secondi per lingua, il modello della lingua aveva ragione nel 93,3% dei casi per il portoghese e almeno nel 96,7% per spagnolo, inglese e francese. È un tetto, non una previsione: rumore del pubblico e musica sotto un commentatore non sono mai stati misurati, perché non era disponibile audio di un vero circuito di trasmissione.
Quanto costa rendere un agente sicuro da lasciare solo?
È il costo che la maggior parte delle stime salta, ed è dove sono andate le mie ore. Alcuni guasti reali:
- Un’interruzione silenziosa di 8 giorni. Un altro progetto sullo stesso server ha aggiornato una cache del browser condivisa. Il pool dello scraper è passato da 40 browser funzionanti a 0, i lavori sono rimasti bloccati senza errori e nessun allarme ha avvisato nessuno. La correzione era piccola: dare allo scraper una cache del browser propria. Trovare la causa ha richiesto 8 giorni, perché non c’era alcun allarme sullo stato del pool.
- Un lavoro “riuscito” senza nulla. Un’esecuzione ha percorso 359 date in 12 minuti, ha salvato 0 righe e ha dichiarato successo. Ora i lavori si fermano dopo 25 date vuote di fila e dicono perché.
- Un’esecuzione fermata che continuava a spendere. Un benchmark segnato come fermato è andato avanti per 4 ore, consumando traffico proxy per tutto il tempo.
- Il limite del proxy ha svuotato il pool. Quando il piano proxy ha raggiunto il limite di traffico, il pool è passato da 40 browser a 0 in 12 minuti ed è rimasto così fino a un riavvio. Ora si riempie da solo ogni 60 secondi, con un’attesa crescente fino a 5 minuti.
- Troppi allarmi il primo giorno. La prima prova dello strumento di trasmissione su un vero flusso a 16 canali, di 49 minuti, ha prodotto 3.492 eventi. Il 92,4% erano rumore e avvisi di cambio voce, e l’operatore ha premuto Cancella 182 volte in 27 minuti. I rilevatori andavano bene; le soglie non avevano mai incontrato audio di programma reale. La correzione è stata un interruttore per profilo, non una nuova matematica.
- Chiamate bloccate e limiti di frequenza. L’assistente ha ora un watchdog di 120 secondi per una chiamata che tace, un limite di 300 secondi per l’intera chiamata e fino a 3 nuovi tentativi dopo 30 secondi, 2 minuti e 5 minuti quando l’API è sovraccarica o limitata. Una chiamata a uno strumento bloccata non passa ai modelli di riserva, perché un modello più lento non sblocca uno strumento inceppato.
Niente di tutto questo compare nel prezzo di un token. Compare in ore, e nella fiducia persa quando l’agente dice “fatto” e sbaglia. Lo metta a budget: una prima prova su dati reali, allarmi per ciò che può tacere e controlli che un “successo” abbia prodotto qualcosa.
Dove ha senso l’IA quando gli script fanno quasi tutto?
Ai margini. Il servizio di certificati immobiliari raccoglie i documenti dagli account online degli amministratori di immobili e costruisce il certificato che serve a chi vende. Uno script gestisce il principale portale noto, dove il 95% dei documenti viene completato. L’IA di visione legge solo i portali che gli script non conoscono, e quel percorso sta dietro un interruttore che lo spegne subito.
Per chi li ordina, un certificato ora richiede da 2 a 3 minuti invece di 2-3 settimane, e costa EUR 99 invece di EUR 200-300. L’IA è volutamente la parte più piccola della catena: gli script sono economici e prevedibili dove funzionano, e il modello si usa dove serve solo una lettura da persona.
Come stimare il costo di esercizio del suo agente?
Prima di chiedere un preventivo, annoti cinque numeri:
- Compiti al mese. Messaggi, documenti, esecuzioni.
- Chiamate al modello per compito, e quale modello per ciascuna. La maggior parte dei compiti non richiede il modello di punta.
- Token per chiamata. Prompt di sistema, cronologia, documenti. È qui che i costi crescono in silenzio.
- Gli altri contatori. Proxy a MB, API a pagamento a chiamata, server a core.
- Un tetto per ogni lavoro. Un limite in dollari per esecuzione nel codice, non solo un limite mensile sull’account.
Poi aggiunga il costo che nessuno quota: una prova su dati reali nella prima settimana, allarmi per i guasti silenziosi e qualcuno che li legga.
Cosa non dicono questi numeri?
I tetti qui sopra sono limiti che ho impostato, non quanto è stato speso, e la tabella dei modelli riporta prezzi di listino, non le mie fatture. Ogni numero di progetto viene da un solo sistema e da un solo periodo. I prezzi dei modelli cambiano spesso, quindi controlli le pagine dei prezzi dei fornitori prima di pianificare. E nulla di tutto questo dice quanto tempo hanno richiesto i progetti o quanto sono costati da costruire; dipende dalle integrazioni molto più che dall’IA.
Se sta pianificando un agente e vuole confrontare le stime sul costo di esercizio, guardo volentieri i suoi numeri. La mia pagina sullo sviluppo di agenti IA mostra come lavoro, e il caso dei certificati immobiliari, il caso dell’audio in diretta e il caso dei prezzi di viaggio descrivono tre di questi progetti nel dettaglio. Per un bot su WhatsApp, le tariffe del canale spesso superano il modello; le ho calcolate paese per paese in quanto costa un chatbot WhatsApp con IA.
Fonti
- Anthropic, opzioni del Claude Agent SDK:
max_turnsemax_budget_usdfermano un’esecuzione; ogni risultato riportatotal_cost_usd. - OpenRouter, prezzi di listino dei modelli e commissioni della piattaforma, consultati il 15 ottobre 2026.
- Anthropic, prezzi di Claude, e Google, prezzi dell’API Gemini, consultati il 15 ottobre 2026: la nota sul tokenizer e la variazione di prezzo di Gemini 4 Argon.
- Tutti i numeri dei progetti: i file di configurazione, i messaggi di commit e le esecuzioni misurate dei progetti, 2026.