En bref
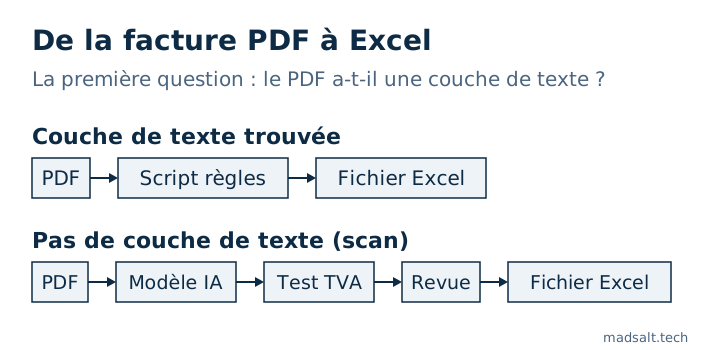
Vérifiez d’abord si le PDF a une couche de texte. Si oui, un court script sans IA a lu juste les 30 factures de mon test, l’en-tête et les 113 lignes de facture, avec une médiane de 0,03 seconde par facture. Sur un scan, le même script ne renvoie rien, et il faut un modèle. Dans le passage que je rapporte, Claude Haiku 5.5 a lu justes le HT, la TVA et le TTC sur les 30 scans, mais il a mal lu des chiffres dans les numéros de TVA, les numéros de facture et les désignations, ainsi que deux montants de ligne : 4 factures sur 30 entièrement justes, 12 si l’on ignore les caractères qui se ressemblent. Les contrôles arithmétiques ont détecté 2 des 18 factures fausses. La clé de contrôle du numéro de TVA en a détecté 16 sur 18, et 17 sur 18 avec les contrôles arithmétiques.
Je suis Denys, ingénieur full-stack et IA. Je voulais savoir ce qui marche quand on transforme une facture PDF en Excel, et à quelle fréquence le résultat est faux. J’ai donc fait le travail moi-même, de bout en bout, sur 30 factures fictives de fournisseurs comme celles de mon test précédent de quatre modèles d’IA : 10 tchèques, 10 allemandes et 10 portugaises, 113 lignes de facture au total. Les noms d’entreprise portent des mots d’exemple (Vzor, Muster, Beispiel, Exemplo), chaque facture a un pied de page SAMPLE, et les numéros de TVA ont été vérifiés dans le service VIES de l’UE, qui a répondu « non valide » pour tous. Cette fois, ce sont des PDF, avec les lignes de facture en plus, et le résultat est un classeur Excel.
Comment distinguer un PDF texte d’un scan ?
Un PDF sorti d’un logiciel de comptabilité contient le texte lui-même : c’est une couche de texte. Un PDF scanné est l’image d’une page enveloppée dans un fichier PDF, sans aucun texte. Si vous pouvez sélectionner un mot avec la souris, c’est un PDF texte.
J’ai fabriqué les deux versions de chaque facture, soit 60 PDF. Les 30 PDF texte avaient tous une couche de texte. Sur les 30 scans, une bibliothèque PDF a extrait 0 caractère. Les scans sont ma simulation du test précédent (rotation, flou, bruit, forte compression JPEG), pas du papier passé au scanner.
Comment extraire les données d’une facture PDF texte sans IA ?
On peut le faire avec un script. J’ai écrit un script Python avec pdfplumber, une bibliothèque gratuite qui lit la couche de texte : un jeu de libellés par langue, les numéros de TVA repérés par moitié de page (fournisseur à gauche, acheteur à droite) et une expression régulière par ligne de facture. Il fait 94 lignes pour 3 mises en page.
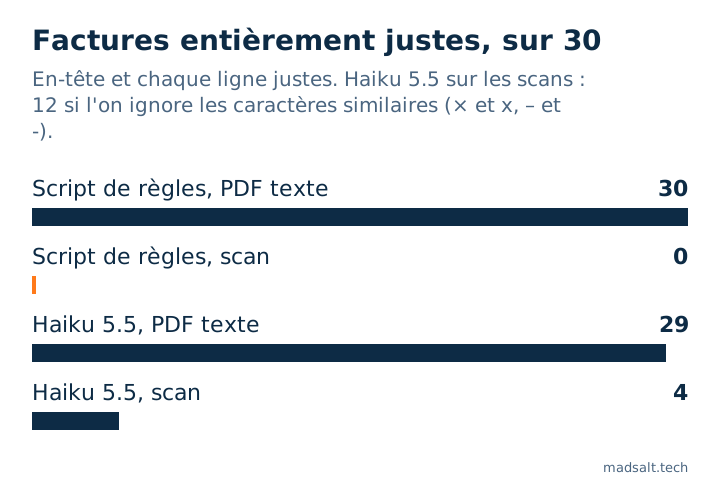
Résultat sur les PDF texte : 30 factures sur 30 entièrement justes, 0 faux parmi les 270 champs d’en-tête, 113 lignes sur 113 justes, une médiane de 0,03 seconde par facture et aucun coût.
La réserve est importante. J’ai écrit les règles en regardant ces mêmes 30 factures, c’est donc le meilleur cas possible pour des règles. Chaque nouvelle mise en page de fournisseur demande de nouvelles règles, et je n’en ai testé aucune autre. Deux points que les règles ont dû gérer :
- L’ordre de lecture. Sur les 30 factures, dans les trois mises en page, le numéro de TVA de l’acheteur vient avant celui du fournisseur dans la couche de texte, donc « prendre le premier numéro de TVA » les inverse. Le script lit séparément les moitiés gauche et droite de la page.
- Le préfixe du numéro de TVA. Les factures portugaises impriment le numéro avec ou sans
PT. Je compare sans le préfixe : 8 factures ne diffèrent de la valeur exacte que par cela.
Que se passe-t-il quand le PDF est un scan : faut-il un OCR ?
Le script échoue sans un bruit. Sur les 30 scans, extract_text() a renvoyé une chaîne vide à chaque fois, l’appel a réussi et les 270 champs d’en-tête sont revenus vides. Aucune erreur n’a été levée.
Pour les scans, j’ai envoyé chaque PDF à Claude Haiku 5.5 via OpenRouter, qui lit le PDF directement, sans étape d’OCR séparée. Température 0, un JSON par facture : les neuf champs d’en-tête plus les lignes de facture (désignation, quantité, prix unitaire, montant).
| Méthode et entrée | Factures entièrement justes | Lignes justes |
|---|---|---|
| Script, PDF texte | 30 sur 30 | 113 sur 113 |
| Script, scan | 0 sur 30 | 0 sur 113 |
| Haiku 5.5, PDF texte | 29 sur 30 | 112 sur 113 |
| Haiku 5.5, scan, exact | 4 sur 30 | 76 sur 113 |
| Haiku 5.5, scan, caractères similaires ignorés | 12 sur 30 | 108 sur 113 |
« Entièrement juste » veut dire que les neuf champs d’en-tête et chaque ligne de facture correspondent. Sur les PDF texte, la seule erreur de Haiku était une désignation, Europaletten pour Europalette ; son en-tête était juste sur 30 sur 30. Sur les scans, 14 factures sur 30 avaient leurs neuf champs d’en-tête justes.
Qu’est-ce que le modèle a mal lu sur les scans ?
Surtout pas l’argent. Date d’émission, date d’échéance, devise, total HT, TVA et total TTC : 0 faux sur les 30 factures dans ce passage. Quantité, prix unitaire et montant : 111 sur 113 justes. Les erreurs portaient surtout sur du texte :
- En-tête : 21 champs faux dans 16 factures, tous dans des numéros de TVA. Numéro de TVA du fournisseur 6 fois, numéro de TVA de l’acheteur 15 fois.
- Lignes de facture : 37 sur 113 pas exactement justes. 32 ne diffèrent que par la typographie :
×renvoyé enx,–en-,µ(signe micro) enμ(mu grec). 5 sont de vraies erreurs de lecture : 3 désignations (fita estirávelpourfilme estirável, toutes sur une même facture portugaise) et 2 montants (184,00lu164,00,1.376,67lu1.378,67).
Pourquoi les contrôles arithmétiques sont-ils restés presque muets ?
J’ai mis deux contrôles dans le classeur sous forme de colonnes : les lignes de facture s’additionnent au total HT, et HT plus TVA égale TTC, à 0,01 près. Sur les scans du modèle, ils ont signalé 2 des 18 factures réellement fausses (2 sur 26 si l’on compte la typographie comme fausse), les deux avec un montant de ligne mal lu. Les montants d’en-tête étaient justes, donc les sommes tenaient. Un contrôle sur les nombres ne peut pas voir un chiffre faux dans un identifiant ou un mot. Le test précédent avait trouvé le même schéma : son contrôle des totaux a signalé 3 des 63 factures fausses.
Sur la sortie vide du script, les deux contrôles se sont déclenchés pour 30 factures sur 30. Une extraction qui ne renvoie rien échoue au moins bruyamment dans le tableur.
Un troisième contrôle, la clé de contrôle du numéro de TVA (python-stdnum pour le DIČ tchèque, l’USt-IdNr allemand et le NIF portugais), a détecté 16 des 18 factures fausses et n’a donné aucune fausse alerte sur une facture juste. Aucun numéro de TVA faux ne l’a passée. Avec les contrôles arithmétiques, cela fait 17 sur 18. La dernière était une facture portugaise où seules des désignations étaient mal lues ; elle demande une personne qui a le PDF ouvert à côté de la ligne.
À quoi doit ressembler le fichier Excel ?
Deux feuilles. Invoices a une ligne par facture : nom du fichier, numéro de facture, dates d’émission et d’échéance, numéros de TVA du fournisseur et de l’acheteur, devise, HT, TVA et TTC, nombre de lignes et somme des lignes, et les trois colonnes de contrôle. Lines a une ligne par ligne de facture : nom du fichier, numéro de facture, numéro de ligne, désignation, quantité, prix unitaire et montant. Le numéro de facture les relie. Une seule ligne à plat par facture ne marche pas, parce que le nombre de lignes varie et que ma plus longue facture en compte neuf.
Les nombres entrent comme des nombres et les dates comme des dates. Un 175 011,84 Kč tchèque ou un 10.465,61 € allemand doit être converti avant l’écriture, sinon Excel le traite comme du texte et une somme l’ignore. J’ai rouvert le fichier enregistré et vérifié le type de 2 256 cellules : les dates, les montants, les quantités et les résultats des contrôles avaient tous le bon type, et 0 était stocké comme du texte. 300 autres cellules étaient vides : les lignes où le script n’avait rien trouvé.
J’ai relu le fichier avec une bibliothèque et je ne l’ai ouvert ni dans Excel ni dans LibreOffice, et les contrôles sont des valeurs VRAI ou FAUX, pas des formules.
Combien ça coûte et combien de temps ça prend ?
Le script ne coûte rien et prend 0,03 seconde par facture. Pour Haiku 5.5, j’ai pris le coût facturé par OpenRouter pour chaque appel :
| Haiku 5.5 | USD pour 1 000 factures | Secondes médianes par facture |
|---|---|---|
| PDF texte | 0,58 | 2,96 |
| Scan | 0,72 | 4,31 |
| Les deux | 0,65 | 3,66 |
L’ensemble des essais a fait 60 appels et USD 0,038847 (133 197 tokens en entrée, 51 055 en sortie), sans appel échoué, sans nouvelle tentative et sans réponse illisible. Les durées incluent le réseau et le raisonnement du modèle, avec 8 appels en parallèle.
Qu’est-ce qui fait bouger le résultat sur les scans ?
Le même modèle sur les mêmes scans ne donne pas un seul chiffre. Pour voir ce qui compte, j’ai répété le test sur scans avec cet ensemble : seulement les scans, température 0, deux répétitions par condition, 240 appels de plus pour USD 0,145779. Les conditions étaient l’entrée (la page en image, ou le PDF) et le prompt (les neuf champs d’en-tête, ou l’en-tête plus les lignes). Factures dont les neuf champs d’en-tête sont justes, sur 30 :
| Condition | Passage 1 | Passage 2 |
|---|---|---|
| Image, en-tête seul | 13 | 14 |
| Image, en-tête et lignes | 14 | 14 |
| PDF, en-tête seul | 13 | 13 |
| PDF, en-tête et lignes | 15 | 12 |
Le passage que je rapporte plus haut est un cinquième passage PDF avec en-tête et lignes : 14. Le test à quatre modèles sur image a aussi donné 14 à Haiku sur ces scans.
- Chemin d’entrée : pas d’effet visible. Les passages image ont donné 13, 14, 14, 14 et 14 (moyenne 13,8), les passages PDF 13, 13, 15, 12 et 14 (moyenne 13,4). Les plages se recoupent presque entièrement.
- Taille du prompt : pas d’effet visible. L’en-tête seul a donné 13, 14, 13 et 13 ; l’en-tête et les lignes 14, 14, 15, 12 et 14.
- D’un passage à l’autre : 0 à 3 factures d’écart entre les répétitions d’une même condition.
- L’ensemble de factures est le facteur le plus important. Avec le même modèle et le même prompt sur image, un ensemble précédent de 30 factures a donné 22 et 22. Celui-ci donne 13 et 14. Chaque pays a un numéro de TVA d’acheteur répété sur 10 factures, et sur cet ensemble Haiku le lit mal sur 11 à 13 factures sur 30 par passage image (sur l’ensemble précédent, 2 à 3). Une seule chaîne mal lue fait bouger jusqu’à 10 factures à la fois. Avec deux ensembles et un seul modèle, cela montre que l’ensemble pèse plus que les deux autres effets, pas pourquoi une chaîne donnée est difficile à lire.
- Les montants peuvent être faux. Dans 4 des 8 passages répétés, au moins un montant était faux. Les contrôles de sommes ont signalé 2 de ces 4 factures ; 2 sont restées silencieuses. Le passage que je rapporte n’avait aucun montant d’en-tête faux, donc « surtout pas l’argent » y est vrai, mais pas dans tous les passages.
Qu’est-ce que je n’ai pas testé ?
- L’import propre à Excel (Power Query « À partir d’un PDF », Données à partir d’une image).
- De vraies factures de fournisseurs. Les 30 sont fictives : 3 mises en page, une police, une page chacune.
- Les factures de plusieurs pages, d’autres langues, les photos et le vrai bruit de scanner.
- Un OCR qui alimente le script de règles. La référence sur scan est le script seul.
- Un autre modèle que Haiku 5.5.
- Les règles sur une mise en page pour laquelle elles n’ont pas été ajustées.
Que ferais-je avec de vraies factures ?
C’est ma lecture des chiffres, pas un résultat mesuré. Vérifiez d’abord la couche de texte. Pour quelques fournisseurs avec des PDF texte, des règles sont moins chères, plus rapides et, dans ce test, exactes. Pour de nombreuses mises en page ou des mises en page inconnues, ou pour des scans, utilisez un modèle, lancez la clé de contrôle du numéro de TVA et les contrôles arithmétiques, et faites regarder par une personne ce qu’ils signalent ainsi que les désignations, qu’aucun de mes contrôles ne couvre.
Les scripts, les factures, les fichiers de référence, les résultats et le classeur sont dans cette archive. Les 60 PDF et les réponses brutes du modèle y sont, donc la notation et le classeur se reconstruisent sans clé d’API. Mon prototype d’extraction de factures tourne sur des données d’exemple.
Si vous cherchez encore quelle partie de votre entreprise vaut la peine d’être automatisée, je vous aide à la choisir puis je la construis : voir Consultant IA pour PME. Les messages clients sont l’autre premier chantier IA courant dans une petite entreprise : combien coûte un chatbot WhatsApp avec IA par réponse, frais de Meta compris.
À lire aussi: Logiciel de gestion documentaire PME : 7 outils chiffrés.
Mon cas similaire
J’ai construit un service qui transforme une attestation immobilière qui prenait 2 à 3 semaines et coûtait EUR 200–300 en une attestation qui prend 2 à 3 minutes et coûte EUR 99, avec des scripts et de l’IA de vision. La construction est dans le cas de l’automatisation des documents immobiliers.
Si les factures doivent arriver dans votre tableur ou votre outil de comptabilité sans que personne les ressaisisse, je construis cela dans l’automatisation des processus.
Vous reportez des factures à la main dans un tableur ? Écrivez-moi et nous trouverons la meilleure option pour vous.
Vous reportez encore les factures à la main ?
Dites-moi ce que vous avez aujourd'hui et ce qu'il vous faut. Je vous répondrai avec l'option que je choisirais.
Me contacter