Kurz gesagt
Prüfen Sie zuerst, ob das PDF eine Textschicht hat. Wenn ja, las ein kurzes Skript ohne KI alle 30 meiner Testrechnungen richtig, Kopfdaten und alle 113 Positionen, in 0,03 Sekunden je Rechnung im Median. Bei einem Scan liefert dasselbe Skript nichts, und Sie brauchen ein Modell. In dem Lauf, über den ich berichte, las Claude Haiku 5.5 bei allen 30 Scans die Summen für netto, Umsatzsteuer und brutto richtig, verlas sich aber bei Ziffern in USt-IdNrn., Rechnungsnummern und Beschreibungen sowie bei zwei Positionsbeträgen: 4 von 30 Rechnungen ganz richtig, 12, wenn ähnlich aussehende Zeichen ignoriert werden. Die Rechenprüfungen fanden 2 der 18 falschen Rechnungen. Eine Prüfziffer-Kontrolle der USt-IdNr. fand 16 der 18, zusammen mit den Rechenprüfungen 17 von 18.
Ich bin Denys, Full-Stack- und KI-Entwickler. Ich wollte wissen, was funktioniert, wenn man eine PDF-Rechnung in Excel überträgt, und wie oft das Ergebnis falsch ist. Also habe ich die Aufgabe selbst durchgespielt, von Anfang bis Ende, mit 30 fiktiven Lieferantenrechnungen wie denen aus meinem früheren Test mit vier KI-Modellen: 10 tschechische, 10 deutsche und 10 portugiesische, zusammen 113 Positionen. Die Firmennamen tragen Beispielwörter (Vzor, Muster, Beispiel, Exemplo), jede Rechnung hat eine SAMPLE-Fußzeile, und die USt-IdNrn. wurden im VIES-Dienst der EU geprüft, der bei allen mit „nicht gültig“ antwortete. Dieser Test nutzt PDFs, ergänzt die Positionen und endet in einer Excel-Arbeitsmappe.
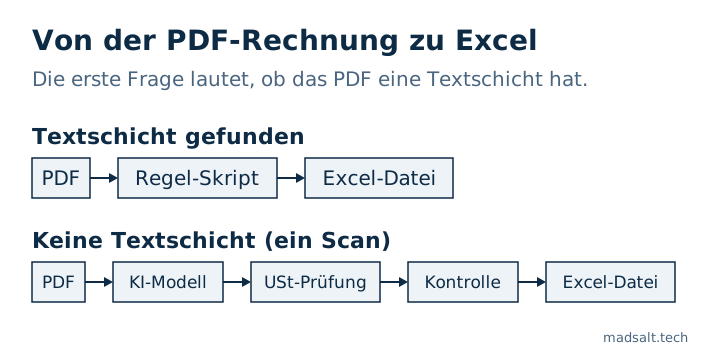
Woran erkennen Sie, ob ein PDF Text enthält oder ein Scan ist?
Ein PDF, das aus einer Buchhaltungssoftware stammt, enthält den Text selbst, eine Textschicht. Ein gescanntes PDF ist das Bild einer Seite in einer PDF-Datei, ohne Text darin. Wenn Sie mit der Maus ein Wort markieren können, ist es ein Text-PDF.
Ich habe von jeder Rechnung beide Arten erzeugt, zusammen 60 PDFs. Alle 30 Text-PDFs hatten eine Textschicht. Aus allen 30 Scans holte eine PDF-Bibliothek 0 Zeichen. Die Scans sind meine Simulation aus dem früheren Test (Drehung, Unschärfe, Rauschen, starke JPEG-Kompression), kein Papier aus einem Scanner.
Wie bekommen Sie eine PDF-Rechnung ohne KI in Excel?
Mit einem Skript, wenn das PDF eine Textschicht hat. Ich habe ein Python-Skript mit pdfplumber geschrieben, einer kostenlosen Bibliothek, die die Textschicht liest: ein Satz Beschriftungen je Sprache, USt-IdNrn. nach Seitenhälfte gefunden (Lieferant links, Käufer rechts) und ein regulärer Ausdruck je Positionszeile. Es sind 94 Zeilen für 3 Layouts.
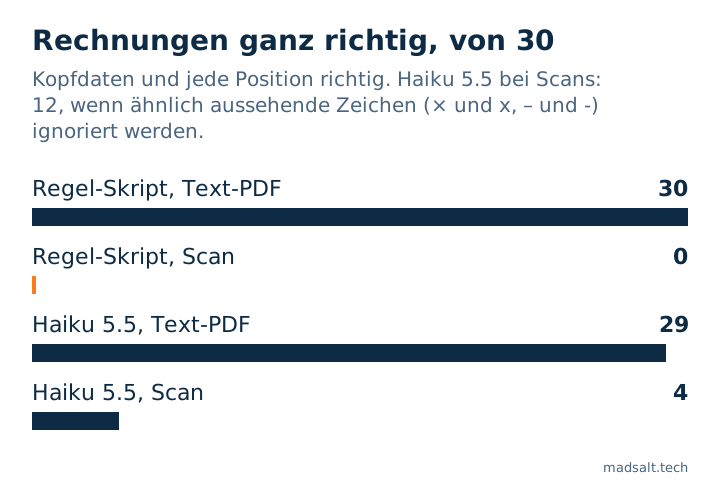
Ergebnis auf den Text-PDFs: 30 von 30 Rechnungen ganz richtig, 0 falsche unter den 270 Kopffeldern, 113 von 113 Positionen richtig, im Median 0,03 Sekunden je Rechnung und keine Kosten.
Der Vorbehalt ist groß. Ich habe die Regeln geschrieben, während ich genau diese 30 Rechnungen vor mir hatte; das ist also der Bestfall für Regeln. Jedes neue Lieferanten-Layout braucht neue Regeln, und ich habe kein anderes Layout getestet. Zwei Dinge, die die Regeln bewältigen mussten:
- Lesereihenfolge. Bei allen 30 Rechnungen, in allen drei Layouts, steht die USt-IdNr. des Käufers in der Textschicht vor der des Lieferanten, deshalb vertauscht „nimm die erste USt-IdNr.“ die beiden. Das Skript liest die linke und die rechte Seitenhälfte getrennt.
- Präfix der USt-IdNr. Portugiesische Rechnungen drucken die Nummer mit oder ohne
PT. Ich vergleiche ohne Präfix: 8 Rechnungen weichen nur darin vom wahren Wert ab.
Was passiert, wenn die PDF-Rechnung ein Scan ist?
Das Skript scheitert lautlos. Bei den 30 Scans gab extract_text() jedes Mal einen leeren String zurück, der Aufruf gelang, und alle 270 Kopffelder kamen leer zurück. Nichts löste einen Fehler aus.
Für Scans schickte ich jedes PDF über OpenRouter an Claude Haiku 5.5, das das PDF direkt liest, ohne separaten OCR-Schritt. Temperatur 0, ein JSON je Rechnung: die neun Kopffelder plus die Positionen (Beschreibung, Menge, Einzelpreis, Betrag).
| Methode und Eingabe | Rechnungen ganz richtig | Positionen richtig |
|---|---|---|
| Skript, Text-PDF | 30 von 30 | 113 von 113 |
| Skript, Scan | 0 von 30 | 0 von 113 |
| Haiku 5.5, Text-PDF | 29 von 30 | 112 von 113 |
| Haiku 5.5, Scan, exakt | 4 von 30 | 76 von 113 |
| Haiku 5.5, Scan, ähnliche Zeichen ignoriert | 12 von 30 | 108 von 113 |
„Ganz richtig“ heißt: Die neun Kopffelder und jede Position stimmen. Bei den Text-PDFs war der eine Fehler von Haiku eine Beschreibung, Europaletten statt Europalette; seine Kopfdaten waren bei 30 von 30 richtig. Bei den Scans hatten 14 von 30 Rechnungen alle neun Kopffelder richtig.
Welche Rechnungsdaten las das Modell bei den Scans falsch?
Meistens nicht das Geld. Rechnungsdatum, Fälligkeitsdatum, Währung, Netto, Umsatzsteuer und Brutto: 0 Fehler bei allen 30 Rechnungen in diesem Lauf. Menge, Einzelpreis und Betrag: 111 von 113 richtig. Die Fehler betrafen überwiegend Text:
- Kopfdaten: 21 falsche Felder in 16 Rechnungen, alle in USt-IdNrn. USt-IdNr. des Lieferanten 6-mal, USt-IdNr. des Käufers 15-mal.
- Positionen: 37 von 113 nicht exakt richtig. 32 unterscheiden sich nur typografisch:
×alsxzurückgegeben,–als-,µ(Mikro-Zeichen) alsμ(griechisches My). 5 sind echte Fehllesungen: 3 Beschreibungen (fita estirávelstattfilme estirável, alle auf einer portugiesischen Rechnung) und 2 Beträge (184,00als164,00gelesen,1.376,67als1.378,67).
Warum blieben die Rechenprüfungen fast stumm?
Ich habe zwei Prüfungen als Spalten in die Arbeitsmappe aufgenommen: Die Positionen ergeben zusammen die Nettosumme, und netto plus Umsatzsteuer ergibt brutto, jeweils auf 0,01 genau. Bei den Scans des Modells markierten sie 2 der 18 wirklich falschen Rechnungen (2 von 26, wenn Typografie als falsch zählt), die beiden mit einem falsch gelesenen Positionsbetrag. Die Beträge der Kopfdaten waren richtig, also stimmten die Summen. Eine Prüfung auf Zahlen kann eine falsche Ziffer in einer Kennung oder einem Wort nicht sehen. Der frühere Test zeigte dasselbe Muster: Seine Summenprüfung markierte 3 von 63 falschen Rechnungen.
Bei der leeren Ausgabe des Skripts schlugen beide Prüfungen bei 30 von 30 an. Eine Auslesung, die nichts liefert, scheitert in der Tabelle wenigstens laut.
Eine dritte Prüfung, die Prüfziffer der USt-IdNr. (python-stdnum für die tschechische DIČ, die deutsche USt-IdNr. und die portugiesische NIF), fand 16 der 18 falschen Rechnungen und gab bei keiner richtigen Rechnung Fehlalarm. Keine falsche USt-IdNr. bestand sie. Zusammen mit den Rechenprüfungen sind das 17 von 18. Die eine übrige war eine portugiesische Rechnung, bei der nur Beschreibungen falsch gelesen wurden; sie braucht einen Menschen, der das PDF neben der Zeile geöffnet hat.
Wie sollte die Excel-Datei aufgebaut sein?
Zwei Blätter. Invoices hat eine Zeile je Rechnung: Dateiname, Rechnungsnummer, Rechnungs- und Fälligkeitsdatum, USt-IdNr. von Lieferant und Käufer, Währung, Netto, Umsatzsteuer und Brutto, Anzahl der Positionen und Positionssumme sowie die drei Prüfspalten. Lines hat eine Zeile je Position: Dateiname, Rechnungsnummer, Positionsnummer, Beschreibung, Menge, Einzelpreis und Betrag. Die Rechnungsnummer verbindet beide. Eine flache Zeile je Rechnung funktioniert nicht, weil die Zahl der Positionen schwankt und meine längste Rechnung neun hat.
Zahlen kommen als Zahlen in die Datei, Datumsangaben als Datum. Ein tschechisches 175 011,84 Kč oder ein deutsches 10.465,61 € muss vor dem Schreiben umgewandelt werden, sonst behandelt Excel es als Text, und eine Summe ignoriert es. Ich habe die gespeicherte Datei erneut geöffnet und den Typ von 2.256 Zellen geprüft: Datumsangaben, Beträge, Mengen und die Prüfergebnisse hatten alle den richtigen Typ, und 0 waren als Text gespeichert. Weitere 300 Zellen waren leer, die Zeilen, in denen das Skript nichts fand.
Ich habe die Datei mit einer Bibliothek zurückgelesen und nicht in Excel oder LibreOffice geöffnet, und die Prüfungen sind Wahrheitswerte (TRUE oder FALSE), keine Formeln.
Was kostet das, und wie lange dauert es?
Das Skript kostet nichts und braucht 0,03 Sekunden je Rechnung. Für Haiku 5.5 habe ich die von OpenRouter abgerechneten Kosten je Aufruf verwendet:
| Haiku 5.5 | USD je 1.000 Rechnungen | Median Sekunden je Rechnung |
|---|---|---|
| Text-PDF | 0,58 | 2,96 |
| Scan | 0,72 | 4,31 |
| Beide zusammen | 0,65 | 3,66 |
Der ganze Lauf waren 60 Aufrufe und USD 0,038847 (133.197 Tokens Eingabe, 51.055 Ausgabe), ohne fehlgeschlagenen Aufruf, ohne Wiederholung und ohne unlesbare Antwort. Die Zeiten enthalten das Netzwerk und das Nachdenken des Modells, bei 8 gleichzeitigen Aufrufen.
Was beeinflusst das Scan-Ergebnis?
Dasselbe Modell liefert bei denselben Scans nicht eine einzige Zahl. Um zu sehen, worauf es ankommt, habe ich den Scan-Test mit diesem Satz wiederholt: nur die Scans, Temperatur 0, zwei Wiederholungen je Bedingung, 240 weitere Aufrufe für USD 0,145779. Die Bedingungen waren die Eingabe (die Seite als Bild oder das PDF) und der Prompt (die neun Kopffelder oder Kopfdaten plus Positionen). Rechnungen mit allen neun Kopffeldern richtig, von 30:
| Bedingung | Lauf 1 | Lauf 2 |
|---|---|---|
| Bild, nur Kopfdaten | 13 | 14 |
| Bild, Kopfdaten und Positionen | 14 | 14 |
| PDF, nur Kopfdaten | 13 | 13 |
| PDF, Kopfdaten und Positionen | 15 | 12 |
Der Lauf, über den ich oben berichte, ist ein fünfter PDF-Lauf mit Kopfdaten und Positionen: 14. Der Bildtest mit vier Modellen ergab für Haiku bei diesen Scans ebenfalls 14.
- Eingabeweg: kein sichtbarer Effekt. Bildläufe ergaben 13, 14, 14, 14 und 14 (Mittel 13,8), PDF-Läufe 13, 13, 15, 12 und 14 (Mittel 13,4). Die Bereiche überlappen sich fast vollständig.
- Promptgröße: kein sichtbarer Effekt. Nur Kopfdaten ergab 13, 14, 13 und 13; Kopfdaten und Positionen 14, 14, 15, 12 und 14.
- Von Lauf zu Lauf: 0 bis 3 Rechnungen zwischen Wiederholungen einer Bedingung.
- Der Rechnungssatz ist der größte Faktor. Mit demselben Modell und demselben Bild-Prompt ergab ein früherer Satz von 30 Rechnungen 22 und 22. Dieser ergibt 13 und 14. In jedem Land wird eine USt-IdNr. des Käufers auf 10 Rechnungen wiederholt, und bei diesem Satz liest Haiku sie je Bildlauf auf 11 bis 13 von 30 Rechnungen falsch (beim früheren Satz auf 2 bis 3). Eine falsch gelesene Zeichenfolge betrifft bis zu 10 Rechnungen auf einmal. Mit zwei Sätzen und einem Modell zeigt das, dass der Satz die beiden anderen Effekte überwiegt, nicht, warum eine bestimmte Zeichenfolge schwer lesbar ist.
- Beträge können falsch sein. In 4 der 8 Wiederholungsläufe war mindestens ein Betrag falsch. Die Summenprüfungen markierten 2 dieser 4 Rechnungen; 2 blieben unbemerkt. Der Lauf, über den ich berichte, hatte keinen falschen Betrag in den Kopfdaten, „meistens nicht das Geld“ gilt dort also, aber nicht in jedem Lauf.
Was habe ich nicht getestet?
- Den eigenen Import von Excel (Power Query „From PDF“, „Data from Picture“).
- Echte Lieferantenrechnungen. Alle 30 sind fiktiv: 3 Layouts, eine Schrift, je eine Seite.
- Mehrseitige Rechnungen, andere Sprachen, Fotos und echtes Scannerrauschen.
- OCR als Vorstufe für das Regel-Skript. Die Scan-Basis ist das Skript allein.
- Jedes andere Modell als Haiku 5.5.
- Regeln auf einem Layout, auf das sie nicht abgestimmt waren.
Was würde ich bei echten Rechnungen tun?
Das ist meine Lesart der Zahlen, kein gemessenes Ergebnis. Prüfen Sie zuerst die Textschicht. Bei wenigen Lieferanten mit Text-PDFs sind Regeln billiger, schneller und in diesem Test exakt. Bei vielen oder unbekannten Layouts oder bei Scans nehmen Sie ein Modell, lassen die Prüfziffer der USt-IdNr. und die Rechenprüfungen laufen und lassen einen Menschen ansehen, was sie markieren, sowie die Beschreibungen, die keine meiner Prüfungen abdeckt.
Die Skripte, die Rechnungen, die Wahrheitsdateien, die Ergebnisse und die Arbeitsmappe stehen in diesem Archiv. Die 60 PDFs und die rohen Modellantworten liegen darin, sodass sich die Auswertung und die Arbeitsmappe ohne API-Schlüssel neu erzeugen lassen. Mein Prototyp zum Auslesen von Rechnungen läuft mit Beispieldaten.
Wenn Sie noch klären, welcher Teil Ihres Unternehmens sich zu automatisieren lohnt, helfe ich Ihnen bei der Auswahl und baue ihn anschließend: siehe KI-Beratung für den Mittelstand. Kundennachrichten sind die andere häufige erste KI-Aufgabe in einem kleinen Unternehmen: was ein WhatsApp-Chatbot mit KI pro Antwort kostet, Metas Gebühr eingerechnet.
Siehe auch: Dokumentenmanagement für kleine Unternehmen: DE und CH.
Mein ähnlicher Fall
Ich habe einen Service gebaut, der aus einer Immobilienbescheinigung, die 2–3 Wochen dauerte und EUR 200–300 kostete, eine macht, die 2–3 Minuten dauert und EUR 99 kostet, mit Skripten und Vision-KI. Der Bau steht in der Fallstudie zur Automatisierung von Immobiliendokumenten.
Wenn die Rechnungen ohne Abtippen in Ihrer Tabelle oder Buchhaltungssoftware landen sollen, baue ich das in der Workflow-Automatisierung.
Sie übertragen Rechnungen von Hand in eine Tabelle? Schreiben Sie mir, und wir finden die beste Lösung für Sie.
Rechnungen noch von Hand übertragen?
Schreiben Sie mir, was Sie jetzt haben und was Sie brauchen. Ich antworte mit der Option, die ich wählen würde.
Schreiben Sie mir