TL;DR
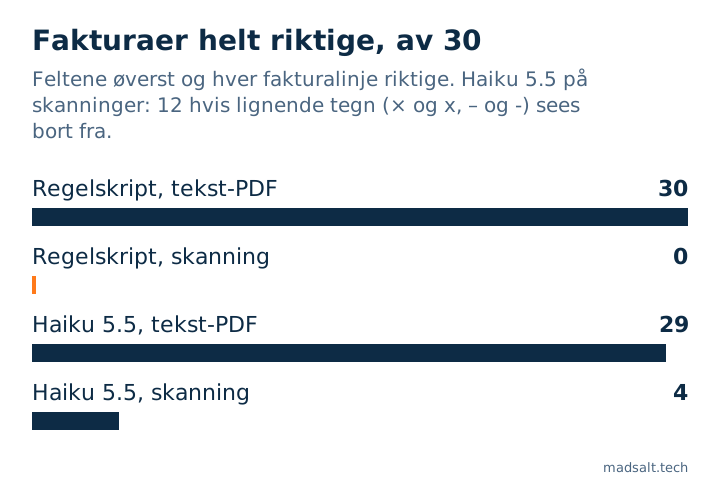
Skal du hente en faktura fra PDF til Excel, sjekk først om PDF-en har et tekstlag. Har den det, leste et kort skript uten KI alle de 30 testfakturaene mine riktig, både feltene øverst og alle 113 fakturalinjer, med en median på 0,03 sekunder per faktura. På en skanning gir det samme skriptet ingenting, og da trenger du en modell. I kjøringen jeg rapporterer leste Claude Haiku 5.5 netto-, MVA- og bruttototalen riktig på alle 30 skanninger, men leste sifre feil i MVA-numre, fakturanumre og beskrivelser, samt to linjebeløp: 4 av 30 fakturaer helt riktige, 12 hvis man ser bort fra tegn som ligner hverandre. De aritmetiske kontrollene fanget 2 av de 18 feilaktige fakturaene. Et kontrollsiffer på MVA-nummeret fanget 16 av de 18, og 17 av 18 sammen med de aritmetiske kontrollene.
Jeg er Denys, fullstack- og AI-ingeniør. Jeg ville vite hva som virker når man henter data fra en faktura i PDF og legger dem i Excel, og hvor ofte det går galt. Så jeg kjørte jobben selv, fra ende til annen, på 30 fiktive leverandørfakturaer som de i den forrige testen min av fire KI-modeller: 10 tsjekkiske, 10 tyske, 10 portugisiske, til sammen 113 fakturalinjer. Firmanavnene inneholder eksempelord (Vzor, Muster, Beispiel, Exemplo), hver faktura har en SAMPLE-bunntekst, og MVA-numrene er slått opp i EUs VIES-tjeneste, som svarte “ikke gyldig” for alle. Denne gangen er det PDF-er, fakturalinjene er med, og resultatet ender i en Excel-arbeidsbok.
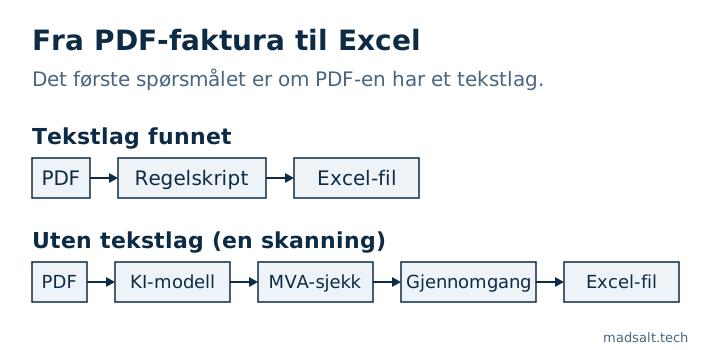
Hvordan ser du om en PDF er tekst eller en skanning?
En PDF som er skrevet ut fra et regnskapsprogram, inneholder selve teksten, et tekstlag. En skannet PDF er et bilde av en side pakket inn i en PDF-fil, uten tekst i. Kan du markere et ord med musen, er det en tekst-PDF.
Jeg laget begge typene av hver faktura, 60 PDF-er til sammen. Alle 30 tekst-PDF-ene hadde et tekstlag. Fra alle 30 skanningene hentet et PDF-bibliotek 0 tegn. Skanningene er min simulering fra den forrige testen (rotasjon, uskarphet, støy, kraftig JPEG-komprimering), ikke papir gjennom en skanner.
Kan du få en faktura fra PDF til Excel uten KI?
Ja. Jeg skrev et Python-skript med pdfplumber, et gratis bibliotek som leser tekstlaget: ett sett med etiketter per språk, MVA-numre funnet ved å lese sidens to halvdeler hver for seg (leverandør til venstre, kjøper til høyre) og et regulært uttrykk per fakturalinje. Det er 94 linjer for 3 layouter.
Resultat på tekst-PDF-ene: 30 av 30 fakturaer helt riktige, 0 feil blant de 270 feltene øverst på fakturaene, 113 av 113 fakturalinjer riktige, en median på 0,03 sekunder per faktura og ingen kostnad.
Forbeholdet er stort. Jeg skrev reglene mens jeg så på akkurat disse 30 fakturaene, så dette er beste tilfelle for regler. Hver ny leverandørlayout trenger nye regler, og jeg testet ingen andre layouter. To ting reglene måtte håndtere:
- Lesrekkefølge. På alle 30 fakturaer, i alle tre layoutene, kommer kjøperens MVA-nummer før leverandørens i tekstlaget, så «ta det første MVA-nummeret» bytter dem om. Skriptet leser venstre og høyre halvdel av siden hver for seg.
- Prefiks på MVA-nummeret. Portugisiske fakturaer skriver nummeret med eller uten
PT. Jeg sammenligner uten prefikset: 8 fakturaer avviker bare på det punktet fra den riktige verdien.
Hva skjer når PDF-en er en skanning, og trenger du faktura-OCR?
Skriptet svikter uten en lyd. På de 30 skanningene returnerte extract_text() en tom streng hver gang, kallet lyktes, og alle 270 feltene øverst på fakturaene kom tilbake tomme. Ingen feil ble kastet.
For skanninger sendte jeg hver PDF til Claude Haiku 5.5 via OpenRouter, som leser PDF-en direkte uten et eget OCR-trinn. Temperatur 0, ett JSON-svar per faktura: de ni feltene øverst pluss fakturalinjene (beskrivelse, antall, enhetspris, beløp).
| Metode og input | Fakturaer helt riktige | Fakturalinjer riktige |
|---|---|---|
| Skript, tekst-PDF | 30 av 30 | 113 av 113 |
| Skript, skanning | 0 av 30 | 0 av 113 |
| Haiku 5.5, tekst-PDF | 29 av 30 | 112 av 113 |
| Haiku 5.5, skanning, nøyaktig | 4 av 30 | 76 av 113 |
| Haiku 5.5, skanning, lignende tegn sett bort fra | 12 av 30 | 108 av 113 |
«Helt riktig» betyr at de ni feltene øverst og hver eneste fakturalinje stemmer. På tekst-PDF-ene var Haikus ene bom en beskrivelse, Europaletten i stedet for Europalette; feltene øverst var riktige på 30 av 30. På skanningene hadde 14 av 30 fakturaer alle ni feltene øverst riktige.
Hva leste modellen feil på skanningene?
For det meste ikke pengene. Fakturadato, forfallsdato, valuta, netto, MVA og brutto: 0 feil på tvers av alle 30 fakturaene i denne kjøringen. Antall, enhetspris og beløp: 111 av 113 riktige. Feilene var for det meste tekst:
- Feltene øverst: 21 feil felt i 16 fakturaer, alle i MVA-numre. Leverandørens MVA-nummer 6 ganger, kjøperens MVA-nummer 15 ganger.
- Fakturalinjer: 37 av 113 ikke helt riktige. 32 avviker bare typografisk:
×returnert somx,–som-,µ(mikrotegnet) somμ(gresk my). 5 er ekte feillesinger: 3 beskrivelser (fita estiráveli stedet forfilme estirável, alle på én portugisisk faktura) og 2 beløp (184,00lest som164,00,1.376,67som1.378,67).
Hvorfor var de aritmetiske kontrollene nesten stille?
Jeg la to kontroller inn i arbeidsboken som kolonner: fakturalinjene summerer seg til nettototalen, og netto pluss MVA er lik brutto, begge innenfor 0,01. På modellens skanninger flagget de 2 av de 18 fakturaene som egentlig var feil (2 av 26 når typografi regnes som feil), de to med et feillest linjebeløp. Beløpene øverst var riktige, så summene stemte. En kontroll på tall kan ikke se et feil siffer i en identifikator eller et ord. Den forrige testen fant det samme mønsteret: totalsjekken der flagget 3 av 63 feilaktige fakturaer.
På skriptets tomme utdata slo begge kontrollene ut for 30 av 30. Et uttrekk som ikke gir noe, svikter i det minste høylytt i regnearket.
En tredje kontroll, et kontrollsiffer på MVA-nummeret (python-stdnum for det tsjekkiske DIČ, det tyske USt-IdNr. og det portugisiske NIF), fanget 16 av de 18 feilaktige fakturaene og ga ikke falsk alarm på noen riktig. Ingen feil MVA-nummer besto den. Sammen med de aritmetiske kontrollene er det 17 av 18. Den ene som var igjen, var en portugisisk faktura der bare beskrivelser var feillest, og den trenger en person med PDF-en åpen ved siden av raden.
Hvordan bør Excel-filen se ut?
To ark. Invoices har én rad per faktura: filnavn, fakturanummer, fakturadato og forfallsdato, leverandørens og kjøperens MVA-nummer, valuta, netto, MVA og brutto, antall linjer og linjesum, og de tre kontrollkolonnene. Lines har én rad per fakturalinje: filnavn, fakturanummer, linjenummer, beskrivelse, antall, enhetspris og beløp. Fakturanummeret knytter dem sammen. Én flat rad per faktura fungerer ikke, fordi antallet linjer varierer, og den lengste fakturaen min har ni.
Tall skal inn som tall og datoer som datoer. Et tsjekkisk 175 011,84 Kč eller et tysk 10.465,61 € må konverteres før det skrives, ellers behandler Excel det som tekst, og en sum hopper over det. Jeg åpnet den lagrede filen igjen og kontrollerte typen på 2 256 celler: datoer, beløp, antall og kontrollresultater hadde alle riktig type, og 0 var lagret som tekst. Ytterligere 300 celler var tomme, nemlig radene der skriptet ikke fant noe.
Jeg leste filen tilbake med et bibliotek og åpnet den ikke i Excel eller LibreOffice, og kontrollene er verdiene TRUE eller FALSE, ikke formler.
Hva koster det, og hvor lang tid tar det?
Skriptet koster ingenting og tar 0,03 sekunder per faktura. For Haiku 5.5 brukte jeg OpenRouters fakturerte kostnad per kall:
| Haiku 5.5 | USD per 1 000 fakturaer | Median sekunder per faktura |
|---|---|---|
| Tekst-PDF | 0,58 | 2,96 |
| Skanning | 0,72 | 4,31 |
| Begge samlet | 0,65 | 3,66 |
Hele kjøringen var 60 kall og USD 0,038847 (133 197 tokens inn, 51 055 ut), uten ett eneste mislykket kall, gjenforsøk eller svar som ikke lot seg lese. Tidene inkluderer nettverk og modellens resonnering, med 8 kall i gang samtidig.
Hva påvirker skanningsresultatet?
Den samme modellen på de samme skanningene gir ikke ett tall. For å se hva som betyr noe gjentok jeg skanningstesten på dette settet: bare skanningene, temperatur 0, to gjentakelser per betingelse, 240 kall til for USD 0,145779. Betingelsene var inputen (siden som bilde eller som PDF) og prompten (de ni feltene øverst, eller feltene pluss fakturalinjer). Fakturaer med alle ni feltene øverst riktige, av 30:
| Betingelse | Kjøring 1 | Kjøring 2 |
|---|---|---|
| Bilde, bare feltene øverst | 13 | 14 |
| Bilde, felter og fakturalinjer | 14 | 14 |
| PDF, bare feltene øverst | 13 | 13 |
| PDF, felter og fakturalinjer | 15 | 12 |
Kjøringen jeg rapporterer ovenfor er en femte PDF-kjøring med felter og fakturalinjer: 14. Firemodellstesten med bilder ga også Haiku 14 på disse skanningene.
- Inputveien: ingen synlig effekt. Bildekjøringene ga 13, 14, 14, 14 og 14 (gjennomsnitt 13,8), PDF-kjøringene 13, 13, 15, 12 og 14 (gjennomsnitt 13,4). Spennene overlapper nesten helt.
- Promptens størrelse: ingen synlig effekt. Bare feltene øverst ga 13, 14, 13 og 13; felter og fakturalinjer 14, 14, 15, 12 og 14.
- Fra kjøring til kjøring: 0 til 3 fakturaer mellom gjentakelser av samme betingelse.
- Fakturasettet er den største faktoren. Med samme modell og samme bildeprompt ga et tidligere sett med 30 fakturaer 22 og 22. Dette gir 13 og 14. Hvert land har ett kjøper-MVA-nummer som gjentas på 10 fakturaer, og på dette settet leser Haiku det feil på 11 til 13 av 30 fakturaer per bildekjøring (på det tidligere settet 2 til 3). Én feillest tallrekke flytter opptil 10 fakturaer på én gang. Med to sett og én modell viser dette at settet veier tyngre enn de to andre effektene, ikke hvorfor en gitt tallrekke er vanskelig å lese.
- Beløp kan gå galt. I 4 av de 8 gjentatte kjøringene var minst ett beløp feil. Sumkontrollene flagget 2 av de 4 fakturaene; 2 forble stille. Kjøringen jeg rapporterer hadde ikke noe feil beløp øverst, så «for det meste ikke pengene» gjelder der, men ikke i hver kjøring.
Hva testet jeg ikke?
- Excels egen import (Power Query «Fra PDF», Data fra bilde).
- Ekte leverandørfakturaer. Alle 30 er fiktive: 3 layouter, én skrifttype, én side hver.
- Fakturaer på flere sider, andre språk, bilder tatt med mobil og ekte skannerstøy.
- OCR som leverer teksten til regelskriptet. Grunnlinjen for skanninger er skriptet alene.
- Andre modeller enn Haiku 5.5.
- Regler på en layout de ikke var tilpasset.
Hva ville jeg gjort med ekte fakturaer?
Dette er min lesning av tallene, ikke et målt resultat. Sjekk tekstlaget først. For noen få leverandører med tekst-PDF-er er regler billigere, raskere og i denne testen nøyaktige. For mange eller ukjente layouter, eller for skanninger, bruk en modell, kjør kontrollsifferet på MVA-nummeret og de aritmetiske kontrollene, og la en person se på det som flagges og på beskrivelsene, som ingen av kontrollene mine dekker.
Skriptene, fakturaene, fasitfilene, resultatene og arbeidsboken ligger i dette arkivet. De 60 PDF-ene og de rå modellsvarene ligger inni, så skåringen og arbeidsboken kan bygges på nytt uten en API-nøkkel. Min prototype for fakturauttrekk kjører på eksempeldata.
Hvis du fortsatt vurderer hvilken del av virksomheten som er verdt å automatisere, hjelper jeg deg å velge den og bygger den etterpå: se AI-konsulent for små bedrifter. Kundemeldinger er den andre vanlige første jobben for AI i en liten bedrift: hva en WhatsApp-chatbot med AI koster per svar, med Metas gebyr regnet med.
Se også: Dokumenthåndteringssystem for små bedrifter: 8 priset.
Mitt tilsvarende tilfelle
Jeg bygde en tjeneste som gjør en eiendomsattest som tok 2–3 uker og kostet EUR 200–300 om til en som tar 2–3 minutter og koster EUR 99, med skript og vision-AI. Byggingen står i caset om automatisering av eiendomsdokumenter.
Skal fakturaene nå regnearket eller regnskapsverktøyet ditt uten at noen skriver dem inn på nytt, bygger jeg det under prosessautomatisering.
Flytter du fakturaer inn i et regneark for hånd? Skriv til meg, så finner vi det beste alternativet for deg.
Flytter du fortsatt fakturaer for hånd?
Fortell meg hva du har nå og hva du trenger. Jeg svarer med alternativet jeg selv ville valgt.
Skriv til meg