Em resumo
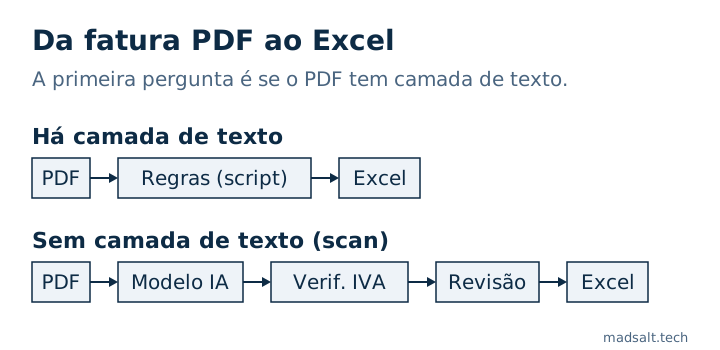
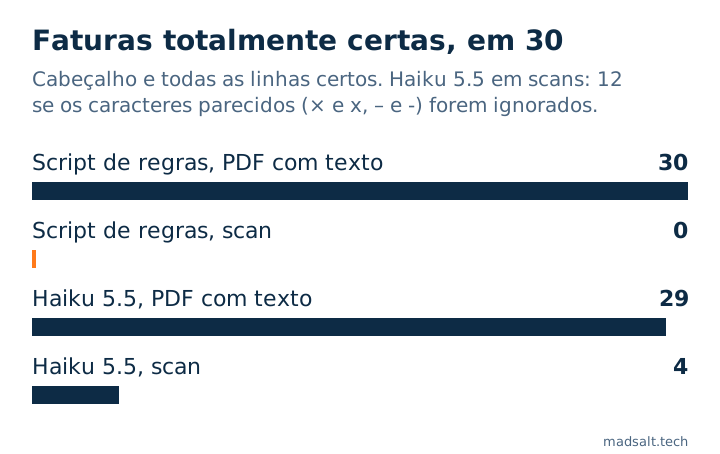
Primeiro veja se o PDF tem camada de texto. Se tiver, um script curto, sem IA, leu certas todas as 30 faturas de teste, cabeçalho e todas as 113 linhas, com uma mediana de 0,03 segundos cada. Num scan o mesmo script não devolve nada e é preciso um modelo. Na execução que apresento, o Claude Haiku 5.5 acertou os totais líquido, IVA e bruto nos 30 scans, mas leu mal dígitos em números de IVA, números de fatura e descrições, e dois valores de linhas: 4 de 30 faturas totalmente certas, 12 se se ignorarem caracteres parecidos. As verificações aritméticas apanharam 2 das 18 faturas erradas. O dígito de controlo do número de IVA apanhou 16 das 18, e 17 de 18 em conjunto com as verificações aritméticas.
Sou o Denys, engenheiro full-stack e de IA. Queria saber o que funciona para converter uma fatura PDF em Excel, isto é, extrair dados de PDF para Excel, e com que frequência falha. Por isso fiz o trabalho de ponta a ponta com 30 faturas fictícias de fornecedores como as do meu teste anterior com quatro modelos de IA: 10 checas, 10 alemãs e 10 portuguesas, 113 linhas no total. Os nomes das empresas trazem palavras de exemplo (Vzor, Muster, Beispiel, Exemplo), cada fatura tem um rodapé SAMPLE e os números de IVA foram verificados no serviço VIES da UE, que respondeu “não válido” para todos. Desta vez em PDF, com as linhas de artigos, e a terminar num ficheiro Excel.
Como distinguir um PDF com texto de um scan?
Um PDF gerado por um programa de contabilidade contém o próprio texto, uma camada de texto. Um PDF digitalizado é a imagem de uma página dentro de um ficheiro PDF, sem texto. Se consegue selecionar uma palavra com o rato, é um PDF com texto.
Fiz as duas versões de cada fatura, 60 PDF. Os 30 PDF com texto tinham todos camada de texto. Dos 30 scans, uma biblioteca de PDF extraiu 0 caracteres. Os scans são a minha simulação do teste anterior (rotação, desfoque, ruído, compressão JPEG forte), não papel passado num scanner.
Dá para converter uma fatura PDF em Excel sem IA?
Sim. Escrevi um script em Python com o pdfplumber, uma biblioteca gratuita que lê a camada de texto: um conjunto de rótulos por idioma, números de IVA encontrados por metade da página (fornecedor à esquerda, comprador à direita) e uma expressão regular por linha de artigo. São 94 linhas para 3 layouts.
Resultado nos PDF com texto: 30 de 30 faturas totalmente certas, 0 erros nos 270 campos de cabeçalho, 113 de 113 linhas certas, uma mediana de 0,03 segundos por fatura e sem custo.
A ressalva é grande. Escrevi as regras a olhar para estas mesmas 30 faturas, por isso este é o melhor caso para regras. Cada novo layout de fornecedor precisa de regras novas, e não testei nenhum outro layout. Duas coisas que as regras tiveram de tratar:
- Ordem de leitura. Nas 30 faturas, nos três layouts, o número de IVA do comprador vem antes do do fornecedor na camada de texto, por isso “pegar no primeiro número de IVA” troca-os. O script lê as metades esquerda e direita da página em separado.
- Prefixo do número de IVA. As faturas portuguesas imprimem o número com ou sem
PT. Comparo sem o prefixo: 8 faturas só diferem do valor verdadeiro por isso.
Como extrair dados de PDF para Excel quando o PDF é um scan?
Com o script, não: falha em silêncio. Nos 30 scans, extract_text() devolveu sempre um texto vazio, a chamada correu bem e os 270 campos de cabeçalho vieram vazios. Nada levantou erro.
Para os scans enviei cada PDF ao Claude Haiku 5.5 através da OpenRouter, que lê o PDF diretamente, sem passo de OCR separado. Temperatura 0, um JSON por fatura: os nove campos de cabeçalho mais as linhas (descrição, quantidade, preço unitário, valor).
| Método e entrada | Faturas totalmente certas | Linhas certas |
|---|---|---|
| Script, PDF com texto | 30 de 30 | 113 de 113 |
| Script, scan | 0 de 30 | 0 de 113 |
| Haiku 5.5, PDF com texto | 29 de 30 | 112 de 113 |
| Haiku 5.5, scan, exato | 4 de 30 | 76 de 113 |
| Haiku 5.5, scan, ignorando caracteres parecidos | 12 de 30 | 108 de 113 |
“Totalmente certa” quer dizer que os nove campos de cabeçalho e todas as linhas coincidem. Nos PDF com texto, a única falha do Haiku foi uma descrição, Europaletten em vez de Europalette; o cabeçalho esteve certo em 30 de 30. Nos scans, 14 de 30 faturas tinham os nove campos de cabeçalho certos.
O que o modelo errou nos scans?
Quase nunca o dinheiro. Data de emissão, data de vencimento, moeda, líquido, IVA e bruto: 0 erros nas 30 faturas nesta execução. Quantidade, preço unitário e valor: 111 de 113 certos. Os erros foram sobretudo de texto:
- Cabeçalho: 21 campos errados em 16 faturas, todos em números de IVA. Número de IVA do fornecedor 6 vezes, do comprador 15 vezes.
- Linhas: 37 de 113 não exatamente certas. 32 diferem só na tipografia:
×devolvido comox,–como-,µ(símbolo micro) comoμ(mu grego). 5 são leituras erradas a sério: 3 descrições (fita estirávelem vez defilme estirável, todas numa fatura portuguesa) e 2 valores (184,00lido como164,00,1.376,67como1.378,67).
Porque é que as verificações aritméticas ficaram quase em silêncio?
Pus duas verificações no ficheiro como colunas: as linhas somam o total líquido, e líquido mais IVA é igual ao bruto, ambas com uma tolerância de 0,01. Nos scans do modelo assinalaram 2 das 18 faturas realmente erradas (2 de 26 se a tipografia contar como erro), as duas com um valor de linha mal lido. Os valores do cabeçalho estavam certos, por isso as somas batiam. Uma verificação sobre números não vê um dígito errado num identificador ou numa palavra. O teste anterior encontrou o mesmo padrão: a sua verificação dos totais assinalou 3 de 63 faturas erradas.
Com a saída vazia do script, as duas verificações dispararam em 30 de 30. Uma extração que não devolve nada falha, pelo menos, de forma audível na folha de cálculo.
Uma terceira verificação, o dígito de controlo do número de IVA (python-stdnum para o DIČ checo, o USt-IdNr. alemão e o NIF português), apanhou 16 das 18 faturas erradas e não deu alarme falso numa fatura certa. Nenhum número de IVA errado a passou. Em conjunto com as verificações aritméticas são 17 de 18. A que sobrou foi uma fatura portuguesa em que só as descrições foram mal lidas, e precisa de uma pessoa com o PDF aberto ao lado da linha.
Como deve ser o ficheiro Excel?
Duas folhas. Invoices tem uma linha por fatura: nome do ficheiro, número da fatura, datas de emissão e de vencimento, número de IVA do fornecedor e do comprador, moeda, líquido, IVA e bruto, número de linhas e soma das linhas, e as três colunas de verificação. Lines tem uma linha por linha de artigo: nome do ficheiro, número da fatura, número da linha, descrição, quantidade, preço unitário e valor. O número da fatura liga as duas. Uma única linha plana por fatura não funciona, porque o número de linhas varia e a minha fatura mais longa tem nove.
Os números entram como números e as datas como datas. Um 175 011,84 Kč checo ou um 10.465,61 € alemão tem de ser convertido antes de ser escrito, ou o Excel trata-o como texto e uma soma ignora-o. Reabri o ficheiro guardado e verifiquei o tipo de 2.256 células: datas, valores, quantidades e resultados das verificações tinham todos o tipo certo, e 0 estavam guardados como texto. Outras 300 células estavam vazias, as linhas em que o script não encontrou nada.
Li o ficheiro de volta com uma biblioteca e não o abri no Excel nem no LibreOffice, e as verificações são valores lógicos (verdadeiro ou falso), não fórmulas.
Quanto custa e quanto demora?
O script não custa nada e demora 0,03 segundos por fatura. Para o Haiku 5.5 usei o custo faturado pela OpenRouter em cada chamada.
| Haiku 5.5 | USD por 1.000 faturas | Mediana de segundos por fatura |
|---|---|---|
| PDF com texto | 0,58 | 2,96 |
| Scan | 0,72 | 4,31 |
| Os dois juntos | 0,65 | 3,66 |
A execução toda foram 60 chamadas e USD 0,038847 (133.197 tokens de entrada, 51.055 de saída), sem nenhuma chamada falhada, nenhuma repetição e nenhuma resposta impossível de ler. Os tempos incluem a rede e o raciocínio do modelo, com 8 chamadas em simultâneo.
O que faz mudar o resultado nos scans?
O mesmo modelo nos mesmos scans não dá um só número. Para ver o que conta, repeti o teste dos scans neste conjunto: só os scans, temperatura 0, duas repetições por condição, mais 240 chamadas por USD 0,145779. As condições foram a entrada (a página como imagem ou o PDF) e o prompt (os nove campos de cabeçalho, ou o cabeçalho mais as linhas). Faturas com os nove campos de cabeçalho certos, em 30:
| Condição | Execução 1 | Execução 2 |
|---|---|---|
| Imagem, só cabeçalho | 13 | 14 |
| Imagem, cabeçalho e linhas | 14 | 14 |
| PDF, só cabeçalho | 13 | 13 |
| PDF, cabeçalho e linhas | 15 | 12 |
A execução que apresento acima é uma quinta execução em PDF com cabeçalho e linhas: 14. O teste com quatro modelos, com imagens, também deu 14 ao Haiku nestes scans.
- Caminho de entrada: sem efeito visível. As execuções com imagem deram 13, 14, 14, 14 e 14 (média 13,8), as em PDF 13, 13, 15, 12 e 14 (média 13,4). Os intervalos sobrepõem-se quase por completo.
- Tamanho do prompt: sem efeito visível. Só cabeçalho deu 13, 14, 13 e 13; cabeçalho e linhas 14, 14, 15, 12 e 14.
- De execução para execução: 0 a 3 faturas entre repetições da mesma condição.
- O conjunto de faturas é o fator maior. Com o mesmo modelo e o mesmo prompt de imagem, um conjunto anterior de 30 faturas deu 22 e 22. Este dá 13 e 14. Cada país tem um número de IVA de comprador repetido em 10 faturas, e neste conjunto o Haiku lê-o mal em 11 a 13 de 30 faturas por execução com imagem (no conjunto anterior, 2 a 3). Uma sequência de dígitos mal lida move até 10 faturas de uma vez. Com dois conjuntos e um modelo, isto mostra que o conjunto pesa mais do que os outros dois efeitos, não por que razão uma dada sequência é difícil de ler.
- Os valores também podem falhar. Em 4 das 8 execuções repetidas pelo menos um valor estava errado. As verificações de somas assinalaram 2 dessas 4 faturas; 2 ficaram em silêncio. A execução que apresento não teve nenhum valor de cabeçalho errado, por isso “quase nunca o dinheiro” vale aí, mas não em todas as execuções.
O que não testei?
- A importação do próprio Excel (Power Query “From PDF”, Data from Picture).
- Faturas reais de fornecedores. As 30 são fictícias: 3 layouts, um tipo de letra, uma página cada.
- Faturas com várias páginas, outros idiomas, fotografias e ruído real de scanner.
- OCR a alimentar o script de regras. A referência para os scans é o script sozinho.
- Qualquer modelo além do Haiku 5.5.
- Regras num layout para o qual não foram afinadas.
O que faria com faturas reais?
É a minha leitura dos números, não um resultado medido. Veja primeiro a camada de texto. Para poucos fornecedores com PDF com texto, as regras são mais baratas, mais rápidas e, neste teste, exatas. Para muitos layouts, layouts desconhecidos ou scans, use um modelo, corra o dígito de controlo do número de IVA e as verificações aritméticas e peça a uma pessoa que olhe para o que elas assinalam e para as descrições, que nenhuma das minhas verificações cobre.
Os scripts, as faturas, os ficheiros com os valores verdadeiros, os resultados e o ficheiro Excel estão neste arquivo. Os 60 PDF e as respostas em bruto do modelo vão lá dentro, por isso a pontuação e o ficheiro Excel reconstroem-se sem chave de API. O meu protótipo de extração de faturas corre com dados de exemplo.
Se ainda está a decidir que parte da sua empresa vale a pena automatizar, ajudo a escolhê-la e depois construo-a: veja Consultoria de IA para PME. As mensagens de clientes são o outro primeiro trabalho comum da IA numa pequena empresa: quanto custa um chatbot WhatsApp com IA por resposta, com a taxa da Meta incluída.
Ver também: Software de gestão documental para PME: 5 opções.
O meu caso semelhante
Construí um serviço que transforma uma certidão de imóvel que demorava 2–3 semanas e custava EUR 200–300 numa que demora 2–3 minutos e custa EUR 99, com scripts e IA de visão. A construção está no caso da automatização de documentos imobiliários.
Se as faturas devem chegar à sua folha de cálculo ou ao software de contabilidade sem ninguém as voltar a escrever, construo isso na automação de processos.
Passa faturas para uma folha de cálculo à mão? Escreva-me e encontramos a melhor opção para si.
Ainda passa as faturas à mão?
Diga-me o que tem agora e o que precisa. Respondo com a opção que eu escolheria.
Fale comigo