Lühidalt
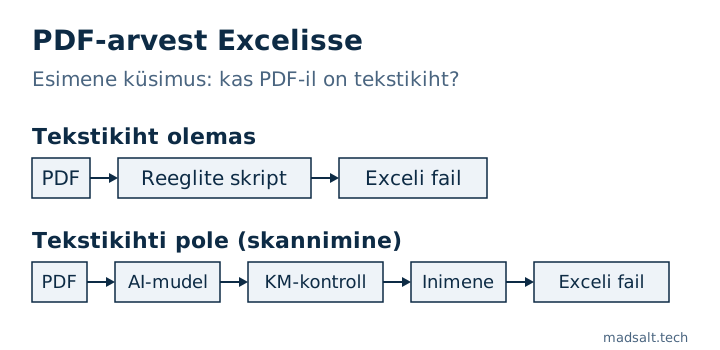
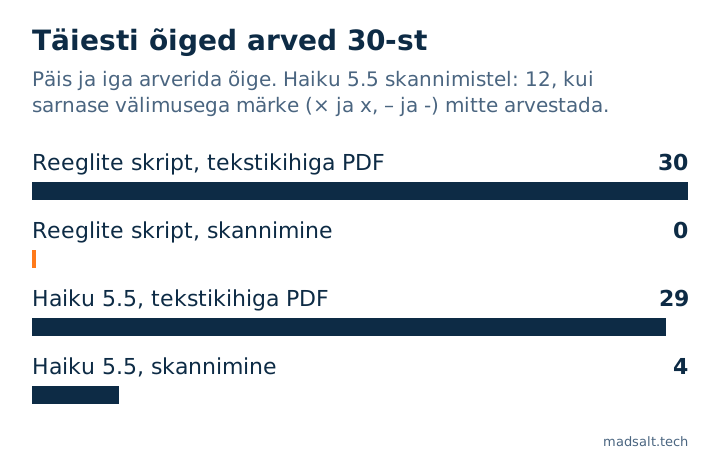
Kõigepealt vaadake, kas PDF-il on tekstikiht. Kui on, luges lühike skript ilma AI-ta kõik 30 minu testarvet õigesti: päise ja kõik 113 arverida, mediaanaeg 0,03 sekundit arve kohta. Skaneeritud PDF-ist ei saa sama skript kätte midagi, seal on vaja mudelit. Selles artiklis kirjeldatud katses luges Claude Haiku 5.5 kõigil 30 skaneeritud arvel neto-, käibemaksu- ja brutosumma õigesti, aga ajas segi numbreid käibemaksunumbrites, arvenumbrites ja kirjeldustes ning kahes arverea summas. Täiesti õigesti tuli välja 4 arvet 30-st, sarnase välimusega märke arvestamata 12. Aritmeetilised kontrollid tabasid 18 vigasest arvest ainult 2. Käibemaksunumbri kontrollsumma tabas 16 ja koos aritmeetiliste kontrollidega 17 arvet 18-st.
Arvete käsitsi Excelisse ümbertrükkimine on aeglane ja vigu on raske märgata. Kas selle töö jaoks on vaja tehisintellekti, sõltub ühest asjast: kuidas PDF on tehtud.
Olen Denys, Forward Deployed Engineer Portos. Tahtsin teada, mis PDF-arve andmete Excelisse tõstmisel päriselt töötab ja kui tihti see eksib, seega tegin töö ise algusest lõpuni läbi. Testis oli 30 väljamõeldud tarnijaarvet, sarnased varasema nelja AI-mudeli testi arvetega: 10 Tšehhi, 10 Saksa ja 10 Portugali arvet, kokku 113 arverida. Ettevõtete nimedes on näidissõnad (Vzor, Muster, Beispiel, Exemplo), igal arvel on SAMPLE-jalus ja käibemaksunumbrid kontrollisin ELi teenuses VIES, mis märkis need kõik kehtetuks. Erinevalt eelmisest testist on sisendiks PDF-failid, lisaks päisele loetakse ka arveread ja tulemuseks on Exceli töövihik.
Kuidas eristada tekstikihiga PDF-i skannimisest?
Raamatupidamistarkvarast välja trükitud PDF sisaldab teksti ennast, see on tekstikiht. Skannitud PDF on lehe pilt PDF-faili sees ja teksti selles ei ole. Kui saate hiirega sõna valida, on see tekstikihiga PDF.
Tegin iga arve mõlemal viisil, kokku 60 PDF-i. Kõigil 30 tekstikihiga PDF-il see oli. Kõigist 30 skannimisest sai PDF-teek kätte 0 märki. Skannimised on minu simulatsioon varasemast testist (pööramine, hägustamine, müra, tugev JPEG-pakkimine), mitte paber skanneris.
Kuidas PDF-arvest andmed ilma AI-ta Excelisse saada?
Tekstikihiga PDF-iga saab. Kirjutasin Pythoni skripti teegiga pdfplumber, tasuta teek, mis loeb tekstikihti: iga keele jaoks üks sildikomplekt, käibemaksunumbrid leitud lehe poole järgi (tarnija vasakul, ostja paremal) ja regulaaravaldis iga arverea jaoks. Need on 94 rida koodi 3 küljenduse jaoks.
Tulemus tekstikihiga PDF-idel: 30 arvet 30-st täiesti õigesti, 0 viga 270 päiseväljas, 113 arverida 113-st õigesti, mediaan 0,03 sekundit arve kohta ja kulu puudub.
Reservatsioon on suur. Kirjutasin reeglid, vaadates just neid samu 30 arvet, nii et see on reeglitele parim võimalik juht. Iga uue tarnija küljenduse jaoks on vaja uusi reegleid ja ühtegi teist küljendust ma ei testinud. Kaks asja, millega reeglid pidid hakkama saama:
- Lugemisjärjekord. Kõigil 30 arvel, kõigis kolmes küljenduses, on ostja käibemaksunumber tekstikihis enne tarnija omast, nii et “võta esimene käibemaksunumber” vahetab need ära. Skript loeb lehe vasakut ja paremat poolt eraldi.
- Käibemaksunumbri prefiks. Portugali arvetel on number trükitud
PT-ga või ilma. Võrdlen ilma prefiksita: 8 arvet erineb tegelikust väärtusest ainult selle poolest.
Mis juhtub, kui PDF on skannimine?
Skript ebaõnnestub vaikselt. 30 skannimise peal andis extract_text() iga kord tühja stringi, kutse õnnestus ja kõik 270 päisevälja jäid tühjaks. Ühtegi viga ei visatud.
Skannimiste jaoks saatsin iga PDF-i Claude Haiku 5.5-le OpenRouteri kaudu, mis loeb PDF-i otse, ilma eraldi OCR-sammuta. Temperatuur 0, üks JSON arve kohta: üheksa päisevälja pluss arveread (kirjeldus, kogus, ühikuhind, summa).
| Meetod ja sisend | Täiesti õiged arved | Õiged arveread |
|---|---|---|
| Skript, tekstikihiga PDF | 30 / 30 | 113 / 113 |
| Skript, skannimine | 0 / 30 | 0 / 113 |
| Haiku 5.5, tekstikihiga PDF | 29 / 30 | 112 / 113 |
| Haiku 5.5, skannimine, täpselt | 4 / 30 | 76 / 113 |
| Haiku 5.5, skannimine, sarnased märgid maha arvatud | 12 / 30 | 108 / 113 |
“Täiesti õige” tähendab, et üheksa päisevälja ja iga arverida klapivad. Tekstikihiga PDF-idel oli Haiku ainus eksimus kirjeldus, Europaletten asemel Europalette; selle päis oli õige 30 arvel 30-st. Skannimiste puhul olid kõik üheksa päisevälja õiged 14 arvel 30-st.
Mida mudel skannimistel valesti luges?
Enamasti mitte raha. Arve kuupäev, maksetähtaeg, valuuta, neto, käibemaks ja bruto: 0 viga kõigil 30 arvel selles käivituses. Kogus, ühikuhind ja summa: 111 õiget 113-st. Vead olid enamasti tekstis:
- Päis: 21 valet välja 16 arvel, kõik käibemaksunumbrites. Tarnija käibemaksunumber 6 korda, ostja käibemaksunumber 15 korda.
- Arveread: 37 113-st ei ole täpselt õiged. 32 erinevad ainult tüpograafia poolest:
×tagastati kuix,–kui-,µ(mikromärk) kuiμ(kreeka mü). 5 on päris valesti lugemised: 3 kirjeldust (fita estirávelasemelfilme estirável, kõik ühel Portugali arvel) ja 2 summat (184,00loetud kui164,00,1.376,67kui1.378,67).
Miks aritmeetilised kontrollid peaaegu vait olid?
Panin töövihikusse kaks kontrolli veergudena: arveread annavad kokku neto kogusumma ning neto pluss käibemaks võrdub brutoga, mõlemad täpsusega 0,01. Mudeli skannimistel märkisid need ära 2 tõeliselt valest arvest 18-st (2 26-st, kui tüpograafia loetakse veaks), need kaks valesti loetud arverea summaga. Päise summad olid õiged, nii et summad klappisid. Arvude kontroll ei näe valet numbrit identifikaatoris ega sõnas. Varasem test näitas sama mustrit: selle kogusummade kontroll märkis 3 63 valest arvest.
Skripti tühja väljundi peal lõid mõlemad kontrollid häire 30 korral 30-st. Tuvastus, mis ei tagasta midagi, kukub tabelis vähemalt valjult läbi.
Kolmas kontroll, käibemaksunumbri kontrollnumber (python-stdnum Tšehhi DIČ, Saksa USt-IdNr. ja Portugali NIF), leidis 16 valest arvest 18-st ega andnud valehäiret ühegi õige arve kohta. Ükski vale käibemaksunumber ei läbinud seda. Koos aritmeetiliste kontrollidega on see 17 18-st. Järele jäi Portugali arve, kus oli valesti loetud ainult kirjeldused, ja see vajab inimest, kellel on rea kõrval PDF avatud.
Milline peaks Exceli töövihik välja nägema?
Kaks töölehte. Invoices sisaldab ühte rida arve kohta: failinimi, arvenumber, arve kuupäev ja maksetähtaeg, tarnija ja ostja käibemaksunumber, valuuta, neto, käibemaks ja bruto, ridade arv ja ridade summa ning kolm kontrolliveergu. Lines sisaldab ühte rida arverea kohta: failinimi, arvenumber, reanumber, kirjeldus, kogus, ühikuhind ja summa. Tööleheid ühendab arvenumber. Üks lame rida arve kohta ei tööta, sest ridade arv varieerub ja minu pikimal arvel on neid üheksa.
Arvud lähevad sisse arvudena ja kuupäevad kuupäevadena. Tšehhi 175 011,84 Kč või Saksa 10.465,61 € tuleb enne kirjutamist teisendada, muidu käsitleb Excel neid tekstina ja summa jätab need arvestamata. Avasin salvestatud faili uuesti ja kontrollisin 2256 lahtri tüüpi: kuupäevad, summad, kogused ja kontrollitulemused olid kõik õiget tüüpi ning 0 oli salvestatud tekstina. Veel 300 lahtrit oli tühja, need on read, kus skript ei leidnud midagi.
Lugesin faili tagasi teegiga ja ei avanud seda Excelis ega LibreOffice’is ning kontrollid on väärtused TRUE või FALSE, mitte valemid.
Kui palju see maksab ja kui kaua kestab?
Skript maksab null ja võtab 0,03 sekundit arve kohta. Haiku 5.5 puhul kasutasin OpenRouteri arveldatud hinda kõne kohta:
| Haiku 5.5 | USD tuhande arve kohta | Mediaanaeg arve kohta sekundites |
|---|---|---|
| Tekstikihiga PDF | 0,58 | 2,96 |
| Skannimine | 0,72 | 4,31 |
| Mõlemad kokku | 0,65 | 3,66 |
Kogu käivitus oli 60 kõnet ja USD 0,038847 (133 197 tokenit sisendis, 51 055 väljundis), ilma ühegi ebaõnnestunud kõne, kordamise ega loetamatu vastuseta. Ajad sisaldavad võrku ja mudeli arutlust, kusjuures korraga oli töös 8 kõnet.
Mis mõjutab skannimiste tulemust?
Sama mudel samade skannimistega ei anna ühte arvu. Et näha, mis loeb, kordasin skannimiste testi selle komplektiga: ainult skannimised, temperatuur 0, kaks kordust iga tingimuse kohta, veel 240 kõnet hinnaga USD 0,145779. Tingimused olid sisend (leht pildina või PDF) ja prompt (üheksa päisevälja või päis pluss arveread). Arved, millel kõik üheksa päisevälja õiged, 30-st:
| Tingimus | 1. käivitus | 2. käivitus |
|---|---|---|
| Pilt, ainult päis | 13 | 14 |
| Pilt, päis ja read | 14 | 14 |
| PDF, ainult päis | 13 | 13 |
| PDF, päis ja read | 15 | 12 |
Ülal esitatud käivitus on viies PDF-käivitus päise ja ridadega: 14. Ka nelja mudeli piltide test andis nende skannimiste peal Haiku jaoks 14.
- Sisendi tee: nähtavat mõju pole. Pildikäivitused andsid 13, 14, 14, 14 ja 14 (keskmiselt 13,8), PDF-käivitused 13, 13, 15, 12 ja 14 (keskmiselt 13,4). Vahemikud kattuvad peaaegu täielikult.
- Prompti maht: nähtavat mõju pole. Ainult päis andis 13, 14, 13 ja 13; päis ja read 14, 14, 15, 12 ja 14.
- Käivituselt käivitusele: 0 kuni 3 arvet sama tingimuse kordustes.
- Suurim tegur on arvete komplekt. Sama mudeli ja sama pildiprompti puhul andis varasem 30 arve komplekt 22 ja 22. See annab 13 ja 14. Igal riigil on üks ostja käibemaksunumber, mis kordub 10 arvel, ja selles komplektis loeb Haiku seda valesti 11 kuni 13 arvel 30-st pildikäivituse kohta (varasemas komplektis 2 kuni 3). Üks valesti loetud string liigutab korraga kuni 10 arvet. Kahe komplekti ja ühe mudeliga näitab see, et komplekt kaalub üles ülejäänud kaks mõju, mitte seda, miks mingit stringi on raske lugeda.
- Summad võivad valed olla. 8 kordusest 4-s oli vähemalt üks summa vale. Summakontrollid märkisid neist 4 arvest 2; 2 jäid märkamata. Minu esitatud käivituses ei olnud päise summades viga, nii et “enamasti mitte raha” kehtib seal, aga mitte igas käivituses.
Mida ma ei testinud?
- Exceli enda importi (Power Query “From PDF”, Data from Picture).
- Päris tarnijaarveid. Kõik 30 on väljamõeldud: 3 küljendust, üks font, üks lehekülg igaüks.
- Mitmelehelisi arveid, teisi keeli, fotosid ja päris skanneri müra.
- OCR-i, mis toidab reeglite skripti. Skannimiste alusvõrdlus on ainult skript.
- Ühtegi muud mudelit peale Haiku 5.5.
- Reegleid küljendusele, mille jaoks neid ei häälestatud.
Mida ma päris arvetega teeksin?
See on minu lugemine arvudest, mitte mõõdetud tulemus. Vaadake kõigepealt tekstikihti. Mõne tarnija tekstikihiga PDF-ide jaoks on reeglid odavamad, kiiremad ja selles testis täpsed. Paljude või tundmatute küljenduste või skannimiste jaoks kasutage mudelit, jooksutage käibemaksunumbri kontrollnumbri kontrolli ja aritmeetilisi kontrolle ning laske inimesel vaadata, mida need märgivad, ja kirjeldusi, mida ükski minu kontroll ei kata.
Skriptid, arved, tegelikud väärtused, tulemused ja töövihik on selles arhiivis. Sees on 60 PDF-i ja mudeli töötlemata vastused, nii et hindamise ja töövihiku saab uuesti üles ehitada ilma API võtmeta. Minu arvete andmete tuvastamise prototüüp töötab näidisandmetel.
Kui otsustate veel, millist osa ettevõttest tasub automatiseerida, aitan selle valida ja ehitan selle seejärel valmis: vaadake lehte Tehisintellekti konsultant väikeettevõttele. Klientide sõnumid on teine levinud esimene AI ülesanne väikeettevõttes: kui palju maksab WhatsAppi vestlusrobot vastuse kohta, Meta tasu arvestatud.
Vaata ka: Dokumendihaldustarkvara väikeettevõttele: 8 hinnaga.
Minu sarnane juhtum
Ehitasin teenuse, mis muudab kinnisvaratõendi, mille saamine võttis 2–3 nädalat ja maksis EUR 200–300, selliseks, mis võtab 2–3 minutit ja maksab EUR 99, skriptide ja pildituvastus-AI abil. Ehitus on kinnisvaradokumentide automatiseerimise juhtumis.
Kui arved peavad jõudma teie arvutustabelisse või raamatupidamistööriista ilma, et keegi neid uuesti sisestaks, ehitan selle töövoo automatiseerimise all.
Viite arveid käsitsi tabelisse? Kirjutage mulle, siis leiame teile parima valiku.
Viite arveid ikka käsitsi?
Öelge mulle, mis teil praegu on ja mida vajate. Vastan valikuga, mille ise teeksin.
Kirjutage mulle