TL;DR
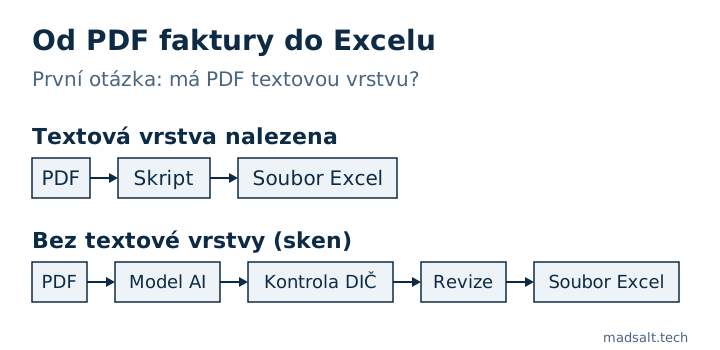
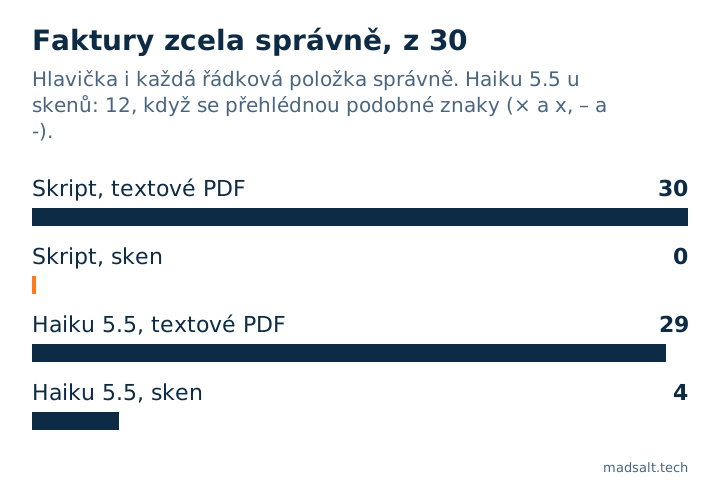
Nejdřív zjistěte, jestli má PDF textovou vrstvu. Pokud ano, krátký skript bez AI přečetl správně všech 30 mých testovacích faktur, hlavičku i všech 113 řádkových položek, s mediánem 0,03 sekundy na fakturu. U skenu stejný skript nevrátí nic a potřebujete model. V běhu, o kterém píšu, přečetl Claude Haiku 5.5 u všech 30 skenů správně součty základu, DPH i celkové částky, ale spletl číslice v DIČ, číslech faktur a popisech a dvě částky na řádcích: 4 z 30 faktur zcela správně, 12, když se přehlédnou podobné znaky. Aritmetické kontroly zachytily 2 z 18 chybných faktur. Kontrola kontrolní číslice DIČ zachytila 16 z 18 a spolu s aritmetickými kontrolami 17 z 18.
Jsem Denys, full-stack a AI inženýr. Chtěl jsem vědět, co funguje při převodu PDF faktury do Excelu a jak často je výsledek špatně. Zkusil jsem proto úlohu sám od začátku do konce na 30 fiktivních dodavatelských fakturách podobných těm z mého dřívějšího testu čtyř modelů AI: 10 českých, 10 německých a 10 portugalských, celkem 113 řádkových položek. Názvy firem nesou ukázková slova (Vzor, Muster, Beispiel, Exemplo), každá faktura má v zápatí text SAMPLE a DIČ byla ověřena ve službě VIES Evropské unie, která u všech odpověděla „neplatné“. Tenhle test používá PDF, přidává řádkové položky a končí v sešitu Excelu.
Jak poznáte textové PDF od skenu?
PDF vytištěné z účetního programu obsahuje samotný text, textovou vrstvu. Skenované PDF je obrázek stránky zabalený do souboru PDF, bez jakéhokoli textu. Pokud můžete myší označit slovo, je to textové PDF.
Od každé faktury jsem vytvořil obě verze, celkem 60 PDF. Všech 30 textových PDF mělo textovou vrstvu. Ze všech 30 skenů získala knihovna pro PDF 0 znaků. Skeny jsou moje simulace z dřívějšího testu (pootočení, rozmazání, šum, silná JPEG komprese), ne papír ze skeneru.
Jde převod PDF faktury do Excelu bez AI?
Jde, pokud má PDF textovou vrstvu. Napsal jsem skript v Pythonu s knihovnou pdfplumber, která zdarma čte textovou vrstvu: jedna sada popisků na jazyk, DIČ nalezená podle poloviny stránky (dodavatel vlevo, odběratel vpravo) a regulární výraz na každý řádek položky. Je to 94 řádků pro 3 rozvržení. Taková extrakce dat z faktur nepotřebuje žádný model.
Výsledek na textových PDF: 30 z 30 faktur zcela správně, 0 chyb ve 270 polích hlavičky, 113 ze 113 řádkových položek správně, medián 0,03 sekundy na fakturu a žádné náklady.
Má to velký háček. Pravidla jsem psal s těmito 30 fakturami před očima, takže je to pro pravidla nejlepší možný případ. Každé nové rozvržení dodavatele potřebuje nová pravidla a žádné jiné rozvržení jsem netestoval. Dvě věci, které pravidla musela zvládnout:
- Pořadí čtení. U všech 30 faktur, ve všech třech rozvrženích, je v textové vrstvě DIČ odběratele před DIČ dodavatele, takže „vezmi první DIČ“ je prohodí. Skript čte levou a pravou polovinu stránky zvlášť.
- Předpona DIČ. Portugalské faktury tisknou číslo s
PTi bez něj. Porovnávám bez předpony: 8 faktur se od pravdivé hodnoty liší jen tímto.
Co se stane, když je PDF faktura sken?
Skript selže potichu. U 30 skenů vrátilo extract_text() pokaždé prázdný řetězec, volání uspělo a všech 270 polí hlavičky přišlo prázdných. Nic nevyvolalo chybu.
U skenů jsem každé PDF poslal přes OpenRouter modelu Claude Haiku 5.5, který čte PDF přímo, bez samostatného kroku OCR. Teplota 0, jeden JSON na fakturu: devět polí hlavičky plus řádkové položky (popis, množství, jednotková cena, částka).
| Metoda a vstup | Faktury zcela správně | Řádkové položky správně |
|---|---|---|
| Skript, textové PDF | 30 z 30 | 113 ze 113 |
| Skript, sken | 0 z 30 | 0 ze 113 |
| Haiku 5.5, textové PDF | 29 z 30 | 112 ze 113 |
| Haiku 5.5, sken, přesně | 4 z 30 | 76 ze 113 |
| Haiku 5.5, sken, podobné znaky ignorovány | 12 z 30 | 108 ze 113 |
„Zcela správně“ znamená, že souhlasí devět polí hlavičky i každá řádková položka. U textových PDF byla jediná chyba Haiku v popisu, Europaletten místo Europalette; jeho hlavička byla správně u 30 z 30. U skenů mělo všech devět polí hlavičky správně 14 z 30 faktur.
Co model při vytěžování faktur ze skenů přečetl špatně?
Většinou ne peníze. Datum vystavení, datum splatnosti, měna, základ daně, DPH a celková částka: 0 chyb u všech 30 faktur v tomto běhu. Množství, jednotková cena a částka: 111 ze 113 správně. Chyby byly většinou v textu:
- Hlavička: 21 chybných polí v 16 fakturách, všechny v DIČ. DIČ dodavatele 6krát, DIČ odběratele 15krát.
- Řádkové položky: 37 ze 113 není přesně správně. 32 se liší jen typograficky:
×vrácené jakox,–jako-,µ(znak mikro) jakoμ(řecké mí). 5 je skutečných chybných přečtení: 3 popisy (fita estirávelmístofilme estirável, všechny na jedné portugalské faktuře) a 2 částky (184,00přečteno jako164,00,1.376,67jako1.378,67).
Proč aritmetické kontroly téměř mlčely?
Do sešitu jsem dal dvě kontroly jako sloupce: řádkové položky se sečtou na základ daně a základ plus DPH se rovná celkové částce, obojí s tolerancí 0,01. U skenů čtených modelem označily 2 z 18 skutečně chybných faktur (2 z 26, když se za chybu počítá i typografie), tedy ty dvě se špatně přečtenou částkou na řádku. Částky v hlavičce byly správně, takže součty seděly. Kontrola čísel nevidí špatnou číslici v identifikátoru ani ve slově. Stejný vzorec našel už dřívější test: jeho kontrola součtů označila 3 z 63 chybných faktur.
U prázdného výstupu skriptu zahlásily obě kontroly chybu u 30 z 30. Vytěžení, které nevrátí nic, aspoň v tabulce selže nahlas.
Třetí kontrola, kontrolní číslice DIČ (python-stdnum pro české DIČ, německé USt-IdNr. a portugalské NIF), zachytila 16 z 18 chybných faktur a u žádné správné nevyvolala falešný poplach. Žádné chybné DIČ jí neprošlo. Spolu s aritmetickými kontrolami je to 17 z 18. Zbývající jedna byla portugalská faktura, na které byly špatně přečteny jen popisy, a potřebuje člověka, který má vedle řádku otevřené PDF.
Jak má vypadat soubor Excelu?
Dva listy. Invoices má jeden řádek na fakturu: název souboru, číslo faktury, datum vystavení a splatnosti, DIČ dodavatele a odběratele, měnu, základ, DPH a celkovou částku, počet řádkových položek a jejich součet a tři sloupce kontrol. Lines má jeden řádek na položku: název souboru, číslo faktury, číslo řádku, popis, množství, jednotkovou cenu a částku. Obě propojuje číslo faktury. Jeden plochý řádek na fakturu nefunguje, protože počet položek kolísá a moje nejdelší faktura jich má devět.
Čísla se zapisují jako čísla a data jako data. České 175 011,84 Kč nebo německé 10.465,61 € je třeba před zápisem převést, jinak je Excel bere jako text a součet je ignoruje. Uložený soubor jsem znovu otevřel a zkontroloval typ 2 256 buněk: data, částky, množství i výsledky kontrol měly správný typ a 0 bylo uloženo jako text. Dalších 300 buněk bylo prázdných, šlo o řádky, kde skript nic nenašel.
Soubor jsem načetl zpět knihovnou a neotevíral ho v Excelu ani v LibreOffice a kontroly jsou hodnoty TRUE nebo FALSE, ne vzorce.
Kolik to stojí a jak dlouho to trvá?
Skript nestojí nic a zabere 0,03 sekundy na fakturu. U Haiku 5.5 jsem použil cenu za volání vyúčtovanou OpenRouterem:
| Haiku 5.5 | USD za 1 000 faktur | Medián sekund na fakturu |
|---|---|---|
| Textové PDF | 0,58 | 2,96 |
| Sken | 0,72 | 4,31 |
| Oboje dohromady | 0,65 | 3,66 |
Celý běh měl 60 volání a stál USD 0,038847 (133 197 vstupních a 51 055 výstupních tokenů), bez neúspěšného volání, bez opakování a bez nečitelné odpovědi. Časy zahrnují síť a uvažování modelu, při 8 souběžných voláních.
Co ovlivňuje výsledek u skenů?
Stejný model na týchž skenech nedává jedno číslo. Abych zjistil, na čem záleží, zopakoval jsem test skenů na této sadě: jen skeny, teplota 0, dvě opakování na podmínku, dalších 240 volání za USD 0,145779. Podmínky byly vstup (stránka jako obrázek, nebo PDF) a prompt (devět polí hlavičky, nebo hlavička plus řádkové položky). Faktury se všemi devíti poli hlavičky správně, z 30:
| Podmínka | Běh 1 | Běh 2 |
|---|---|---|
| Obrázek, jen hlavička | 13 | 14 |
| Obrázek, hlavička a řádky | 14 | 14 |
| PDF, jen hlavička | 13 | 13 |
| PDF, hlavička a řádky | 15 | 12 |
Běh, o kterém píšu výše, je pátý běh s PDF, hlavičkou a řádky: 14. Test čtyř modelů s obrázky dal u Haiku na těchto skenech také 14.
- Cesta vstupu: žádný viditelný vliv. Běhy s obrázkem daly 13, 14, 14, 14 a 14 (průměr 13,8), běhy s PDF 13, 13, 15, 12 a 14 (průměr 13,4). Rozsahy se téměř úplně překrývají.
- Velikost promptu: žádný viditelný vliv. Jen hlavička dala 13, 14, 13 a 13; hlavička a řádky 14, 14, 15, 12 a 14.
- Mezi běhy: 0 až 3 faktury mezi opakováními jedné podmínky.
- Největším faktorem je sada faktur. Se stejným modelem a stejným promptem s obrázkem dala dřívější sada 30 faktur 22 a 22. Tahle dává 13 a 14. V každé zemi se jedno DIČ odběratele opakuje na 10 fakturách a na této sadě je Haiku čte špatně na 11 až 13 z 30 faktur na jeden běh s obrázkem (na dřívější sadě na 2 až 3). Jeden špatně přečtený řetězec posune až 10 faktur najednou. Se dvěma sadami a jedním modelem to ukazuje, že sada převáží nad dalšími dvěma vlivy, ne proč je daný řetězec těžké přečíst.
- Částky se mohou pokazit. Při 4 z 8 opakovaných běhů byla špatně alespoň jedna částka. Kontroly součtů označily 2 z těchto 4 faktur; 2 zůstaly bez povšimnutí. Běh, o kterém píšu, neměl žádnou špatnou částku v hlavičce, takže „většinou ne peníze“ tam platí, ale ne v každém běhu.
Co jsem netestoval?
- Vlastní import Excelu (Power Query „From PDF“, „Data from Picture“).
- Skutečné dodavatelské faktury. Všech 30 je fiktivních: 3 rozvržení, jedno písmo, jedna strana.
- Vícestránkové faktury, jiné jazyky, fotky a skutečný šum skeneru.
- OCR jako předstupeň skriptu s pravidly. Základ pro skeny je samotný skript.
- Jiný model než Haiku 5.5.
- Pravidla na rozvržení, na které nebyla vyladěna.
Co bych dělal se skutečnými fakturami?
Tohle je moje čtení čísel, ne změřený výsledek. Nejdřív zkontrolujte textovou vrstvu. U pár dodavatelů s textovými PDF jsou pravidla levnější, rychlejší a v tomto testu přesná. U mnoha nebo neznámých rozvržení nebo u skenů použijte model, pusťte kontrolu kontrolní číslice DIČ a aritmetické kontroly a nechte člověka projít, co označí, a také popisy, které nekryje žádná z mých kontrol.
Skripty, faktury, soubory s pravdivými hodnotami, výsledky i sešit jsou v tomto archivu. Je v něm 60 PDF a surové odpovědi modelu, takže vyhodnocení i sešit jde znovu sestavit bez klíče k API. Můj prototyp vytěžování faktur běží na ukázkových datech.
Pokud ještě zvažujete, kterou část firmy se vyplatí automatizovat, pomohu ji vybrat a pak ji postavím: viz AI konzultant pro malé firmy. Zprávy od zákazníků jsou druhá častá první práce pro AI v malé firmě: kolik stojí WhatsApp chatbot s AI za odpověď, včetně poplatku Meta.
Viz také: Systém pro správu dokumentů pro malou firmu: ceny a limity.
Můj podobný případ
Postavil jsem službu, která z potvrzení o nemovitosti, na které se čekalo 2–3 týdny a stálo EUR 200–300, udělá potvrzení za 2–3 minuty a EUR 99, se skripty a vision AI. Stavba je v případové studii automatizace dokumentů k nemovitostem.
Pokud mají faktury dorazit do vaší tabulky nebo účetního nástroje a nikdo je nepřepisuje ručně, stavím to v rámci automatizace workflow.
Přesouváte faktury do tabulky ručně? Napište mi a společně vybereme nejlepší možnost.
Pořád přesouváte faktury ručně?
Napište mi, co máte teď a co potřebujete. Odpovím variantou, kterou bych zvolil já.
Napište mi