En resumen
Primero compruebe si el PDF tiene capa de texto. Si la tiene, un script corto, sin IA, leyó bien las 30 facturas de prueba, la cabecera y las 113 líneas, con una mediana de 0,03 segundos cada una. En un escaneo el mismo script no devuelve nada y hace falta un modelo. En la ejecución que presento, Claude Haiku 5.5 acertó los totales neto, IVA y bruto en los 30 escaneos, pero leyó mal dígitos en números de IVA, números de factura y descripciones, y dos importes de línea: 4 de 30 facturas totalmente correctas, 12 si se ignoran los caracteres parecidos. Las comprobaciones aritméticas cazaron 2 de las 18 facturas erróneas. El dígito de control del número de IVA cazó 16 de las 18, y 17 de 18 junto con las comprobaciones aritméticas.
Soy Denys, ingeniero full-stack y de IA. Quería saber qué funciona para convertir una factura PDF a Excel, es decir, para extraer datos de la factura PDF, y con qué frecuencia falla. Así que hice el trabajo de principio a fin con 30 facturas ficticias de proveedores como las de mi prueba anterior con cuatro modelos de IA: 10 checas, 10 alemanas y 10 portuguesas, 113 líneas en total. Los nombres de las empresas llevan palabras de ejemplo (Vzor, Muster, Beispiel, Exemplo), cada factura tiene un pie SAMPLE y los números de IVA se consultaron en el servicio VIES de la UE, que respondió “no válido” para todos. Esta vez con PDF, con las líneas de detalle, y terminando en un archivo de Excel.
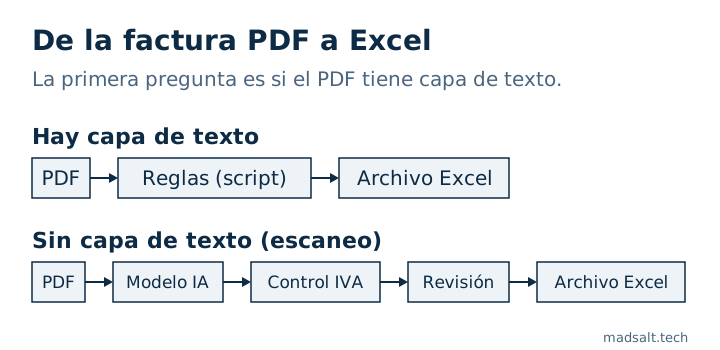
¿Cómo distinguir un PDF de texto de un escaneo?
Un PDF generado por un programa de contabilidad contiene el propio texto, una capa de texto. Un PDF escaneado es la imagen de una página dentro de un archivo PDF, sin texto. Si puede seleccionar una palabra con el ratón, es un PDF de texto.
Hice las dos versiones de cada factura, 60 PDF. Los 30 PDF de texto tenían todos capa de texto. De los 30 escaneos, una biblioteca de PDF extrajo 0 caracteres. Los escaneos son mi simulación de la prueba anterior (giro, desenfoque, ruido, compresión JPEG fuerte), no papel pasado por un escáner.
¿Se puede convertir una factura PDF a Excel sin IA?
Sí. Escribí un script en Python con pdfplumber, una biblioteca gratuita que lee la capa de texto: un conjunto de etiquetas por idioma, números de IVA localizados por mitad de página (proveedor a la izquierda, comprador a la derecha) y una expresión regular por línea de detalle. Son 94 líneas para 3 diseños.
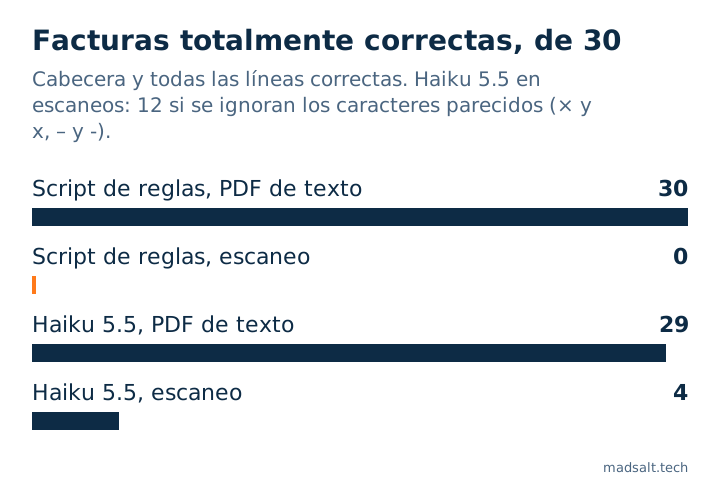
Resultado en los PDF de texto: 30 de 30 facturas totalmente correctas, 0 errores en los 270 campos de cabecera, 113 de 113 líneas correctas, una mediana de 0,03 segundos por factura y sin coste.
La salvedad es grande. Escribí las reglas mirando estas mismas 30 facturas, así que este es el mejor caso para las reglas. Cada diseño nuevo de proveedor necesita reglas nuevas, y no probé ningún otro diseño. Dos cosas que las reglas tuvieron que resolver:
- Orden de lectura. En las 30 facturas, en los tres diseños, el número de IVA del comprador aparece antes que el del proveedor en la capa de texto, así que “coger el primer número de IVA” los intercambia. El script lee por separado las mitades izquierda y derecha de la página.
- Prefijo del número de IVA. Las facturas portuguesas imprimen el número con o sin
PT. Comparo sin el prefijo: 8 facturas solo se diferencian del valor verdadero por eso.
¿Qué pasa cuando el PDF es un escaneo: hace falta OCR de facturas a Excel?
El script falla sin hacer ruido. En los 30 escaneos, extract_text() devolvió siempre un texto vacío, la llamada se ejecutó bien y los 270 campos de cabecera salieron vacíos. Nada lanzó un error.
Para los escaneos envié cada PDF a Claude Haiku 5.5 a través de OpenRouter, que lee el PDF directamente, sin un paso de OCR aparte: en esta prueba no hubo ningún OCR de facturas a Excel por separado. Temperatura 0, un JSON por factura: los nueve campos de cabecera más las líneas (descripción, cantidad, precio unitario, importe).
| Método y entrada | Facturas totalmente correctas | Líneas correctas |
|---|---|---|
| Script, PDF de texto | 30 de 30 | 113 de 113 |
| Script, escaneo | 0 de 30 | 0 de 113 |
| Haiku 5.5, PDF de texto | 29 de 30 | 112 de 113 |
| Haiku 5.5, escaneo, exacto | 4 de 30 | 76 de 113 |
| Haiku 5.5, escaneo, ignorando caracteres parecidos | 12 de 30 | 108 de 113 |
“Totalmente correcta” significa que los nueve campos de cabecera y todas las líneas coinciden. En los PDF de texto, el único fallo de Haiku fue una descripción, Europaletten en lugar de Europalette; la cabecera salió bien en 30 de 30. En los escaneos, 14 de 30 facturas tenían bien los nueve campos de cabecera.
¿Qué falló el modelo en los escaneos?
Casi nunca el dinero. Fecha de emisión, fecha de vencimiento, moneda, neto, IVA y bruto: 0 errores en las 30 facturas en esta ejecución. Cantidad, precio unitario e importe: 111 de 113 correctos. Los fallos fueron sobre todo de texto:
- Cabecera: 21 campos erróneos en 16 facturas, todos en números de IVA. Número de IVA del proveedor 6 veces, del comprador 15 veces.
- Líneas: 37 de 113 no exactamente correctas. 32 se diferencian solo por la tipografía:
×devuelto comox,–como-,µ(signo micro) comoμ(mu griega). 5 son lecturas erróneas de verdad: 3 descripciones (fita estirávelen lugar defilme estirável, todas en una factura portuguesa) y 2 importes (184,00leído como164,00,1.376,67como1.378,67).
¿Por qué callaron casi todas las comprobaciones aritméticas?
Puse dos comprobaciones en el libro como columnas: las líneas suman el total neto, y neto más IVA es igual al bruto, ambas con una tolerancia de 0,01. En los escaneos del modelo marcaron 2 de las 18 facturas realmente erróneas (2 de 26 si la tipografía cuenta como error), las dos con un importe de línea mal leído. Los importes de la cabecera estaban bien, así que las sumas cuadraban. Una comprobación sobre números no ve un dígito equivocado en un identificador o en una palabra. La prueba anterior encontró el mismo patrón: su comprobación de totales marcó 3 de 63 facturas erróneas.
Con la salida vacía del script, las dos comprobaciones saltaron en 30 de 30. Una extracción que no devuelve nada falla, al menos, con ruido en la hoja de cálculo.
Una tercera comprobación, el dígito de control del número de IVA (python-stdnum para el DIČ checo, el USt-IdNr. alemán y el NIF portugués), cazó 16 de las 18 facturas erróneas y no dio falsa alarma en ninguna correcta. Ningún número de IVA erróneo la pasó. Junto con las comprobaciones aritméticas son 17 de 18. La que quedó fue una factura portuguesa en la que solo se leyeron mal descripciones, y necesita a una persona con el PDF abierto junto a la fila.
¿Cómo debe ser el archivo de Excel?
Dos hojas. Invoices tiene una fila por factura: nombre del archivo, número de factura, fechas de emisión y de vencimiento, número de IVA del proveedor y del comprador, moneda, neto, IVA y bruto, número de líneas y suma de las líneas, y las tres columnas de comprobación. Lines tiene una fila por línea de detalle: nombre del archivo, número de factura, número de línea, descripción, cantidad, precio unitario e importe. El número de factura une las dos. Una sola fila plana por factura no funciona, porque el número de líneas varía y mi factura más larga tiene nueve.
Los números entran como números y las fechas como fechas. Un 175 011,84 Kč checo o un 10.465,61 € alemán hay que convertirlo antes de escribirlo, o Excel lo trata como texto y una suma lo ignora. Volví a abrir el archivo guardado y comprobé el tipo de 2.256 celdas: fechas, importes, cantidades y resultados de las comprobaciones tenían todos el tipo correcto, y 0 estaban guardados como texto. Otras 300 celdas estaban vacías, las filas en las que el script no encontró nada.
Leí el archivo de vuelta con una biblioteca y no lo abrí en Excel ni en LibreOffice, y las comprobaciones son valores lógicos (verdadero o falso), no fórmulas.
¿Cuánto cuesta y cuánto tarda?
El script no cuesta nada y tarda 0,03 segundos por factura. Para Haiku 5.5 usé el coste facturado por OpenRouter en cada llamada.
| Haiku 5.5 | USD por 1.000 facturas | Mediana de segundos por factura |
|---|---|---|
| PDF de texto | 0,58 | 2,96 |
| Escaneo | 0,72 | 4,31 |
| Ambos juntos | 0,65 | 3,66 |
La ejecución entera fueron 60 llamadas y USD 0,038847 (133.197 tokens de entrada, 51.055 de salida), sin ninguna llamada fallida, ningún reintento y ninguna respuesta ilegible. Los tiempos incluyen la red y el razonamiento del modelo, con 8 llamadas a la vez.
¿Qué hace cambiar el resultado en los escaneos?
El mismo modelo con los mismos escaneos no da un único número. Para ver qué importa, repetí la prueba de escaneos con este conjunto: solo los escaneos, temperatura 0, dos repeticiones por condición, 240 llamadas más por USD 0,145779. Las condiciones fueron la entrada (la página como imagen o el PDF) y el prompt (los nueve campos de cabecera, o la cabecera más las líneas). Facturas con los nueve campos de cabecera bien, de 30:
| Condición | Ejecución 1 | Ejecución 2 |
|---|---|---|
| Imagen, solo cabecera | 13 | 14 |
| Imagen, cabecera y líneas | 14 | 14 |
| PDF, solo cabecera | 13 | 13 |
| PDF, cabecera y líneas | 15 | 12 |
La ejecución que presento arriba es una quinta ejecución en PDF con cabecera y líneas: 14. La prueba de cuatro modelos con imágenes también dio 14 a Haiku con estos escaneos.
- Vía de entrada: sin efecto visible. Las ejecuciones con imagen dieron 13, 14, 14, 14 y 14 (media 13,8), las de PDF 13, 13, 15, 12 y 14 (media 13,4). Los rangos se solapan casi por completo.
- Tamaño del prompt: sin efecto visible. Solo cabecera dio 13, 14, 13 y 13; cabecera y líneas 14, 14, 15, 12 y 14.
- De una ejecución a otra: de 0 a 3 facturas entre repeticiones de la misma condición.
- El conjunto de facturas es el factor mayor. Con el mismo modelo y el mismo prompt de imagen, un conjunto anterior de 30 facturas dio 22 y 22. Este da 13 y 14. Cada país tiene un número de IVA de comprador repetido en 10 facturas, y con este conjunto Haiku lo lee mal en 11 a 13 de 30 facturas por ejecución con imagen (con el conjunto anterior, 2 a 3). Una secuencia de dígitos mal leída mueve hasta 10 facturas a la vez. Con dos conjuntos y un modelo, esto muestra que el conjunto pesa más que los otros dos efectos, no por qué una secuencia concreta es difícil de leer.
- Los importes también pueden fallar. En 4 de las 8 ejecuciones repetidas al menos un importe estaba mal. Las comprobaciones de sumas marcaron 2 de esas 4 facturas; 2 quedaron en silencio. La ejecución que presento no tuvo ningún importe de cabecera equivocado, así que “casi nunca el dinero” vale ahí, pero no en todas las ejecuciones.
¿Qué no probé?
- La importación propia de Excel (Power Query “From PDF”, Data from Picture).
- Facturas reales de proveedores. Las 30 son ficticias: 3 diseños, una fuente, una página cada una.
- Facturas de varias páginas, otros idiomas, fotos y ruido real de escáner.
- OCR alimentando el script de reglas. La referencia para los escaneos es el script solo.
- Cualquier modelo que no sea Haiku 5.5.
- Reglas sobre un diseño para el que no se ajustaron.
¿Qué haría con facturas reales?
Es mi lectura de los números, no un resultado medido. Compruebe primero la capa de texto. Para pocos proveedores con PDF de texto, las reglas son más baratas, más rápidas y, en esta prueba, exactas. Para muchos diseños, diseños desconocidos o escaneos, use un modelo, pase el dígito de control del número de IVA y las comprobaciones aritméticas, y haga que una persona mire lo que marcan y las descripciones, que ninguna de mis comprobaciones cubre.
Los scripts, las facturas, los archivos con los valores verdaderos, los resultados y el libro de Excel están en este archivo comprimido. Dentro van los 60 PDF y las respuestas en bruto del modelo, así que la puntuación y el libro se reconstruyen sin clave de API. Mi prototipo de extracción de facturas funciona con datos de ejemplo.
Si aún está decidiendo qué parte de su empresa merece la pena automatizar, le ayudo a elegirla y después la construyo: vea Consultoría de IA para pymes. Los mensajes de clientes son el otro primer trabajo habitual de la IA en una pequeña empresa: cuánto cuesta un chatbot de WhatsApp con IA por respuesta, con la tarifa de Meta incluida.
Ver también: Gestor documental para pymes: 7 opciones con precios.
Mi caso similar
Construí un servicio que convierte un certificado inmobiliario que tardaba 2–3 semanas y costaba EUR 200–300 en uno que tarda 2–3 minutos y cuesta EUR 99, con scripts e IA de visión. La construcción está en el caso de la automatización de documentos inmobiliarios.
Si las facturas deben llegar a su hoja de cálculo o a su herramienta de contabilidad sin que nadie las reescriba, lo construyo en la automatización de procesos.
¿Pasa las facturas a una hoja de cálculo a mano? Escríbame y encontraremos la mejor opción para usted.
¿Sigue pasando las facturas a mano?
Cuénteme lo que tiene ahora y lo que necesita. Le responderé con la opción que yo elegiría.
Escríbame