Kort sagt
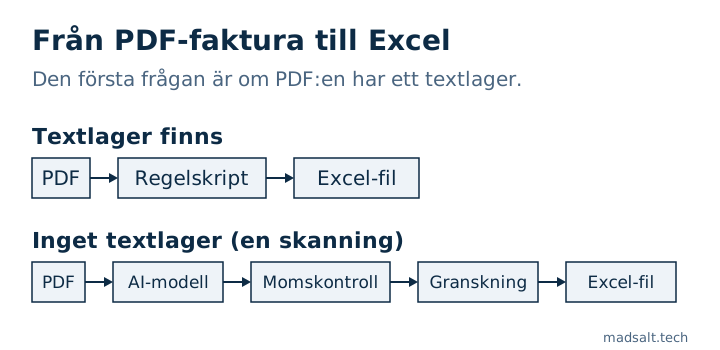
Ska du konvertera en PDF-faktura till Excel, kontrollera först om PDF:en har ett textlager. Har den det läste ett kort skript utan AI alla mina 30 testfakturor rätt, både fälten överst och alla 113 fakturarader, med en median på 0,03 sekunder per faktura. På en skanning returnerar samma skript ingenting, och då behöver du en modell. I den körning jag rapporterar läste Claude Haiku 5.5 netto-, moms- och bruttosumman rätt på alla 30 skanningar men läste siffror fel i momsnummer, fakturanummer och beskrivningar, samt två radbelopp: 4 av 30 fakturor helt rätt, 12 om man bortser från tecken som liknar varandra. De aritmetiska kontrollerna fångade 2 av de 18 felaktiga fakturorna. En kontrollsiffra på momsnumret fångade 16 av de 18, och 17 av 18 tillsammans med de aritmetiska kontrollerna.
Jag heter Denys och är full-stack- och AI-ingenjör. Jag ville veta vad som fungerar när man hämtar data från en PDF-faktura till Excel, och hur ofta det blir fel. Så jag körde jobbet själv, från början till slut, på 30 fiktiva leverantörsfakturor som de i mitt tidigare test av fyra AI-modeller: 10 tjeckiska, 10 tyska, 10 portugisiska, sammanlagt 113 fakturarader. Företagsnamnen innehåller exempelord (Vzor, Muster, Beispiel, Exemplo), varje faktura har en SAMPLE-sidfot, och momsnumren är uppslagna i EU:s VIES-tjänst, som svarade “inte giltigt” för alla. Den här gången är det PDF:er, fakturaraderna är med och resultatet hamnar i en Excel-arbetsbok.
Hur ser du om en PDF är text eller en skanning?
En PDF som skrivits ut från ett bokföringsprogram innehåller själva texten, ett textlager. En skannad PDF är en bild av en sida inpackad i en PDF-fil, utan någon text. Kan du markera ett ord med musen är det en text-PDF.
Jag gjorde båda sorterna av varje faktura, 60 PDF:er totalt. Alla 30 text-PDF:er hade ett textlager. Från alla 30 skanningar hämtade ett PDF-bibliotek 0 tecken. Skanningarna är min simulering från det tidigare testet (rotation, suddighet, brus, kraftig JPEG-komprimering), inte papper genom en skanner.
Kan du konvertera en PDF-faktura till Excel utan AI?
Ja. Jag skrev ett Python-skript med pdfplumber, ett gratis bibliotek som läser textlagret: en uppsättning etiketter per språk, momsnummer hittade genom att läsa sidans två halvor var för sig (leverantör till vänster, köpare till höger) och ett reguljärt uttryck per fakturarad. Det är 94 rader för 3 layouter.
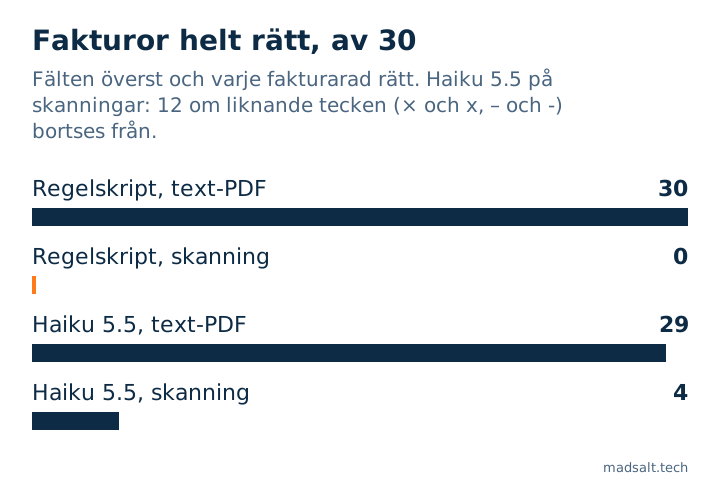
Resultat på text-PDF:erna: 30 av 30 fakturor helt rätt, 0 fel bland de 270 fälten överst på fakturorna, 113 av 113 fakturarader rätt, en median på 0,03 sekunder per faktura och ingen kostnad.
Förbehållet är stort. Jag skrev reglerna medan jag tittade på just de här 30 fakturorna, så det är bästa fallet för regler. Varje ny leverantörslayout kräver nya regler, och jag testade inga andra layouter. Två saker reglerna var tvungna att hantera:
- Läsordning. På alla 30 fakturor, i alla tre layouterna, kommer köparens momsnummer före leverantörens i textlagret, så “ta det första momsnumret” byter plats på dem. Skriptet läser sidans vänstra och högra halva var för sig.
- Prefix på momsnumret. Portugisiska fakturor skriver numret med eller utan
PT. Jag jämför utan prefixet: 8 fakturor avviker bara på den punkten från det rätta värdet.
Vad händer när PDF:en är en skanning, och behöver du faktura-OCR?
Skriptet misslyckas utan ett ljud. På de 30 skanningarna returnerade extract_text() en tom sträng varje gång, anropet lyckades och alla 270 fält överst på fakturorna kom tillbaka tomma. Inget fel kastades.
För skanningar skickade jag varje PDF till Claude Haiku 5.5 via OpenRouter, som läser PDF:en direkt utan ett separat OCR-steg. Temperatur 0, ett JSON-svar per faktura: de nio fälten överst plus fakturaraderna (beskrivning, antal, á-pris, belopp).
| Metod och indata | Fakturor helt rätt | Fakturarader rätt |
|---|---|---|
| Skript, text-PDF | 30 av 30 | 113 av 113 |
| Skript, skanning | 0 av 30 | 0 av 113 |
| Haiku 5.5, text-PDF | 29 av 30 | 112 av 113 |
| Haiku 5.5, skanning, exakt | 4 av 30 | 76 av 113 |
| Haiku 5.5, skanning, liknande tecken bortsett från | 12 av 30 | 108 av 113 |
“Helt rätt” betyder att de nio fälten överst och varje fakturarad stämmer. På text-PDF:erna var Haikus enda miss en beskrivning, Europaletten i stället för Europalette; fälten överst var rätt på 30 av 30. På skanningarna hade 14 av 30 fakturor alla nio fälten överst rätt.
Vad läste modellen fel på skanningarna?
För det mesta inte pengarna. Utfärdandedatum, förfallodatum, valuta, netto, moms och brutto: 0 fel över alla 30 fakturor i den här körningen. Antal, á-pris och belopp: 111 av 113 rätt. Felen var för det mesta text:
- Fälten överst: 21 felaktiga fält i 16 fakturor, alla i momsnummer. Leverantörens momsnummer 6 gånger, köparens momsnummer 15 gånger.
- Fakturarader: 37 av 113 inte helt rätt. 32 avviker bara typografiskt:
×returnerat somx,–som-,µ(mikrotecknet) somμ(grekiskt my). 5 är riktiga felläsningar: 3 beskrivningar (fita estiráveli stället förfilme estirável, alla på en portugisisk faktura) och 2 belopp (184,00läst som164,00,1.376,67som1.378,67).
Varför var de aritmetiska kontrollerna nästan tysta?
Jag lade in två kontroller i arbetsboken som kolumner: fakturaraderna summerar till nettosumman, och netto plus moms är lika med brutto, båda inom 0,01. På modellens skanningar flaggade de 2 av de 18 fakturor som verkligen var fel (2 av 26 när typografi räknas som fel), de två med ett felläst radbelopp. Beloppen överst var rätt, så summorna stämde. En kontroll på tal kan inte se en fel siffra i ett id eller ett ord. Det tidigare testet hittade samma mönster: dess summakontroll flaggade 3 av 63 felaktiga fakturor.
På skriptets tomma utdata slog båda kontrollerna till för 30 av 30. En tolkning som inte ger något misslyckas åtminstone högljutt i kalkylbladet.
En tredje kontroll, en kontrollsiffra på momsnumret (python-stdnum för det tjeckiska DIČ, det tyska USt-IdNr. och det portugisiska NIF), fångade 16 av de 18 felaktiga fakturorna och gav inget falsklarm på någon rätt. Inget felaktigt momsnummer klarade den. Tillsammans med de aritmetiska kontrollerna blir det 17 av 18. Den som återstod var en portugisisk faktura där bara beskrivningar var fellästa, och den kräver en människa med PDF:en öppen bredvid raden.
Hur ska Excel-filen se ut?
Två blad. Invoices har en rad per faktura: filnamn, fakturanummer, utfärdande- och förfallodatum, leverantörens och köparens momsnummer, valuta, netto, moms och brutto, antal rader och radsumma samt de tre kontrollkolumnerna. Lines har en rad per fakturarad: filnamn, fakturanummer, radnummer, beskrivning, antal, á-pris och belopp. Fakturanumret binder ihop dem. En platt rad per faktura fungerar inte, eftersom antalet rader varierar och min längsta faktura har nio.
Tal ska in som tal och datum som datum. Ett tjeckiskt 175 011,84 Kč eller ett tyskt 10.465,61 € måste konverteras innan det skrivs, annars behandlar Excel det som text och en summa hoppar över det. Jag öppnade den sparade filen igen och kontrollerade typen på 2 256 celler: datum, belopp, antal och kontrollresultat hade alla rätt typ, och 0 var lagrade som text. Ytterligare 300 celler var tomma, nämligen raderna där skriptet inte hittade något.
Jag läste tillbaka filen med ett bibliotek och öppnade den inte i Excel eller LibreOffice, och kontrollerna är värdena TRUE eller FALSE, inte formler.
Vad kostar det och hur lång tid tar det?
Skriptet kostar ingenting och tar 0,03 sekunder per faktura. För Haiku 5.5 använde jag OpenRouters fakturerade kostnad per anrop:
| Haiku 5.5 | USD per 1 000 fakturor | Median sekunder per faktura |
|---|---|---|
| Text-PDF | 0,58 | 2,96 |
| Skanning | 0,72 | 4,31 |
| Båda samlat | 0,65 | 3,66 |
Hela körningen var 60 anrop och USD 0,038847 (133 197 tokens in, 51 055 ut), utan ett enda misslyckat anrop, omförsök eller svar som inte gick att läsa. Tiderna inkluderar nätverk och modellens resonerande, med 8 anrop igång samtidigt.
Vad påverkar skanningsresultatet?
Samma modell på samma skanningar ger inte ett enda tal. För att se vad som spelar roll upprepade jag skanningstestet på den här uppsättningen: bara skanningarna, temperatur 0, två upprepningar per villkor, 240 anrop till för USD 0,145779. Villkoren var indatan (sidan som bild eller som PDF) och prompten (de nio fälten överst, eller fälten plus fakturarader). Fakturor med alla nio fälten överst rätt, av 30:
| Villkor | Körning 1 | Körning 2 |
|---|---|---|
| Bild, bara fälten överst | 13 | 14 |
| Bild, fält och fakturarader | 14 | 14 |
| PDF, bara fälten överst | 13 | 13 |
| PDF, fält och fakturarader | 15 | 12 |
Den körning jag rapporterar ovan är en femte PDF-körning med fält och fakturarader: 14. Fyramodellstestet med bilder gav också Haiku 14 på de här skanningarna.
- Indatavägen: ingen synlig effekt. Bildkörningarna gav 13, 14, 14, 14 och 14 (medelvärde 13,8), PDF-körningarna 13, 13, 15, 12 och 14 (medelvärde 13,4). Spannen överlappar nästan helt.
- Promptens storlek: ingen synlig effekt. Bara fälten överst gav 13, 14, 13 och 13; fält och fakturarader 14, 14, 15, 12 och 14.
- Från körning till körning: 0 till 3 fakturor mellan upprepningar av samma villkor.
- Fakturauppsättningen är den största faktorn. Med samma modell och samma bildprompt gav en tidigare uppsättning om 30 fakturor 22 och 22. Den här ger 13 och 14. Varje land har ett köpar-momsnummer som upprepas på 10 fakturor, och på den här uppsättningen läser Haiku det fel på 11 till 13 av 30 fakturor per bildkörning (på den tidigare uppsättningen 2 till 3). En felläst sifferföljd flyttar upp till 10 fakturor på en gång. Med två uppsättningar och en modell visar det här att uppsättningen väger tyngre än de två andra effekterna, inte varför en viss sifferföljd är svår att läsa.
- Belopp kan bli fel. I 4 av de 8 upprepade körningarna var minst ett belopp fel. Summakontrollerna flaggade 2 av de 4 fakturorna; 2 förblev tysta. Den körning jag rapporterar hade inget felaktigt belopp överst, så “för det mesta inte pengarna” gäller där, men inte i varje körning.
Vad testade jag inte?
- Excels egen import (Power Query “Från PDF”, Data från bild).
- Riktiga leverantörsfakturor. Alla 30 är fiktiva: 3 layouter, ett typsnitt, en sida vardera.
- Fakturor över flera sidor, andra språk, mobilfoton och äkta skannerbrus.
- OCR som matar regelskriptet med text. Utgångsläget för skanningar är skriptet ensamt.
- Andra modeller än Haiku 5.5.
- Regler på en layout de inte var anpassade till.
Vad skulle jag göra med riktiga fakturor?
Det här är min läsning av siffrorna, inte ett uppmätt resultat. Kontrollera textlagret först. För några få leverantörer med text-PDF:er är regler billigare, snabbare och i det här testet exakta. För många eller okända layouter, eller för skanningar, använd en modell, kör kontrollsiffran på momsnumret och de aritmetiska kontrollerna och låt en människa titta på det som flaggas och på beskrivningarna, som ingen av mina kontroller täcker.
Skripten, fakturorna, facitfilerna, resultaten och arbetsboken finns i det här arkivet. De 60 PDF:erna och de råa modellsvaren ligger inuti, så poängsättningen och arbetsboken kan byggas om utan en API-nyckel. Min prototyp för fakturatolkning körs på exempeldata.
Om du fortfarande funderar på vilken del av företaget som är värd att automatisera hjälper jag dig att välja den och bygger den sedan: se AI-konsult för småföretag. Kundmeddelanden är det andra vanliga första jobbet för AI i ett litet företag: vad en WhatsApp-chatbot med AI kostar per svar, med Metas avgift inräknad.
Se även: Bästa dokumenthanteringssystem för småföretag: 8 priser.
Mitt liknande fall
Jag byggde en tjänst som gör ett fastighetsintyg som tog 2–3 veckor och kostade EUR 200–300 till ett som tar 2–3 minuter och kostar EUR 99, med skript och vision-AI. Bygget finns i caset om automatisering av fastighetsdokument.
Ska fakturorna nå ditt kalkylblad eller ditt bokföringsprogram utan att någon skriver av dem, bygger jag det under processautomation.
Flyttar du fakturor in i ett kalkylblad för hand? Skriv till mig, så tar vi fram det bästa alternativet för dig.
Flyttar du fortfarande fakturor för hand?
Berätta vad du har nu och vad du behöver. Jag svarar med det alternativ jag själv skulle välja.
Skriv till mig