En bref
Pour l’extraction de données de factures, sur des factures numériques nettes, trois des quatre modèles testés ont lu les neuf champs sans erreur sur 30 factures sur 30. Sur des scans simulés des mêmes factures, le meilleur en a réussi 22 sur 30. Les erreurs ne portaient presque jamais sur les montants. Elles portaient sur les numéros de TVA et les numéros de facture, et le filet de sécurité habituel, vérifier que le net plus la TVA égale le total, n’a signalé que 3 des 63 factures fausses. Deux règles simples sur les numéros de TVA ont détecté 31 des 32 factures fausses des trois meilleurs modèles. Le modèle le moins cher a coûté USD 0,43 pour 1 000 factures, mais sur les scans il n’égalait plus le modèle 17 fois plus cher : 14 sur 30 contre 22. Gemini 3.8 Flash a égalé les 22 de Sonnet pour environ la moitié du prix.
J’ai refait ce test le 22 octobre 2026 sur un nouvel ensemble de factures fictives. Tous les chiffres de cet article viennent de ce nouveau passage.
Je suis Denys, ingénieur full-stack et IA. J’ai construit plus tôt cette année un prototype d’extraction de factures : une application web et une API qui transforment des factures PDF en champs, avec les champs incertains signalés à une personne. Il tourne sur des données d’exemple, sans modèle derrière. Avant d’écrire sur l’extraction de données de factures, j’ai donc fait un vrai test : 30 factures fictives de fournisseurs tchèques, allemands et portugais, quatre modèles, 240 appels, USD 0,76 d’utilisation facturée.
Que lit bien et mal l’IA sur des factures ?
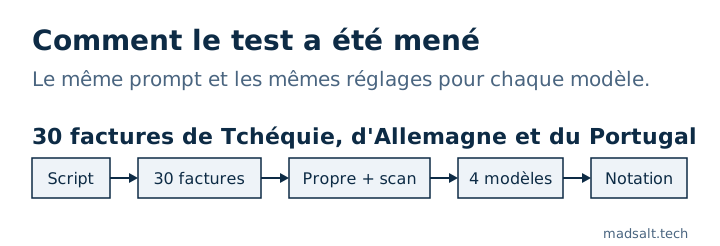
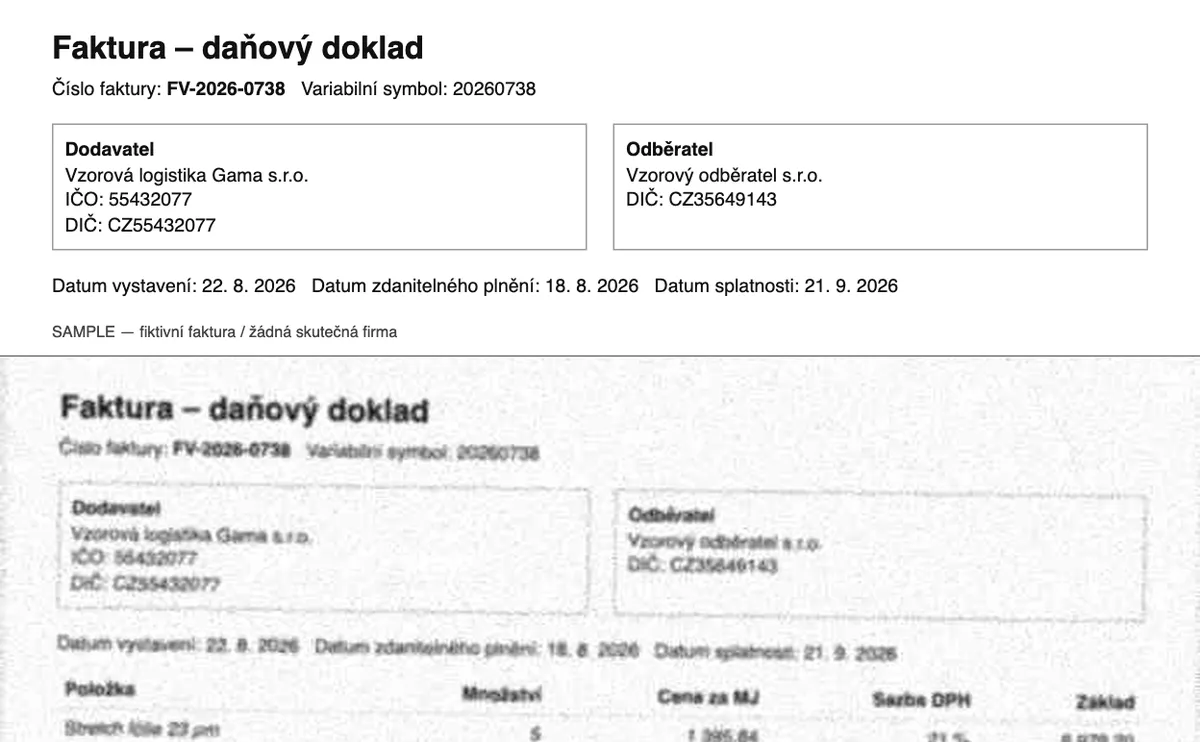
Chaque modèle a lu chaque facture deux fois : en rendu net, tel qu’un PDF sorti d’un logiciel de comptabilité, et en scan simulé, grisé, légèrement pivoté, flou et compressé. Une facture n’est juste que si les neuf champs correspondent : numéro de facture, date d’émission, date d’échéance, numéro de TVA du fournisseur, numéro de TVA de l’acheteur, devise, total HT, total de TVA et total TTC.
| Modèle | Net, 9 champs justes | Scan, 9 champs justes | USD pour 1 000 factures | Secondes médianes par facture |
|---|---|---|---|---|
| Claude Haiku 5.5 | 30 sur 30 | 14 sur 30 | 0,43 | 6,13 |
| Claude Sonnet 5.5 | 30 sur 30 | 22 sur 30 | 7,18 | 8,50 |
| Gemini 3.8 Flash | 30 sur 30 | 22 sur 30 | 3,51 | 8,43 |
| GPT-5.6 Luna | 29 sur 30 | 0 sur 30 | 1,52 | 10,85 |
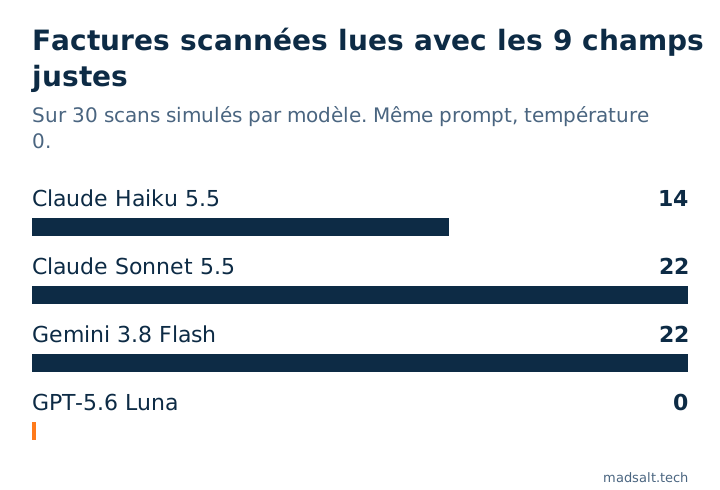
Le coût est ce qu’OpenRouter a facturé pour chaque appel, pas une estimation d’après la grille tarifaire. Sur les factures nettes, Claude Haiku 5.5 et Claude Sonnet 5.5 ont été aussi justes, 30 sur 30. Sur les scans, Sonnet en a lu 22 justes contre 14 pour Haiku, et a coûté environ 17 fois plus.
Faut-il encore de l’OCR pour extraire les données d’une facture ?
Pas comme étape séparée, dans ce test. Les quatre modèles ont reçu la page sous forme d’image et ont renvoyé directement les neuf champs, sans couche d’OCR entre les deux. Ce qui change le résultat, c’est la qualité de la page. Un PDF net sorti d’un logiciel de comptabilité a une couche de texte, un scan n’en a pas : il n’est fait que de pixels. La colonne « Scan » du tableau ci-dessus est exactement la question de la qualité d’OCR, et c’est là que les modèles diffèrent : le meilleur a lu juste 22 des 30 factures scannées, le plus faible aucune.
Je n’ai pas testé de moteurs d’OCR classiques ni d’outils à modèles, donc je ne peux pas dire comment ils s’en sortiraient sur les mêmes 30 factures. Ce que le test montre, c’est où se situe le risque quand un modèle lit un scan : dans les numéros de TVA et les numéros de facture, que les contrôles ci-dessous détectent.
Comment le test était-il monté ?
J’ai généré les factures avec un script, donc chaque valeur exacte est connue au centime. Les factures sont fictives : les noms d’entreprise portent Vzor, Muster, Beispiel ou Exemplo, et chaque facture a un pied de page dans la langue locale disant « SAMPLE - fictitious invoice / no real company ». Chacune porte les pièges que rencontre un comptable fournisseurs dans le pays concerné :
- Formats de nombres locaux.
175 011,84 Kčen tchèque,10.465,61 €en allemand, et à la fois1 234,56et1.234,56sur les factures portugaises. - Un second identifiant à côté du numéro de facture. Le symbole variable tchèque, le numéro client allemand, le code ATCUD portugais.
- Une seconde date. La date de livraison imposable tchèque et la date de prestation allemande figurent à côté de la date d’émission.
- Deux numéros de TVA sur une même page, plus un numéro fiscal allemand (Steuernummer) qui ressemble à un numéro de TVA et n’en est pas un.
- Des cas difficiles. Taux de TVA mixtes, une facture sans TVA, une facture en autoliquidation, un avoir avec montants négatifs et une facture de neuf lignes dans chaque pays.
Chaque numéro de TVA a une clé de contrôle valide, vérifiée avec la bibliothèque python-stdnum, et aucun n’est enregistré : j’ai cherché chacun des 33 numéros utilisés (30 numéros de fournisseur et un numéro d’acheteur par pays) dans le service VIES de l’UE, qui a répondu « non valide » pour tous. J’ai aussi cherché les 11 numéros d’entreprise tchèques qui se cachent derrière les numéros tchèques dans le registre tchèque des entreprises, ARES, et je ne les ai pas trouvés. Les quatre modèles ont reçu le même prompt, à température 0, un appel par image.
Pourquoi le contrôle des totaux n’a-t-il presque rien détecté ?
Vérifier que le net plus la TVA égale le total TTC est la première règle qu’ajoutent la plupart des chaînes d’extraction, et celle qu’utilise mon prototype. Dans ce test, elle a signalé 3 des 63 factures fausses, tous modèles confondus : un scan de Gemini 3.8 Flash (cz06, total TTC faux), un scan de GPT-5.6 Luna (cz08, où la date d’émission, le numéro de TVA de l’acheteur, le HT et la TVA étaient faux) et une facture nette de Luna (pt02, total HT faux).
La raison tient à l’endroit où se trouvaient les erreurs. Claude Haiku 5.5, Claude Sonnet 5.5 et Gemini 3.8 Flash ont fait à eux trois 32 extractions fausses, et seulement deux avaient un montant faux : le scan de Gemini ci-dessus, et un scan de Haiku (cz09) où les totaux HT et TVA étaient légèrement décalés mais où HT plus TVA égalait encore le TTC, si bien que le contrôle est resté silencieux. Les autres avaient un chiffre mal lu dans un numéro de TVA, ou dans un numéro de facture, comme FV-2026-0738 lu FV-2026-0758. GPT-5.6 Luna s’est bien trompé de montants sur 7 factures, et sur 5 d’entre elles son net, sa TVA et son TTC concordaient quand même. Un modèle lit un total cohérent avec le reste de ce qu’il a lu, si bien qu’un contrôle arithmétique laisse passer la plupart de ses erreurs.
Quels contrôles attrapent les erreurs ?
Deux règles sur les numéros de TVA, chacune de quelques lignes de code :
- La clé de contrôle. Un numéro de TVA se termine par une clé calculée à partir des autres chiffres : modulo 11 pour le numéro d’entreprise tchèque derrière un DIČ et pour le NIF portugais, ISO 7064 pour l’USt-IdNr allemand. Des bibliothèques comme python-stdnum implémentent les trois. Un chiffre mal lu la fait presque toujours échouer.
- Votre propre numéro de TVA. Sur une facture reçue, l’acheteur, c’est vous. Tout numéro de TVA d’acheteur qui n’est pas le vôtre est faux, ou la facture ne vous était pas destinée.
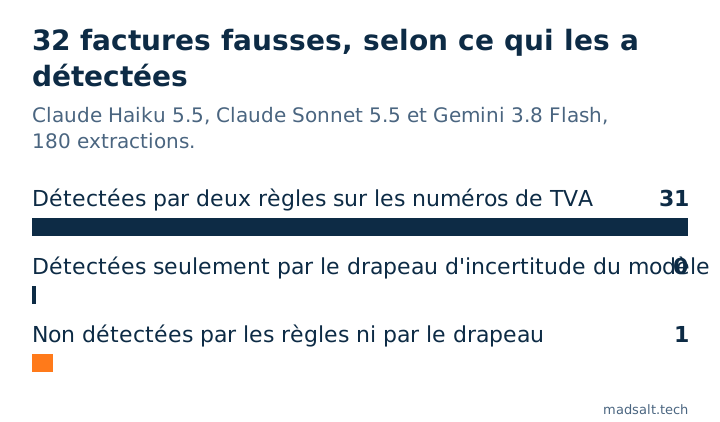
La dernière, le scan cz06 de Gemini, avait un total TTC faux. Aucune règle sur les numéros de TVA ne peut le voir, et Gemini ne liste jamais de champs incertains : seul le contrôle des totaux l’a détecté. J’ai demandé à chaque modèle de lister les champs dont il n’était pas sûr :
| Modèle | Factures fausses | Attrapées par les deux règles | Attrapées seulement par son drapeau d’incertitude | Non attrapées | Factures justes qu’il a quand même signalées |
|---|---|---|---|---|---|
| Claude Haiku 5.5 | 16 | 16 | 0 | 0 | 13 sur 44 |
| Claude Sonnet 5.5 | 8 | 8 | 0 | 0 | 19 sur 52 |
| Gemini 3.8 Flash | 8 | 7 | 0 | 1 | 0 sur 52 |
| GPT-5.6 Luna | 31 | 30 | 0 | 1 | 0 sur 29 |
Gemini 3.8 Flash n’a jamais listé un champ comme incertain, donc avec lui les contrôles sont tout ce que vous avez ; ici les deux règles ont détecté 7 de ses 8 factures fausses et le contrôle des totaux la huitième. Les modèles Claude ont signalé trop plutôt que trop peu : Haiku a signalé 13 de ses 44 factures justes (30 %) et Sonnet 19 de 52 (37 %), toutes des scans ; aucun n’a signalé une seule facture nette. C’est le compromis qu’on veut en comptabilité fournisseurs, où le coup d’œil d’un comptable coûte moins qu’un paiement erroné.
Deux autres choses sont apparues. Les erreurs de GPT-5.6 Luna ne se limitaient pas aux numéros : sur ses 31 factures fausses, 30 étaient des scans, 20 avaient un numéro de facture faux, 13 une date d’émission fausse et 15 une date d’échéance fausse, et 15 champs de montant étaient faux sur 7 factures. Son unique facture de la colonne « non attrapées » est une facture nette, pt02, avec un total HT faux : les deux règles et son drapeau d’incertitude l’ont manquée, le contrôle des totaux non. Et une clé de contrôle ne peut pas attraper toutes les erreurs de lecture, car certains numéros faux sont valides aussi ; dans ce passage, aucun numéro de TVA faux n’a passé les deux règles.
Quel modèle choisir pour l’extraction de données de factures ?
Sur cet ensemble, voici les résultats sur scans : Claude Sonnet 5.5 22 sur 30 avec 8 factures fausses à USD 7,18 pour 1 000 ; Gemini 3.8 Flash aussi 22 sur 30 avec 8 factures fausses à USD 3,51, environ la moitié du prix ; Claude Haiku 5.5 14 sur 30 avec 16 fausses à USD 0,43. Gemini a égalé Sonnet en exactitude pour environ la moitié du prix, mais il ne liste jamais de champs incertains : ses factures fausses ont été détectées par les deux règles sur les numéros de TVA (7) et par le contrôle des totaux (1), alors que Sonnet a aussi signalé 19 de ses 52 factures justes. Avec les contrôles en place, aucune des factures fausses de Haiku ou de Sonnet n’est restée silencieuse : le modèle le moins cher signifie donc plus de factures fausses à corriger (16 contre 8), pas plus d’erreurs dans le grand livre. Si vous envoyez chaque facture à un modèle, le modèle est rarement le gros poste de coût ; le prix d’un agent IA fonctionne de la même façon. GPT-5.6 Luna est inutilisable sur des scans dans ce test.
Ce classement vient d’un seul test sur 30 factures. Passez vos propres factures dans deux ou trois modèles avant d’en choisir un.
Faut-il vraiment un modèle ?
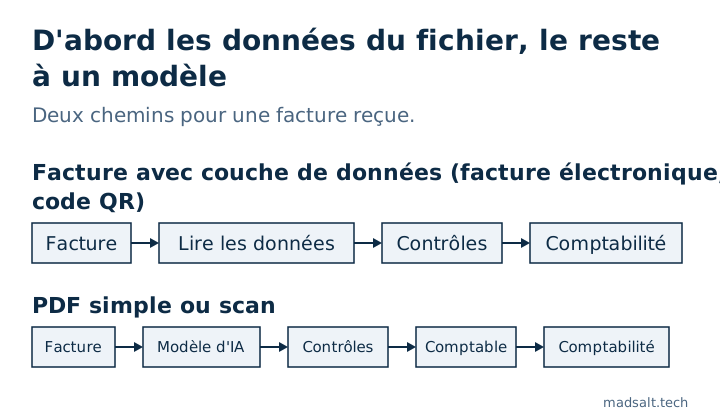
Souvent non, et dans certains pays de moins en moins chaque année. Avant d’envoyer l’image d’une facture à un modèle, vérifiez si les données sont déjà dans le fichier :
- France. Depuis le 1er septembre 2026, toute entreprise doit pouvoir recevoir des factures électroniques ; les grandes et moyennes entreprises en émettent à partir de cette date, les PME et les microentreprises à partir du 1er septembre 2027. Un simple PDF envoyé par e-mail n’est plus conforme entre entreprises françaises (impots.gouv.fr).
- Portugal. Toute facture émise par un logiciel certifié doit porter un code QR avec les deux NIF, la date, le numéro de facture, l’ATCUD, ainsi que la base imposable et la TVA par taux (Portaria n.º 195/2020, spécification du code QR de l’AT). Lire le code QR vous donne exactement la plupart des champs.
- Allemagne. Depuis le 1er janvier 2025, un simple PDF ne compte plus comme facture électronique entre entreprises allemandes. Les factures papier et PDF restent permises pendant une période de transition, qui prend fin pour toutes les entreprises à la fin de 2027 (FAQ du ministère fédéral des Finances). Les factures XRechnung et ZUGFeRD contiennent des données structurées lisibles directement.
- Tchéquie. De nombreux outils de comptabilité intègrent une couche de données ISDOC dans le PDF ; Fakturoid l’ajoute à toutes ses factures PDF depuis décembre 2022 (Fakturoid).
L’ordre qui fonctionne est donc : lire la couche de données s’il y en a une, n’envoyer que le reste à un modèle, puis lancer les contrôles. Le modèle est le recours, pas la première étape.
Comment les champs arrivent-ils dans Excel ou votre logiciel de comptabilité ?
L’archive indiquée plus bas contient déjà un CSV avec tous les résultats, une ligne par extraction, il s’ouvre donc tel quel dans Excel. Mon prototype d’extraction de factures fonctionne de la même façon au niveau de l’application : il exporte les champs validés et expose un appel d’API qui prend un PDF et renvoie les champs en JSON pour chaque facture.
À partir de là, un fichier CSV ou XLSX peut être importé dans un logiciel de comptabilité qui accepte les imports de fichiers, ou le JSON peut être transmis par un petit script. Le prototype tourne sur des données d’exemple, et je ne l’ai relié à aucun logiciel de comptabilité en particulier. Pour un passage de PDF à Excel qui inclut les lignes de facture et un classeur à deux feuilles, voir Transformer une facture PDF en Excel : IA ou simple script ?.
Si vous cherchez encore quelle partie de votre entreprise vaut la peine d’être automatisée, je vous aide à la choisir puis je la construis : voir Consultant IA pour PME. Les messages clients sont l’autre premier chantier IA courant dans une petite entreprise : combien coûte un chatbot WhatsApp avec IA par réponse, frais de Meta compris.
Que ne prouve pas ce test ?
- Les factures sont fictives. Une mise en page par pays, générée par un script, avec des noms d’entreprise d’exemple. Les vraies factures de fournisseurs varient bien davantage.
- Les scans sont simulés. Flou, rotation, bruit et compression JPEG sur un rendu net, pas du papier passé au scanner ni une photo prise au téléphone.
- Un appel par facture, un ensemble de 30. Les résultats varient beaucoup d’un ensemble à l’autre. Cet article avait d’abord été fait sur un autre ensemble de 30 factures, où les résultats sur scans de Haiku, Sonnet et Gemini étaient 22, 22 et 17 sur 30 ; sur cet ensemble, ils sont 14, 22 et 22. Chaque pays a un numéro de TVA d’acheteur répété sur 10 factures, donc une seule chaîne mal lue peut casser jusqu’à 10 factures à la fois.
- Les prix changent. Les coûts sont ceux qu’OpenRouter a facturés le 22 octobre 2026.
- Neuf champs seulement. Ni lignes de facture, ni IBAN, ni conditions de paiement.
Comment le refaire sur vos propres factures
- Choisissez 30 à 50 vraies factures, y compris les pires scans que vous recevez. Notez à la main les valeurs exactes.
- Utilisez un seul prompt et un schéma de sortie fixe avec une liste de champs incertains, à température 0.
- Faites tourner deux ou trois modèles et notez le coût facturé par appel, pas le prix catalogue.
- Notez des factures entières, pas des champs isolés : un seul chiffre faux dans un numéro de TVA fait une facture fausse.
- Ajoutez la règle de la clé de contrôle et celle de votre propre numéro de TVA, et mesurez ce qu’elles attrapent.
- Lisez d’abord la couche de données partout où le logiciel de vos fournisseurs en fournit une.
Les scripts, les factures générées et tous les résultats sont dans une seule archive : le générateur, l’exécuteur, le script de notation et un CSV avec les 240 extractions. Si vous voulez intégrer cela à votre processus de comptabilité fournisseurs, cela relève de l’automatisation de workflows.
Si vous voulez ajouter une telle extraction à un processus que vous exploitez déjà, je m’en charge dans le cadre de Intégration d’IA dans des Produits Existants.
À lire aussi: Logiciel de gestion documentaire PME : 7 outils chiffrés.
Mon cas similaire
J’ai construit un service qui transforme une attestation immobilière qui prenait 2 à 3 semaines et coûtait EUR 200–300 en une attestation qui prend 2 à 3 minutes et coûte EUR 99, avec des scripts et de l’IA de vision. La construction est dans le cas de l’automatisation des documents immobiliers.
Vous extrayez les données de factures à la main ou avec un outil auquel vous ne faites pas confiance ? Écrivez-moi et nous trouverons la meilleure option pour vous.
Vous saisissez encore les données de factures à la main ?
Dites-moi ce que vous avez aujourd'hui et ce qu'il vous faut. Je vous répondrai avec l'option que je choisirais.
Me contacter