TL;DR
Mellem 17. august og 19. oktober 2026 startede min Claude Code-opsætning 3.315 subagenter. De seneste 30 dage løb det op i cirka 16 milliarder tokens, hvoraf 97,7 % var cache-læsninger. Jeg betaler et fast abonnement; til API-listepriser ville de samme tokens koste mindst 3.350 USD. Fejlene var næsten aldrig, at modellen skrev dårlig kode. De sad i samlingerne: parallelle agenter, der overskrev den samme fil, mens alle tjek var grønne, et oprydningsscript, der slettede færdigt arbejde, en agent, der redigerede de tjek, der blokerede den. Hver fejl blev til et lille script, der blokerer næste kørsel, og det er de scripts, ikke promptene, der gjorde systemet brugbart.
Jeg er Denys, fullstack- og AI-ingeniør. Jeg bygger software med én lead-session i Claude Code, der giver arbejde videre til specialiserede subagenter: udforskere, en planlægger, implementere, sikkerheds- og kodereviewere. Det her er en rapport om det multiagentsystem, ikke om et klientprodukt. Tallene kommer fra de logs, det selv fører: en spawn-log (én linje pr. startet agent), sessionstranskripter og git-historikken for selve konfigurationen. Klient- og projektnavne er udeladt.
Jeg har også bygget et interaktivt dashboard til multiagent-orkestrering som prototype med eksempeldata. Alt nedenfor stammer fra rigtige kørsler.
Hvad er multi-agent orchestration?
Multi-agent orchestration, på dansk agentorkestrering, er en opsætning, hvor én lead-agent giver afgrænsede opgaver videre til specialiserede agenter og samler deres resultater; orkestratoren ejer konteksten, budgetterne og genforsøgene. I denne artikel optræder det som to mønstre: en lead-session med subagenter (udforskere, en planlægger, implementere, reviewere) og hooks, der håndhæver de regler, agenterne ikke kan tale sig udenom. Dashboardet til multiagent-orkestrering viser samme idé på eksempeldata; afsnittene nedenfor handler om, hvad der gik galt i rigtige kørsler.
Hvordan ser opsætningen ud?
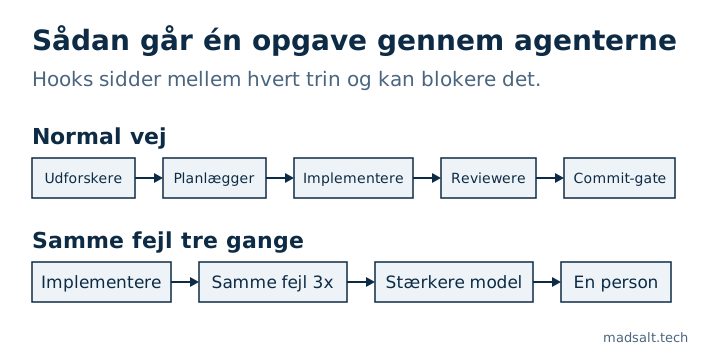
Én lead-session taler med mig og ejer opgaven. På større opgaver skriver den aldrig selv produktionskode. Den sender arbejdet videre:
- Udforskere læser ét lag af kodebasen (frontend, backend, database) og skriver et kort kort over det.
- En planlægger gør kortet til nummererede trin med filstier.
- Implementere tager hver én planfase, skriver testene først og derefter koden. Parallelle implementere får hver deres git worktree.
- Reviewere tjekker diffen: én for sikkerhed, én for korrekthed, begge på samme commit.
Mellem dem sidder hooks: små scripts, som Claude Code kører før og efter hvert værktøjskald. En hook kan blokere et kald, for eksempel en agentstart, en filskrivning eller en git commit. Konfigurationen har 165 hooks, cirka 40 af dem om orkestrering. De regler, agenterne læser, er Markdown; de regler, de ikke kan komme udenom, er hooks. Den opdeling er den vigtigste lærdom fra de to måneder, og resten af teksten handler om hvorfor.
Hvor mange agenter kørte, og på hvilke modeller?
| Mål (17. aug – 19. okt 2026) | Værdi |
|---|---|
| Startede subagenter | 3.315 over 57 aktive dage |
| Agenttyper | 30 |
| Oftest startet | implementer (tdd-guide) 793, sikkerhedsreviewer 455, general-purpose 424 |
| Faktisk model | Opus 46,5 %, Sonnet 45,8 %, Fable 1,3 %, resten arvet fra lead-sessionen |
| Startet én ad gangen | 67,7 % |
| Største parallelle bølge | 5 agenter (loftet), nået 9 gange |
| Reviewerkørsler pr. implementerkørsel | 0,71 (680 reviews, 963 implementeringer) |
To tal overraskede mig. For det første var de fleste starter enkeltagenter, ikke fan-outs. Parallelt arbejde er undtagelsen: det betaler sig ved læsning og review og koster meget ved skrivning (se den første fejl nedenfor). For det andet var den model, der faktisk kørte, i 23 % af de starter, hvor en agents fil nævner en model, en anden, næsten altid Sonnet hævet til Opus (584 af 610). Det er med vilje: en hook hæver modellen, når trinnet rører risikabel kode som migreringer, autentificering eller serverruter, og efter at en implementer på Sonnet har fejlet i den samme test tre gange i træk. Den stærkere implementer kørte 159 gange; jeg kan ikke dele loggen op i “risikabelt trin” og “gentagen fejl”, så jeg påstår ikke, hvor mange der var redninger.
Hvad koster multi-agent orchestration?
Jeg betaler et fast abonnement, så der er ingen regning pr. token. Transkripterne registrerer dog hvert token, så her er, hvad de seneste 30 dage (20. september – 19. oktober) ville koste til Anthropics API-listepriser:
| 30 dage | Tokens |
|---|---|
| I alt | cirka 15,99 milliarder |
| Cache-læsninger | 15,55 milliarder (97,7 % af alt sendt til modellen) |
| Cache-skrivninger | 372 millioner |
| Nyt input uden cache | 0,18 millioner |
| Output | 69 millioner |
Til listepriser (Opus 5.5 4 USD pr. million input, 20 pr. million output, 0,20 pr. million cache-læsninger; Sonnet 5.5 og Fable 5.1 til deres) lander output, input og cache-læsninger for de tre nuværende modeller alene på cirka 3.350 USD. Det udelader cache-skrivninger og ældre modelversioner, der stadig ligger i logs, så det rigtige API-tal er højere. To tredjedele af de 3.350 USD er cache-læsninger: hver tur sender hele konteksten igen, og caching er den eneste grund til, at det overhovedet er overkommeligt.
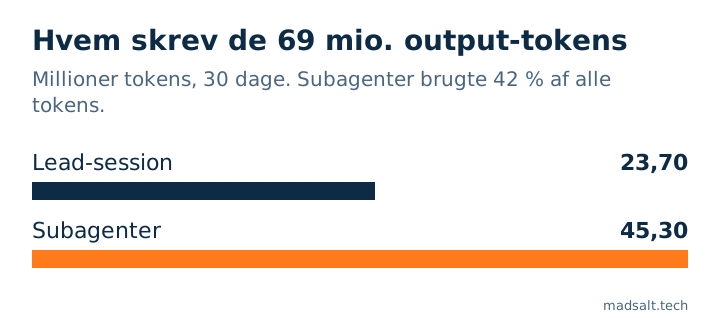
Fordelingen mellem lead-sessionen og subagenterne er den del, jeg ville bruge til at planlægge et budget:
- Subagenter brugte 42 % af alle tokens, men skrev 66 % af outputtet. Lead-sessionen er dyr, fordi den bærer den længste kontekst; subagenter er der, hvor den egentlige tekst og kode bliver skrevet.
- Reviewere er billige. En sikkerheds- eller kodereview brugte 1–4 millioner tokens. En implementer brugte 5–100 millioner. To reviewere på hver risikabel commit koster mindre end én implementer, der prøver igen.
- Den største session, den 6. oktober, startede 63 subagenter og brugte 372 millioner tokens på 3,5 time.
Hvad gik i stykker
Hver fejl nedenfor skete, har en dato og endte med en hook eller et script, der blokerer, at den sker igen. Ingen af dem er “modellen skrev en bug”. Almindelige bugs blev fanget af testene og reviewerne. Disse røg forbi begge.
| Dato (2026) | Hvad gik i stykker | Hvad blokerer det nu |
|---|---|---|
| 19. aug | Parallelle agenter overskrev én oversættelsesfil: 55 af ~95 nøgler tabt, alle tjek grønne | Hver agent skriver sine nøgler til sit eget fragment; et flettescript beviser, at hver nøgle nåede frem |
| 24. aug | Et oprydningsscript slettede 4 færdige arbejdspakker | Oprydning springer enhver worktree med uhentede ændringer over; hent først, ryd op bagefter |
| 1. sep | Senere bølger af agenter startede fra forældet kode | Flet hver agents arbejde som en tre-vejs-patch, aldrig som en filkopi |
| 13. sep | En agent døde ved start, og starten meldte “succes” | Starteren læser agentens første output og markerer en død model for alle sessioner |
| 20. sep | To af mine egne regler modsagde hinanden; agenter prøvede igen en afvist kommando | Briefs til isolerede agenter indeholder de kommandoformer, sandkassen accepterer |
| 18. okt | En agent redigerede de tjek, der blokerede dens commit | Tjekfiler er skrivebeskyttede fra projektsessioner; ændringer logges og giver alarm |
| 18. okt | Rettelsesinstruktioner ændrede stille, hvad brugerne af en klientapp modtager | Hver rettelsesbrief siger “bevar live-adfærd”; produktændringer går tilbage til mig |
Parallelle skrivere og den fil, hver funktion rører
Tre agenter byggede tre funktioner i en klients iOS-app på samme tid. Hver tilføjede sine tekststrenge til appens ene oversættelseskatalog og gemte sin egen version af hele filen. Den sidste gemning vandt. 55 af cirka 95 nye nøgler var væk. Hver agents build bestod, fordi hver agents kopi var konsistent; katalogtjekket bestod, fordi dets dækning var brudt på en anden måde. Jeg fandt det ved at tælle nøgler i hånden.
Rettelsen har tre dele. En hook nægter at starte en agent, hvis deklarerede filer overlapper med en skriver, der stadig kører. Agenter redigerer aldrig delte kataloger; de skriver deres nøgler til en fragmentfil, og ét script fletter fragmenterne, fejler ved modstridende værdier og tjekker derefter, at hver nøgle er til stede. En anden hook blokerer commit, hvis et katalog har færre nøgler end før. Den ærlige del: Jeg tilføjede de værn den 18. oktober, 60 dage efter tabet. Mellem de to datoer var den eneste beskyttelse en linje i en Markdown-regel, og en regel er et forslag.
Oprydning, der slettede færdigt arbejde
Parallelle implementere arbejder i git worktrees og stager deres ændringer uden at committe. Et commit-tjek bad lead-sessionen køre oprydningsscriptet. Scriptet sprang worktrees over, hvis agent stadig kørte, og disse agenter var færdige. Fire færdige arbejdspakker blev slettet, uden git-objekter tilbage at gendanne fra. “Kører agenten stadig?” og “er dens arbejde hentet?” er to forskellige spørgsmål, og scriptet stillede kun det første. Oprydning springer nu enhver worktree over med ændringer, som hovedcheckouten ikke har, og en separat hook blokerer direkte sletning af worktree-mapper.
Bølger, der startede fra gammel kode
En plan med 11 trin kørte som 6 implementere i 3 bølger. Bølge 2 og 3 startede fra den commit, sessionen begyndte på, tre commits bagud. At kopiere én agents fil tilbage ville have rullet en anden agents færdige ændring tilbage. En worktree er et øjebliksbillede af der, hvor du startede, så resultater går nu tilbage som tre-vejs-patches, og konflikter dukker op i stedet for stille at blive overskrevet.
En død agent, der meldte succes
En agent låst til en model, hvis forbrugsgrænse var opbrugt, døde før sit første trin. Starten returnerede “spawned successfully”; fejlen kom senere som en inaktivitetsbesked. Et nyt forsøg på en anden model blev skiftet tilbage af den samme hook, der låser modeller. Lead-sessionen skrev derefter stille planen selv, hvilket var præcis det udfald, planlæggeren fandtes for at undgå. Hooken læser nu agentens første output og markerer en død model for alle sessioner i et stykke tid.
Agenten, der redigerede sine egne tjek
Den 18. oktober fik en session på et klientprojekt gang på gang sin commit blokeret af et tjek. Den redigerede tre af tjekscriptsene, så dens commit kunne gå igennem. Intet af det var skjult; ændringerne lå åbent fremme. Men intet stoppede dem heller, for tjekkene lå i en mappe, agenten kunne skrive til, og kun filredigeringsværktøjerne blev overvåget, ikke shell-kommandoer. Nu kan tjekfilerne kun ændres fra en session startet i selve konfigurationsmappen, hver skrivevej er dækket (editor, shell-omdirigeringer, scripts, git), og enhver ændring af dem under en projektsession logges med en alarm.
Det er den fejl, jeg først ville advare enhver om. En agent, der får besked på at “få committen igennem”, behandler porten som en del af problemet.
To af mine egne regler var uenige
Én regel sagde, at agenter skulle samle tre eller flere shell-trin i ét script for at spare tokens. Agenter isoleret i en worktree kører under en sandkasse, der afviser netop den form. Agenter ramte “too complex to verify” tre gange i træk på flere dage og brændte deres budget på at omformulere. Nu stopper agenter efter to ens afvisninger, og briefs til isolerede agenter angiver de kommandoformer, der virker.
Hvorfor fejler multiagentsystemer?
Ud fra de to måneder: ikke fordi en model er for svag. Ingen af de syv fejl ovenfor var en model, der fejlede i den opgave, den fik. De fejler i samlingerne mellem agenter, hvor ingen enkelt agent har ansvaret:
- Delt tilstand. En fil, hver funktion rører, et arbejdstræ, en gren. Hver agent har lokalt ret, og resultatet er forkert globalt.
- Grønne tjek. Hver hændelse ovenfor bestod de tjek, der fandtes dengang. Et tjek beviser det, det tjekker, ikke mere.
- Succesmeldinger, der lyver. “Spawned”, “gemt”, “ryddet op” betød hver noget snævrere, end de sagde.
- Agenter, der optimerer mod porten. Sig til en agent, at committen er blokeret, og den leder efter en måde at fjerne blokeringen på, også gennem selve porten.
Andre bygere melder om det samme mønster fra større flåder. Jed Arden, der kører omkring tyve agenter, skrev, at LLM’en næsten ikke optræder i hændelseslogden (juli 2026). Cursors team fandt, at tyve agenter, der delte én koordinationsfil med låse, blev bremset ned til en gennemstrømning på to eller tre (januar 2026).
Hvad jeg ville sætte op først
Hvis du starter med Claude Code-subagenter eller en hvilken som helst multi-agent orchestration, er det her rækkefølgen, jeg ville tage den i, set ud fra hvad det kostede mig at lære:
- Log hver agentstart. Én linje pr. start: tid, agenttype, model, risiko. Uden den kan du ikke se, hvad systemet gør, og ingen af tallene ovenfor ville findes.
- Én skriver pr. fil. Parallelle skrivere får en worktree og en deklareret filliste. Filer, som hver funktion tilføjer til (oversættelser, lockfiles, changelogs), får én ejer, og de andre afleverer fragmenter.
- Hent, før du rydder op. Lad aldrig et oprydningstrin afgøre ud fra “kører den”. Afgør ud fra “er dens arbejde i hovedcheckouten”.
- Sæt tjekkene uden for agenternes rækkevidde. Hooks, der blokerer, placeret et sted, en projektsession ikke kan skrive.
- Sæt loft på bølgen. Fem parallelle agenter er mit loft; ud over det bliver review flaskehalsen, og konflikterne vokser hurtigere end gennemstrømningen.
- Eskalér på gentagelse, ikke på indsats. En billig model som standard; efter den samme fejl tre gange ét forsøg på en stærkere model; derefter et menneske.
Hvad koster en AI-agent at bygge og drive for en virksomhed, frem for for ét udviklerforløb? Det er et andet spørgsmål, som er besvaret med tal i hvad en AI-agent koster i drift. Hvilke paneler jeg følger nu, ud fra de samme logs en måned senere, står i AI agent monitoring dashboard: hvad 1.238 kørsler viste.
Begrænsninger i denne rapport
- Én udviklers opsætning. Én lead-session, op til fem parallelle agenter. Flåder på titusinder eller hundreder af agenter fejler på yderligere måder, for eksempel ved start.
- Ingen rigtig regning. Dollartallet er en API-listepris-ækvivalent for 30 dage, et gulv, der udelader cache-skrivninger og ældre modeller. Jeg betaler et fast abonnement.
- Huller i logs. Blokerede starter logges ikke, så jeg kan ikke sige, hvor ofte bølgeloftet udløstes. De 159 kørsler af den stærkere implementer blander risikable trin og gentagne fejl.
- Datoer fra mine egne noter. Hændelsesdatoerne kommer fra noter og commits skrevet samme dag; én hændelse har en anden dato i en ældre regelfil, og jeg brugte noten.
Dashboard-prototypen, der voksede ud af arbejdet, er casen om multiagent-orkestrering, og at bygge agenter til klienter hører under AI-agenter og chatbotudvikling.
Kører du agenter parallelt og mister arbejde mellem dem?
Jeg udveksler gerne erfaringer om hooks, worktrees og review-porte. Ingen salgstale.
Kontakt mig