TL;DR
Hvad koster en AI-agent i drift? Tre ting: modelkaldene, de systemer agenten styrer, og de sikringer, der forhindrer, at den fejler i det stille. Modellen, du vælger, flytter tokenregningen mest: tusind ens agenttrin koster USD 0,46 på DeepSeek V4.1 Flash, USD 0,65 på Claude Haiku 5.5 og USD 26 på Claude Opus 5.5. I fire systemer, jeg byggede i år, var modelkaldene også det nemmeste at sætte et loft over: USD 0,05 for et baggrundstjek og højst USD 2,10 for en hel researchkørsel. Proxytrafik til én kørsel af en prisbenchmark kostede USD 3,08, og de dyre overraskelser var fejl, ingen så, som et udfald der kørte i 8 dage, før nogen opdagede det.
Jeg er Denys, fullstack- og AI-ingeniør. De fleste artikler om spørgsmålet citerer brede intervaller uden et projekt bag. Herunder er målerne fra fire ting, jeg har bygget og driver, med kilden til hvert tal: konfigurationsfiler, commitbeskeder og målte kørsler. Hvor et tal er et loft, jeg selv har sat, og ikke en regning, jeg har betalt, siger jeg det.
Hvad koster en AI-agent i drift, og hvad betaler du for?
Tre målere, og modellen er kun én af dem.
| Projekt | Hvad AI’en gør | Modelpris pr. enhed | Hvad ellers kører regningen |
|---|---|---|---|
| Personlig assistent | Chatter på Telegram, arbejder i CRM og mail, researcher på nettet | USD 0,00065 til 0,026 pr. trin efter model; lofter fra USD 0,05 til 2,10 pr. kørsel | Én server samt genforsøg og vagthunde |
| Prisbenchmark til en rejseagent | En separat AI-agent starter benchmarkkørsler via en MCP-server | Nul hos mig: den agent betaler sine egne tokens | Proxytrafik, ca. USD 3,08 pr. kørsel, og en server med 8 kerner |
| Lydtjek af live-udsendelser | Finder tale og talt sprog på hver kanal | Nul pr. kald: to små modeller kører på stedets egen computer | CPU: en demo med 32 kanaler brugte ca. 0,9 af en cloudserver med 2 kerner |
| Ejendomscertifikater | Læser ukendte portaler som et menneske | Tokens kun til portaler, scripts ikke kender | Scripts klarer den kendte portal helt uden tokens |
Mønstret holdt i alle fire: den billigste token er den, du aldrig sender, og de dyre timer går til delene omkring modellen.
Hvad koster modelkaldene?
Assistenten er den eneste af de fire, hvor modelregningen er min. Den kører på Anthropics Claude Agent SDK, og hver agent i den har et fast loft i koden. SDK’en stopper en kørsel, når den når grænsen for antal ture eller dollargrænsen.
| Opgave | Model | Loft pr. kørsel |
|---|---|---|
| Baggrundstjek i tomgang | Claude Haiku 4.5 | USD 0,05 og USD 1,00 pr. dag i alt |
| Research: opdel spørgsmålet | Claude Opus 4.6 | USD 0,10, 1 tur |
| Research: tre researchere parallelt | Claude Opus 4.6 | USD 0,50 hver, 3 ture, websøgning og hentning |
| Research: skriv svaret | Claude Opus 4.6 | USD 0,50, 1 tur |
| Hovedsamtale | Haiku, Sonnet eller Opus, se nedenfor | 200 ture eller USD 50, et sikkerhedsnet frem for en forventning |
Så en hel researchkørsel kan højst koste USD 0,10 + 3 × 0,50 + 0,50 = USD 2,10. Det er et loft, ikke et gennemsnit; hvad en kørsel reelt koster, afhænger af modellen, som næste afsnit prissætter.
To valg skar mere af regningen end nogen prisændring:
- Send hver besked til den billigste model, der kan klare den. Korte, enkle beskeder går til Haiku, middelsvære til Sonnet, flertrinsopgaver til Opus. Routeren læser nøgleord og beskedlængde, så selve routingen koster intet modelkald. I begyndelsen kørte alle agenter på Opus.
- Slet kald, der ikke fortjener deres plads. Baggrundstjekket bad før hver cyklus modellen om en statusrapport. Det havde ikke adgang til mail eller CRM, så det kunne kun skrive beskeder, ingen havde brug for. Jeg fjernede modelkaldet helt. Dagsloftet på USD 1,00 står stadig i konfigurationen og vogter ingenting.
Ét ærligt hul: SDK’en rapporterer prisen på hvert kald, og jeg gemte den aldrig. Månedstotalen ligger i Anthropics konsol, ikke i appen. Bygger jeg det igen, logger jeg prisen pr. kald fra dag ét, så man kan se, hvilken opgave der bruger pengene, ikke kun hvor meget.
Hvor meget ændrer modelvalget regningen?
Mere end noget andet på tokensiden. Herunder er ét agenttrin prissat på forskellige modeller. Trinnet er ca. 4.000 tokens ind og 500 ud, det estimat pr. kald, der står i assistentens egen kode til baggrundstjekket. Priserne er OpenRouters liste pr. 15. oktober 2026. OpenRouter videregiver hver udbyders listepris og tager sit gebyr, når du køber kreditter (5,5 % på standardplanen), ikke pr. forespørgsel.
| Model | Pris pr. 1 mio. tokens, ind / ud | Ét trin | 1.000 trin |
|---|---|---|---|
| DeepSeek V4.1 Flash | USD 0,024 / 0,72 | USD 0,00046 | USD 0,46 |
| Claude Haiku 5.5, GPT-6 Luna | USD 0,10 / 0,50 | USD 0,00065 | USD 0,65 |
| Qwen3.8 Flash | USD 0,15 / 0,47 | USD 0,00083 | USD 0,83 |
| Mistral Small 4 | USD 0,15 / 0,60 | USD 0,00090 | USD 0,90 |
| Llama 4 Maverick | USD 0,188 / 0,652 | USD 0,0011 | USD 1,08 |
| Gemini 3.5 Flash Lite | USD 0,30 / 2,50 | USD 0,0025 | USD 2,45 |
| DeepSeek V4 Pro | USD 0,955 / 1,911 | USD 0,0048 | USD 4,78 |
| Gemini 3.8 Flash | USD 0,75 / 3,75 | USD 0,0049 | USD 4,88 |
| Grok 4.7 | USD 2 / 6 | USD 0,011 | USD 11 |
| Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon | USD 2 / 10 | USD 0,013 | USD 13 |
| Claude Opus 5.5 | USD 4 / 20 | USD 0,026 | USD 26 |
| Claude Fable 5.1, GPT-6 Astra | USD 10 / 50 | USD 0,065 | USD 65 |
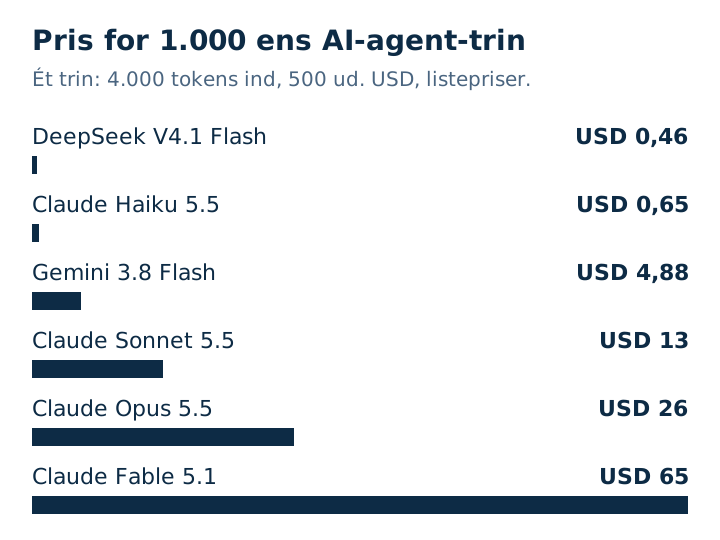
Det samme arbejde koster fra USD 0,46 til USD 65 pr. tusind trin, en spredning på ca. 140 gange. Tre ting følger af det:
- En lille model klarer de fleste trin. At sortere en besked, hente felter fra et dokument, svare ud fra en kendt tekst: det kræver sjældent en topmodel. Gem de store til planlægning og svær ræsonnering, som routingen ovenfor gør.
- Priserne flytter sig hurtigt. Assistenten kørte på Claude Haiku 4.5, Sonnet 4.6 og Opus 4.6. På dagens liste koster trinnet USD 0,0065 på Haiku 4.5 og USD 0,00065 på Haiku 5.5. Anthropic oplyser, at de nyere modeller tæller ca. 30 % flere tokens for den samme tekst, så pr. trin er den nyere stadig næsten otte gange billigere. Googles Gemini 4 Argon skal fordoble sin pris den 1. december 2026. Tjek igen, før du planlægger et år frem.
- Sammenlign opgaver, ikke tokenpriser. En billigere model, der kræver to forsøg eller en længere prompt for at opføre sig ordentligt, kan koste mere pr. færdig opgave. Mål en stikprøve af rigtige opgaver på to eller tre modeller, før du vælger.
Dit eget overslag er én linje: trin pr. opgave × opgaver pr. måned × trinprisen for din model.
Hvorfor var konteksten det egentlige problem og ikke prisen pr. token?
Prisen pr. token er forudsigelig. Konteksten er ikke. De fejl, der gjorde ondt på denne assistent, handlede alle om, hvor meget tekst der gik ind i hvert kald:
- Lange sessioner ødelagde svar. For at svare hurtigere holdt appen en varm session åben mellem beskeder. Når konteksten løb over, begyndte modellen at returnere forvansket tekst i blandede alfabeter. Løsningen: genbrug sessionen efter 20 beskeder, og prøv igen i en frisk, når et svar ser ødelagt ud.
- Et gemt checkpoint voksede for stort. En dag fejlede kald med “Prompt is too long”. Det checkpoint, der indsættes i hvert kald, er nu begrænset til 2 KB.
- Systemprompten bar filer, den sjældent brugte. At indlæse færdigheder kun, når en besked kræver dem, sparede ca. 3.000 tokens pr. kald, og at fjerne tre referencefiler fra forhåndsindlæsningen sparede ca. 1.500 mere. Det er estimater fra commitnoterne, ikke fakturalinjer.
- Historikken var længere, end den var nyttig. Den chathistorik, der sendes med hvert kald, gik fra 20 beskeder til 10.
Hver af disse ændringer sænker prisen og gør samtidig svarene hurtigere. Behandl konteksten som et budget, ligesom du behandler penge.
Hvad koster den infrastruktur, en agent styrer?
I rejseprisbenchmarken er AI-delen en separat agent. Den starter benchmarkkørsler via en MCP-server, jeg byggede, og dens tokens faktureres til den, der kører agenten. Det, benchmarken selv betaler for, er scrapingen bagved: residential proxyer og en server fuld af browsere.
Målte tal fra det system:
- Proxytrafik: én kørsel over to rejsesider brugte ca. 935 MB, ca. USD 3,08, omtrent 0,23 MB pr. gemt prisrække.
- Blokering af trackere: på én side skar blokering af sporingsscripts trafikken fra 4,2 MB til 2,5 MB pr. søgning, med identiske priser i alle seks testkørsler.
- Ingen browser, hvor der ikke er brug for en: priserne på én side kunne læses med en almindelig HTTP-klient, der ligner en mobilbrowser. Indsamlingen gik fra 8 til 43 datoer i minuttet på fem workers, og browserkoden til den side blev slettet.
- CPU, ikke hukommelse, bestemmer serverstørrelsen: med 20 browsere på en server med 8 kerner var belastningen ca. 30, mens 6 til 7 GB RAM stod ubrugt. En varm browser fylder ca. 345 MB. Dimensionér serveren efter kerner.
Styrer din agent browsere, proxyer eller betalte API’er, vil de målere sandsynligvis vokse fra modelregningen. Mål dem pr. opgave, før du vælger model.
Hvornår er AI på enheden billigere end et API?
Når inputtet aldrig behøver forlade bygningen, og modellen er lille. Udsendelsesprojektet tjekker live-lydkanaler under sportsudsendelser: stilhed, fejl, en kommentator der skifter til det forkerte sprog. At sende hvert sekund lyd til et API ville koste penge ved hvert kald og give forsinkelse.
I stedet kører to åbne modeller på stedets egen computer: den ene finder tale, den anden navngiver sproget. Sammen fylder de ca. 24 MB vægte, talefinderen bruger ca. 7 MB RAM, og der er intet gebyr pr. kald. I en demo med 32 kanaler brugte analysen af hver kanal i realtid ca. 0,9 af en cloudserver med 2 kerner.
Prisen er en nøjagtighed, du selv må bevise. På et offentligt sæt ren oplæst tale, 30 klip på tre sekunder pr. sprog, havde sprogmodellen ret i 93,3 % af tilfældene for portugisisk og mindst 96,7 % for spansk, engelsk og fransk. Det er et loft, ikke en prognose: tilskuerstøj og musik under en kommentator blev aldrig målt, fordi der ikke var lyd fra et rigtigt udsendelsesforløb.
Hvad koster det at gøre en agent sikker at lade i fred?
Det er den pris, de fleste overslag springer over, og det er her, mine timer gik. Nogle rigtige fejl:
- Et stille udfald på 8 dage. Et andet projekt på samme server opdaterede en delt browsercache. Scraperens pulje gik fra 40 virkende browsere til 0, jobs hang uden fejl, og intet advarede nogen. Rettelsen var lille: giv scraperen sin egen browsercache. At finde årsagen tog 8 dage, fordi der ikke var nogen alarm på pulljens parathed.
- Et job, der “lykkedes” med ingenting. En kørsel gennemgik 359 datoer på 12 minutter, gemte 0 rækker og meldte succes. Jobs stopper nu efter 25 tomme datoer i træk og siger hvorfor.
- En stoppet kørsel, der blev ved med at bruge. En benchmark markeret som stoppet kørte videre i 4 timer og brugte proxytrafik hele tiden.
- En proxygrænse tømte puljen. Da proxyplanen ramte sin trafikgrænse, skrumpede puljen fra 40 browsere til 0 på 12 minutter og blev der til en genstart. Den fylder sig nu selv op hvert 60. sekund og går op til 5 minutter mellem forsøg.
- For mange alarmer den første dag. Den første test af udsendelsesværktøjet på et rigtigt feed med 16 kanaler og 49 minutters længde gav 3.492 hændelser. 92,4 % var støj og alarmer om stemmeskift, og operatøren trykkede på Ryd 182 gange på 27 minutter. Detektorerne var fine; tærsklerne havde aldrig mødt rigtig programlyd. Rettelsen var en kontakt pr. profil, ikke ny matematik.
- Hængende kald og hastighedsgrænser. Assistenten har nu en vagthund på 120 sekunder for et kald, der går stille, en grænse på 300 sekunder for hele kaldet og op til 3 genforsøg efter 30 sekunder, 2 minutter og 5 minutter, når API’et er overbelastet eller ramt af en hastighedsgrænse. Et hængende værktøjskald falder ikke over på reservemodellerne, fordi en langsommere model ikke løser et fastlåst værktøj.
Intet af det viser sig som en tokenpris. Det viser sig som timer og som tabt tillid, når agenten siger “færdig” og tager fejl. Afsæt budget til det: en første test på rigtige data, alarmer på de ting, der kan gå stille, og kontroller af, at en “succes” frembragte noget.
Hvor passer AI ind, når scripts kan klare det meste?
I kanten. Ejendomscertifikattjenesten henter papirer fra ejendomsadministratorers onlinekonti og bygger det certifikat, en sælger har brug for. Et script klarer den vigtigste kendte portal, hvor 95 % af dokumenterne bliver færdige. Vision-AI læser kun de portaler, scripts ikke kender, og den vej ligger bag en kontakt, der slår den fra med det samme.
For dem, der bestiller dem, tager et certifikat nu 2 til 3 minutter i stedet for 2 til 3 uger og koster EUR 99 i stedet for EUR 200 til 300. AI’en er med vilje den mindre del af kæden: scripts er billige og forudsigelige, hvor de virker, og modellen bruges, hvor kun det at læse som et menneske hjælper.
Hvordan vurderer du driftsprisen på din egen agent?
Før du beder om et tilbud, så skriv fem tal ned:
- Opgaver pr. måned. Beskeder, dokumenter, kørsler.
- Modelkald pr. opgave og hvilken model, hvert kald kræver. De fleste opgaver kræver ikke topmodellen.
- Tokens pr. kald. Systemprompt, historik, dokumenter. Her vokser omkostningerne stille.
- De andre målere. Proxyer pr. MB, betalte API’er pr. kald, servere pr. kerne.
- Et loft for hvert job. En dollargrænse pr. kørsel i koden, ikke kun en månedsgrænse på kontoen.
Læg så den omkostning til, ingen tilbyder: en test på rigtige data i uge ét, alarmer på stille fejl og en person til at læse dem.
Hvad disse tal ikke fortæller dig
Lofterne ovenfor er grænser, jeg satte, ikke brugte penge, og modeltabellen er listepriser, ikke mine fakturaer. Hvert projekttal stammer fra ét system og én periode. Modelpriserne ændrer sig ofte, så tjek udbydernes aktuelle prissider, før du planlægger. Og intet af det siger, hvor lang tid projekterne tog at bygge, eller hvad de kostede at bygge; det afhænger langt mere af integrationerne end af AI’en.
Planlægger du en agent og vil sammenligne noter om, hvad den koster i drift, ser jeg gerne på dine tal. Min side om udvikling af AI-agenter viser, hvordan jeg arbejder, og casen om ejendomscertifikater, casen om lyd i live-udsendelser og casen om rejsepriser viser tre af disse projekter mere detaljeret. Til en bot på WhatsApp vejer kanalgebyrerne ofte tungere end modellen; jeg har regnet dem ud pr. land i hvad en WhatsApp AI-chatbot koster.
Kilder
- Anthropic, Claude Agent SDK options:
max_turnsogmax_budget_usdstopper en kørsel; hvert resultat rapporterertotal_cost_usd. - OpenRouter, model list prices og platform fees, læst 15. oktober 2026.
- Anthropic, Claude pricing, og Google, Gemini API pricing, læst 15. oktober 2026: noten om tokenizeren og prisændringen for Gemini 4 Argon.
- Alle projekttal: projekternes egne konfigurationsfiler, commitbeskeder og målte kørsler, 2026.