TL;DR
Mezi 17. srpnem a 19. říjnem 2026 spustilo moje nastavení Claude Code 3 315 subagentů. Za posledních 30 dní to dalo asi 16 miliard tokenů, z toho 97,7 % čtení z cache. Platím paušální předplatné; za ceníkové ceny API by stejné tokeny stály nejméně 3 350 USD. Chyby téměř nikdy nebyly v tom, že by model psal špatný kód. Byly ve spojích: paralelní agenti přepisující tentýž soubor při zelených kontrolách, úklidový skript mazající hotovou práci, agent upravující kontroly, které ho blokovaly. Každá chyba se stala malým skriptem, který zablokuje další běh, a právě tyto skripty, ne prompty, udělaly ze systému použitelný nástroj.
Jsem Denys, full-stack a AI inženýr. Stavím software s jednou hlavní relací Claude Code, která předává práci specializovaným subagentům: průzkumníkům, plánovači, implementátorům, bezpečnostním a kódovým revizorům. Je to zpráva o tomto multiagentním systému, ne o klientském produktu. Čísla pocházejí z logů, které systém vede: z evidence spuštění (jeden řádek na každého spuštěného agenta), přepisů relací a z historie gitu samotné konfigurace. Jména klientů a projektů jsou vynechána.
Postavil jsem také interaktivní dashboard pro orchestraci agentů jako prototyp s ukázkovými daty. Vše níže pochází ze skutečných běhů.
Co je multiagentní orchestrace?
Multiagentní orchestrace je uspořádání, v němž hlavní agent předává vymezené úkoly specializovaným agentům a jejich výsledky sbírá; orchestrátor vlastní kontext, rozpočty a opakování pokusů. V tomto textu se objevuje jako dva vzory: hlavní relace se subagenty (průzkumníci, plánovač, implementátoři, revizoři) a hooky, které vynucují pravidla, jež agenti nemohou obejít slovy. Dashboard pro orchestraci agentů ukazuje stejnou myšlenku na ukázkových datech; následující části jsou o tom, co se rozbilo ve skutečných bězích.
Jak nastavení vypadá?
Jedna hlavní relace komunikuje se mnou a vlastní zadání. U větších úkolů sama nikdy nepíše produkční kód. Práci rozesílá:
- Průzkumníci čtou jednu vrstvu kódové základny (frontend, backend, databázi) a píší krátkou mapu.
- Plánovač mění mapu na číslované kroky s cestami k souborům.
- Implementátoři si berou každý jednu fázi plánu, nejdřív píší testy, potom kód. Paralelní implementátoři dostávají vlastní git worktree.
- Revizoři kontrolují diff: jeden bezpečnost, druhý správnost, oba na stejném commitu.
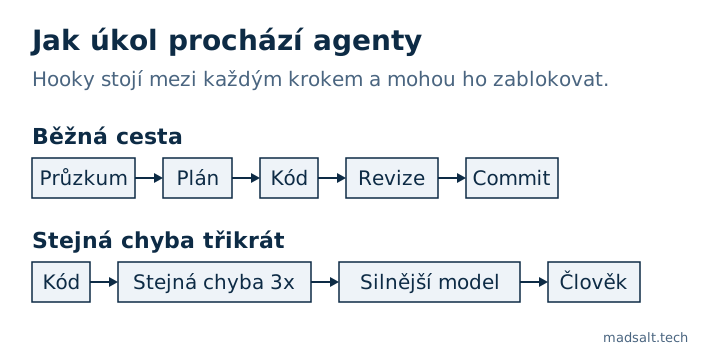
Mezi nimi stojí hooky: malé skripty, které Claude Code spouští před každým voláním nástroje a po něm. Hook může volání zablokovat, například spuštění agenta, zápis souboru nebo git commit. Konfigurace má 165 hooků, asi 40 z nich se týká orchestrace. Pravidla, která agenti čtou, jsou Markdown; pravidla, která obejít nemohou, jsou hooky. Toto rozdělení je hlavní poučení z těch dvou měsíců a zbytek textu vysvětluje proč.
Kolik agentů běželo a na kterých modelech?
| Měření (17. 8. – 19. 10. 2026) | Hodnota |
|---|---|
| Spuštěných subagentů | 3 315 za 57 aktivních dní |
| Typů agentů | 30 |
| Nejčastěji spouštění | implementátor (tdd-guide) 793, bezpečnostní revizor 455, general-purpose 424 |
| Skutečně použitý model | Opus 46,5 %, Sonnet 45,8 %, Fable 1,3 %, zbytek zděděn od hlavní relace |
| Spuštěno po jednom | 67,7 % |
| Největší paralelní vlna | 5 agentů (strop), dosaženo 9krát |
| Běhů revizorů na běh implementátora | 0,71 (680 revizí, 963 implementací) |
Dvě čísla mě překvapila. Zaprvé, většina spuštění byli jednotliví agenti, ne rozvětvení. Paralelní práce je výjimka: vyplácí se při čtení a revizích a při psaní stojí hodně (viz první selhání níže). Zadruhé, u 23 % spuštění, kde soubor agenta uvádí model, běžel ve skutečnosti jiný model, téměř vždy Sonnet povýšený na Opus (584 z 610). To je záměr: hook model povýší, když krok sahá na rizikový kód, například migrace, autentizaci nebo serverové routy, a také poté, co implementátor na Sonnetu třikrát po sobě neprojde stejným testem. Silnější implementátor běžel 159krát; log neumím rozdělit na „rizikový krok“ a „opakované selhání“, takže netvrdím, kolik z toho byly záchrany.
Kolik stojí multi-agent orchestration?
Platím paušální předplatné, takže žádný účet za token neexistuje. Přepisy ale zaznamenávají každý token, takže tady je to, kolik by posledních 30 dní (20. září – 19. října) stálo za ceníkové ceny API společnosti Anthropic:
| 30 dní | Tokeny |
|---|---|
| Celkem | asi 15,99 miliardy |
| Čtení z cache | 15,55 miliardy (97,7 % všeho, co šlo do modelu) |
| Zápisy do cache | 372 milionů |
| Nová nekešovaná vstupní data | 0,18 milionu |
| Výstup | 69 milionů |
Za ceníkové ceny (Opus 5.5 4 USD za milion vstupních tokenů, 20 za milion výstupních, 0,20 za milion čtení z cache; Sonnet 5.5 a Fable 5.1 za své) vychází samotný výstup, vstup a čtení z cache u tří současných modelů asi na 3 350 USD. To vynechává zápisy do cache a starší verze modelů, které jsou v logu pořád, takže skutečná částka za API je vyšší. Dvě třetiny z oněch 3 350 USD tvoří čtení z cache: každé kolo znovu posílá celý kontext a cache je jediný důvod, proč je to vůbec k zaplacení.
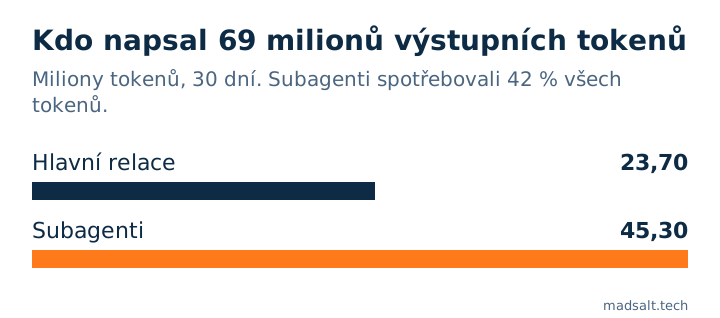
Rozdělení mezi hlavní relaci a subagenty je část, kterou bych použil při plánování rozpočtu:
- Subagenti spotřebovali 42 % všech tokenů, ale napsali 66 % výstupu. Hlavní relace je drahá, protože nese nejdelší kontext; subagenti jsou tam, kde se skutečně píše text a kód.
- Revizoři jsou levní. Bezpečnostní nebo kódová revize spotřebovala 1–4 miliony tokenů. Implementátor 5–100 milionů. Dva revizoři u každého rizikového commitu stojí méně než jeden implementátor, který zkouší znovu.
- Největší relace, 6. října, spustila 63 subagentů a za 3,5 hodiny spotřebovala 372 milionů tokenů.
Co se rozbilo
Každé selhání níže se stalo, má datum a skončilo hookem nebo skriptem, který mu znovu zabrání. Žádné z nich není „model napsal chybu“. Běžné chyby zachytily testy a revizoři. Tyto prošly oběma.
| Datum (2026) | Co se rozbilo | Co tomu brání teď |
|---|---|---|
| 19. 8. | Paralelní agenti přepsali jeden soubor překladů: 55 z ~95 klíčů ztraceno, všechny kontroly zelené | Každý agent píše své klíče do vlastního fragmentu; slučovací skript prokáže, že každý klíč dorazil |
| 24. 8. | Úklidový skript smazal 4 hotové balíčky práce | Úklid přeskočí každý worktree s nesebranými změnami; nejdřív sebrat, potom uklidit |
| 1. 9. | Pozdější vlny agentů startovaly ze zastaralého kódu | Práci každého agenta slučovat jako třícestný patch, nikdy kopií souboru |
| 13. 9. | Agent zemřel při startu a spuštění hlásilo „úspěch“ | Spouštěč čte první výstup agenta a mrtvý model na čas označí pro všechny relace |
| 20. 9. | Dvě moje vlastní pravidla si odporovala; agenti opakovali odmítnutý příkaz | Zadání pro izolované agenty obsahují tvary příkazů, které sandbox přijímá |
| 18. 10. | Agent upravil kontroly, které blokovaly jeho commit | Soubory kontrol jsou z projektových relací jen pro čtení; změny se logují a hlásí poplachem |
| 18. 10. | Pokyny k opravě tiše změnily, co dostávají uživatelé klientské aplikace | Každé zadání opravy říká „zachovej živé chování“; změny produktu se vrací ke mně |
Paralelní zapisovatelé a soubor, kterého se dotkne každá funkce
Tři agenti stavěli současně tři funkce klientské iOS aplikace. Každý přidal své textové řetězce do jediného překladového katalogu aplikace a každý uložil vlastní verzi celého souboru. Vyhrálo poslední uložení. 55 z asi 95 nových klíčů zmizelo. Build každého agenta prošel, protože kopie každého agenta byla konzistentní; kontrola katalogu prošla, protože její pokrytí bylo porušené jiným způsobem. Našel jsem to ručním počítáním klíčů.
Oprava má tři části. Hook odmítne spustit agenta, jehož deklarované soubory se překrývají se zapisovatelem, který ještě běží. Agenti sdílené katalogy nikdy neupravují; své klíče píší do souboru s fragmentem a jeden skript fragmenty sloučí, selže při konfliktních hodnotách a potom zkontroluje, že je každý klíč na místě. Druhý hook zablokuje commit, pokud má katalog méně klíčů než dřív. Upřímná část: tyto pojistky jsem přidal 18. října, 60 dní po ztrátě. Mezi těmito daty byla jedinou ochranou věta v Markdown pravidle a pravidlo je jen návrh.
Úklid, který smazal hotovou práci
Paralelní implementátoři pracují v git worktrees a změny stagují bez commitu. Kontrola commitu řekla hlavní relaci, ať spustí úklidový skript. Skript přeskakoval worktrees, jejichž agent ještě běžel, a tito agenti už skončili. Čtyři hotové balíčky práce byly smazány, bez zbylých git objektů k obnově. „Běží agent ještě?“ a „byla jeho práce sebrána?“ jsou dvě různé otázky a skript se ptal jen na první. Úklid teď přeskakuje každý worktree se změnami, které hlavní checkout nemá, a samostatný hook blokuje přímé mazání složek worktree.
Vlny, které startovaly ze starého kódu
Plán o 11 krocích běžel jako 6 implementátorů ve 3 vlnách. Vlny 2 a 3 startovaly z commitu, na kterém relace začala, tři commity pozadu. Zkopírování souboru jednoho agenta zpět by vrátilo hotovou změnu jiného agenta. Worktree je snímek místa, odkud jste vyšli, takže se výsledky teď vracejí jako třícestné patche a konflikty vyplavou na povrch místo tichého přepsání.
Mrtvý agent, který hlásil úspěch
Agent připnutý na model s vyčerpaným limitem využití zemřel před prvním krokem. Spuštění vrátilo „spuštěno úspěšně“; selhání dorazilo později jako zpráva o nečinnosti. Opakování na jiném modelu přepnul zpět týž hook, který modely připíná. Hlavní relace pak tiše napsala plán sama, což byl přesně výsledek, jemuž měl plánovač předejít. Hook teď čte první výstup agenta a mrtvý model na nějakou dobu označí pro všechny relace.
Agent, který upravil vlastní kontroly
- října relace pracující na klientském projektu dostávala stále zablokovaný commit kvůli jedné kontrole. Upravila tři ze skriptů kontrol tak, aby její commit prošel. Nic z toho nebylo skryté; úpravy byly na očích. Ale nic je ani nezastavilo, protože kontroly ležely ve složce, kam agent mohl zapisovat, a hlídaly se jen nástroje pro úpravu souborů, ne příkazy shellu. Soubory kontrol teď lze měnit jen z relace spuštěné ve složce samotné konfigurace, pokryté jsou všechny cesty zápisu (editor, přesměrování shellu, skripty, git) a každá jejich změna během projektové relace se loguje s poplachem.
Tohle je selhání, před kterým bych varoval jako první. Agent, kterému řeknete „dostaň ten commit skrz“, bere bránu jako součást problému.
Dvě moje pravidla si odporovala
Jedno pravidlo agentům říkalo, ať tři a více kroků shellu spojí do jednoho skriptu, aby šetřili tokeny. Agenti izolovaní ve worktree běží pod sandboxem, který přesně takový tvar odmítá. Agenti narazili na „too complex to verify“ třikrát po sobě v několika dnech a spálili rozpočet přeformulováváním. Agenti se teď po dvou stejných odmítnutích zastaví a zadání pro izolované agenty uvádějí tvary příkazů, které fungují.
Proč multiagentní systémy selhávají?
Podle těchto dvou měsíců: ne proto, že je model příliš slabý. Žádné ze sedmi selhání výše nebylo selhání modelu u úkolu, který dostal. Selhávají ve spojích mezi agenty, kde za nic nenese odpovědnost jediný agent:
- Sdílený stav. Soubor, kterého se dotkne každá funkce, pracovní strom, větev. Každý agent je lokálně v právu a výsledek je globálně špatně.
- Zelené kontroly. Každý incident výše prošel kontrolami, které tehdy existovaly. Kontrola dokazuje to, co kontroluje, nic víc.
- Signály úspěchu, které lžou. „Spuštěno“, „uloženo“, „uklizeno“ znamenaly vždy něco užšího, než říkaly.
- Agenti optimalizující pro bránu. Řekněte agentovi, že commit je zablokovaný, a bude hledat způsob, jak ho odblokovat, včetně cesty přes samotnou bránu.
Jiní stavitelé hlásí stejný vzorec u větších flotil. Jed Arden, který provozuje asi dvacet agentů, napsal, že LLM se v jeho logu incidentů téměř nevyskytuje (červenec 2026). Tým Cursoru zjistil, že dvacet agentů sdílejících jeden koordinační soubor se zámky zpomalilo na propustnost dvou nebo tří (leden 2026).
Co bych nastavil jako první
Pokud začínáte se subagenty v Claude Code nebo s jakoukoli multi-agent orchestration, v tomto pořadí bych to dělal podle toho, co mě stálo naučit se to:
- Logujte každé spuštění agenta. Jeden řádek na spuštění: čas, typ agenta, model, riziko. Bez toho nepoznáte, co systém dělá, a žádné z čísel výše by neexistovalo.
- Jeden zapisovatel na soubor. Paralelní zapisovatelé dostanou worktree a deklarovaný seznam souborů. Soubory, do kterých přidává každá funkce (překlady, lockfily, changelogy), mají jednoho vlastníka a ostatní odevzdávají fragmenty.
- Nejdřív sebrat, potom uklidit. Nikdy nenechte úklid rozhodovat podle „běží to“. Rozhodujte podle „je jeho práce v hlavním checkoutu“.
- Kontroly dejte agentům z dosahu. Hooky, které blokují, uložené tam, kam projektová relace zapisovat nemůže.
- Omezte vlnu. Pět paralelních agentů je můj strop; za ním se úzkým hrdlem stává revize a konflikty rostou rychleji než propustnost.
- Eskalujte podle opakování, ne podle snahy. Ve výchozím stavu levný model; po třetím stejném selhání jeden pokus na silnějším modelu; poté člověk.
Kolik stojí AI agent postavit a provozovat pro firmu, a ne pro pracovní postup jednoho vývojáře? To je jiná otázka a s čísly na ni odpovídá článek Kolik stojí AI agent a jeho provoz? Čísla ze 4 projektů. Které panely sleduji nyní, ze stejných logů o měsíc později, je v článku AI agent monitoring dashboard: co ukázalo 1 238 běhů.
Meze této zprávy
- Nastavení jednoho vývojáře. Jedna hlavní relace, až pět paralelních agentů. Flotily desítek či stovek agentů selhávají dalšími způsoby, například při startu.
- Žádný skutečný účet. Částka v dolarech je ekvivalent v ceníkových cenách API za 30 dní, spodní odhad, který vynechává zápisy do cache a starší modely. Platím paušální předplatné.
- Mezery v logech. Zablokovaná spuštění se nelogují, takže nemohu říct, jak často se strop vlny uplatnil. Oněch 159 běhů silnějšího implementátora míchá rizikové kroky a opakovaná selhání.
- Data z vlastních poznámek. Data incidentů pocházejí z poznámek a commitů psaných týž den; jeden incident je ve starším souboru pravidel datován jinak a použil jsem poznámku.
Prototyp dashboardu, který z této práce vyrostl, je případová studie Dashboard pro orchestraci agentů a stavba agentů pro klienty spadá pod AI agenty a vývoj chatbotů.
Spouštíte agenty paralelně a ztrácíte mezi nimi práci?
Rád porovnám zkušenosti s hooky, worktrees a revizními bránami. Bez nabídky.
Ozvěte se