Kort sagt
Vad kostar en AI-agent att driva? Tre saker: modellanropen, systemen den styr och skydden som hindrar den från att fela i tysthet. Modellvalet påverkar tokenräkningen mest: tusen likadana agentsteg kostar USD 0,46 på DeepSeek V4.1 Flash, USD 0,65 på Claude Haiku 5.5 och USD 26 på Claude Opus 5.5. I de fyra system jag har byggt i år var modellanropen också den enklaste delen att sätta tak på: USD 0,05 för en bakgrundskontroll och högst USD 2,10 för en fullständig research-körning. Proxytrafiken för en körning av ett prisjämförelseverktyg kostade USD 3,08, och de dyra överraskningarna var fel som ingen såg, som ett avbrott som pågick i 8 dagar innan någon märkte det.
Jag heter Denys och är full-stack- och AI-ingenjör. De flesta artiklar om den här frågan anger breda intervall utan något projekt bakom. Nedan finns mätarna från fyra saker jag har byggt och driver, med källan till varje siffra: konfigurationsfiler, commit-meddelanden och mätta körningar. Där en siffra är ett tak jag satte och inte en räkning jag betalade säger jag det.
Vad kostar en AI-agent, och vad betalar du för när du driver den?
Tre mätare, och modellen är bara en av dem.
| Bygge | Vad AI:n gör | Modellkostnad per enhet | Vad mer som driver räkningen |
|---|---|---|---|
| Personlig assistentagent | Chattar på Telegram, arbetar i CRM och e-post, söker på webben | USD 0,00065 till 0,026 per steg beroende på modell; tak från USD 0,05 till 2,10 per körning | En server, plus omförsök och vakthundar |
| Prisjämförelse åt en resebyrå | En separat AI-agent startar körningar via en MCP-server | Noll hos mig: den agenten betalar sina egna tokens | Proxytrafik, cirka USD 3,08 per körning, och en server med 8 kärnor |
| Ljudkontroll vid direktsändning | Hittar tal och talat språk i varje kanal | Noll per anrop: två små modeller körs på platsens egen dator | CPU: en demo med 32 kanaler använde cirka 0,9 av en molnserver med 2 kärnor |
| Fastighetsintyg | Läser okända portaler som en människa | Tokens bara för portaler som skripten inte känner till | Skripten sköter den kända portalen helt utan tokens |
Mönstret höll i alla fyra: den billigaste token är den du aldrig skickar, och de dyra timmarna går åt till delarna runt modellen.
Vad kostar modellanropen?
Assistenten är den enda av de fyra där modellräkningen är min. Den körs på Anthropics Claude Agent SDK, och varje agent i den har ett hårt tak i koden. SDK:t stoppar en körning när den når gränsen för antal varv eller dollargränsen.
| Uppgift | Modell | Tak per körning |
|---|---|---|
| Bakgrundskontroll i viloläge | Claude Haiku 4.5 | USD 0,05 och USD 1,00 per dag totalt |
| Research: dela upp frågan | Claude Opus 4.6 | USD 0,10, 1 varv |
| Research: tre researchers parallellt | Claude Opus 4.6 | USD 0,50 var, 3 varv, webbsökning och hämtning |
| Research: skriva svaret | Claude Opus 4.6 | USD 0,50, 1 varv |
| Huvudkonversation | Haiku, Sonnet eller Opus, se nedan | 200 varv eller USD 50, ett skyddsnät och ingen förväntan |
Det mesta en fullständig research-körning kan kosta är alltså USD 0,10 + 3 × 0,50 + 0,50 = USD 2,10. Det är ett tak, inte ett genomsnitt; vad en körning verkligen kostar beror på modellen, som nästa avsnitt prissätter.
Två val sänkte räkningen mer än någon prisändring:
- Skicka varje meddelande till den billigaste modell som klarar det. Korta, enkla meddelanden går till Haiku, medelsvåra till Sonnet, flerstegsärenden till Opus. Routern läser nyckelord och meddelandets längd, så själva routingen kostar inget modellanrop. Från början körde alla agenter på Opus.
- Ta bort anrop som inte förtjänar sin plats. Bakgrundskontrollen brukade be modellen om en statusrapport varje cykel. Den hade ingen åtkomst till e-post eller CRM, så allt den kunde göra var att skriva meddelanden som ingen behövde. Jag tog bort modellanropet helt. Dagstaket på USD 1,00 finns kvar i konfigurationen och skyddar ingenting.
En ärlig lucka: SDK:t rapporterar kostnaden för varje anrop, och jag sparade den aldrig. Månadssumman finns i Anthropics konsol, inte i appen. Om jag byggde det igen skulle jag logga kostnaden per anrop från dag ett, så att man ser vilken uppgift som drar pengarna och inte bara hur mycket.
Hur mycket ändrar modellvalet räkningen?
Mer än något annat på tokensidan. Nedan är ett agentsteg prissatt på olika modeller. Steget är ungefär 4 000 tokens in och 500 ut, den uppskattning per anrop som står i assistentens egen kod för bakgrundskontrollen. Priserna är OpenRouters lista den 15 oktober 2026. OpenRouter för vidare varje leverantörs listpris och tar sin avgift när man köper krediter (5,5 % på standardplanen), inte per förfrågan.
| Modell | Pris per 1 M tokens, in / ut | Ett steg | 1 000 steg |
|---|---|---|---|
| DeepSeek V4.1 Flash | USD 0,024 / 0,72 | USD 0,00046 | USD 0,46 |
| Claude Haiku 5.5, GPT-6 Luna | USD 0,10 / 0,50 | USD 0,00065 | USD 0,65 |
| Qwen3.8 Flash | USD 0,15 / 0,47 | USD 0,00083 | USD 0,83 |
| Mistral Small 4 | USD 0,15 / 0,60 | USD 0,00090 | USD 0,90 |
| Llama 4 Maverick | USD 0,188 / 0,652 | USD 0,0011 | USD 1,08 |
| Gemini 3.5 Flash Lite | USD 0,30 / 2,50 | USD 0,0025 | USD 2,45 |
| DeepSeek V4 Pro | USD 0,955 / 1,911 | USD 0,0048 | USD 4,78 |
| Gemini 3.8 Flash | USD 0,75 / 3,75 | USD 0,0049 | USD 4,88 |
| Grok 4.7 | USD 2 / 6 | USD 0,011 | USD 11 |
| Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon | USD 2 / 10 | USD 0,013 | USD 13 |
| Claude Opus 5.5 | USD 4 / 20 | USD 0,026 | USD 26 |
| Claude Fable 5.1, GPT-6 Astra | USD 10 / 50 | USD 0,065 | USD 65 |
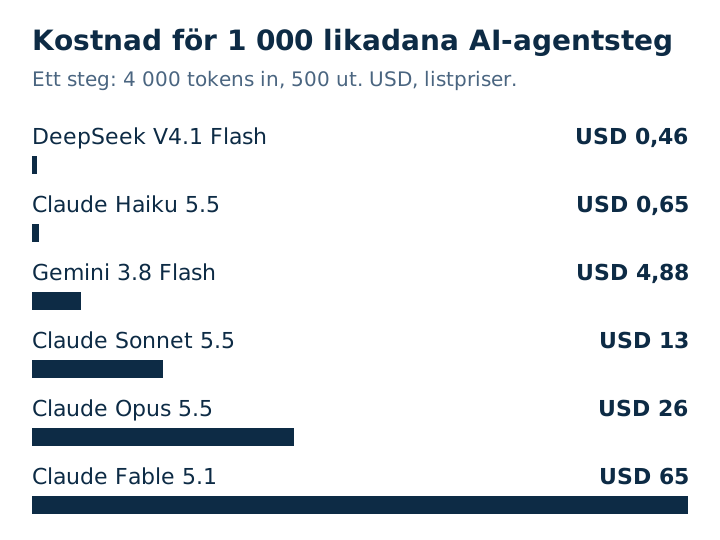
Samma arbete kostar från USD 0,46 till USD 65 per tusen steg, en skillnad på ungefär 140 gånger. Tre saker följer av det:
- En liten modell klarar de flesta stegen. Att sortera ett meddelande, plocka fält ur ett dokument, svara utifrån en känd text: sådant kräver sällan en toppmodell. Spara de stora för planering och svårt resonemang, vilket är vad routingen ovan gör.
- Priserna ändras snabbt. Assistenten körde på Claude Haiku 4.5, Sonnet 4.6 och Opus 4.6. På dagens lista kostar steget USD 0,0065 på Haiku 4.5 och USD 0,00065 på Haiku 5.5. Anthropic anger att de nyare modellerna räknar cirka 30 % fler tokens för samma text, så per steg är den nyare ändå nästan åtta gånger billigare. Googles Gemini 4 Argon ska fördubbla sitt pris den 1 december 2026. Kontrollera igen innan du planerar ett år framåt.
- Jämför uppgifter, inte tokenpriser. En billigare modell som behöver två försök, eller en längre prompt för att uppföra sig, kan kosta mer per färdig uppgift. Mät ett urval av riktiga uppgifter på två eller tre modeller innan du väljer.
Din egen uppskattning är en rad: steg per uppgift × uppgifter per månad × stegpriset för din modell.
Varför var kontexten det verkliga problemet, inte priset per token?
Priset per token är förutsägbart. Kontexten är det inte. Buggarna som gjorde ont i den här assistenten handlade alla om hur mycket text som gick in i varje anrop:
- Långa sessioner förstörde svaren. För att svara snabbare höll appen en varm session öppen mellan meddelandena. När kontexten svämmade över började modellen returnera förvanskad text i blandade alfabet. Lösningen: återvinn sessionen efter 20 meddelanden och försök igen i en ny när ett svar ser trasigt ut.
- En sparad kontrollpunkt blev för stor. En dag föll anropen med “Prompt is too long”. Kontrollpunkten som läggs in i varje anrop är nu begränsad till 2 KB.
- Systemprompten bar filer den sällan behövde. Att ladda färdigheter först när ett meddelande kräver dem sparade cirka 3 000 tokens per anrop, och att ta bort tre referensfiler från förladdningen sparade cirka 1 500 till. Det är uppskattningar från commit-anteckningarna, inte fakturarader.
- Historiken var längre än nyttig. Chatthistoriken som skickas med varje anrop gick från 20 meddelanden till 10.
Varje sådan ändring sänker kostnaden och snabbar upp svaren samtidigt. Behandla kontexten som en budget, på samma sätt som pengar.
Vad kostar infrastrukturen som en agent styr?
I resebyråens prisjämförelse är AI-delen en separat agent. Den startar körningar via en MCP-server jag byggde, och dess tokens faktureras den som kör agenten. Det jämförelseverktyget självt betalar för är insamlingen bakom: bostadsproxyer och en server full av webbläsare.
Mätta siffror från det systemet:
- Proxytrafik: en körning över två resesajter använde cirka 935 MB, cirka USD 3,08, ungefär 0,23 MB per sparad prisrad.
- Blockera spårare: på en sajt sänkte blockering av spårningsskript trafiken från 4,2 MB till 2,5 MB per sökning, med identiska priser i alla sex testkörningar.
- Ingen webbläsare där det inte behövs: en sajts priser gick att läsa med en vanlig HTTP-klient som ser ut som en mobil webbläsare. Insamlingen gick från 8 till 43 datum per minut på fem arbetare, och webbläsarkoden för den sajten raderades.
- CPU, inte minne, avgör serverstorleken: med 20 webbläsare på en server med 8 kärnor låg lasten på cirka 30 medan 6 till 7 GB RAM stod ledigt. En varm webbläsare tar cirka 345 MB. Dimensionera servern efter kärnor.
Om din agent styr webbläsare, proxyer eller betalda API:er kommer de mätarna sannolikt att växa förbi modellräkningen. Mät dem per uppgift innan du väljer modell.
När är AI på plats billigare än ett API?
När indata aldrig behöver lämna byggnaden och modellen är liten. Sändningsprojektet kontrollerar levande ljudkanaler under sportsändningar: tystnad, störningar, en kommentator som byter till fel språk. Att skicka varenda sekund ljud till ett API skulle kosta pengar vid varje anrop och lägga till fördröjning.
I stället körs två öppna modeller på platsens egen dator: den ena hittar tal, den andra namnger språket. Tillsammans har de cirka 24 MB vikter, talupptäckaren lägger till cirka 7 MB RAM och det finns ingen avgift per anrop. I en demo med 32 kanaler använde analysen av varje kanal i realtid cirka 0,9 av en molnserver med 2 kärnor.
Avvägningen är en träffsäkerhet du själv måste bevisa. På en offentlig uppsättning av ren uppläst tal, 30 klipp på tre sekunder per språk, hade språkmodellen rätt i 93,3 % av fallen för portugisiska och minst 96,7 % för spanska, engelska och franska. Det är ett tak, ingen prognos: publikbrus och musik under en kommentator mättes aldrig, eftersom inget ljud från en verklig sändningskrets fanns tillgängligt.
Vad kostar det att göra en agent säker att lämna ensam?
Det här är kostnaden som de flesta uppskattningar hoppar över, och det är dit mina timmar gick. Några verkliga fel:
- Ett tyst avbrott på 8 dagar. Ett annat projekt på samma server uppdaterade en delad webbläsarcache. Insamlarens pool gick från 40 fungerande webbläsare till 0, jobben hängde sig utan fel och inget larm gick till någon. Lösningen var liten: ge insamlaren sin egen webbläsarcache. Att hitta orsaken tog 8 dagar, eftersom det inte fanns något larm för poolens beredskap.
- Ett jobb som “lyckades” med ingenting. En körning gick igenom 359 datum på 12 minuter, sparade 0 rader och rapporterade framgång. Nu stannar jobben efter 25 tomma datum i rad och säger varför.
- En stoppad körning som fortsatte kosta. Ett jämförelsetest som markerats som stoppat fortsatte köra i 4 timmar och använde proxytrafik hela tiden.
- En proxygräns tömde poolen. När proxyplanen nådde sin trafikgräns krympte poolen från 40 webbläsare till 0 på 12 minuter och låg kvar så tills den startades om. Nu fyller den på sig själv var 60:e sekund och backar upp till 5 minuter.
- För många larm första dagen. Det första testet av sändningsverktyget på en verklig sändning med 16 kanaler, 49 minuter lång, gav 3 492 händelser. 92,4 % var brus och larm om röstbyte, och operatören tryckte på Rensa 182 gånger på 27 minuter. Detektorerna var inte fel; tröskelvärdena hade aldrig mött riktigt programljud. Lösningen var en omkopplare per profil, inte ny matematik.
- Hängande anrop och begränsningar. Assistenten har nu en vakthund på 120 sekunder för ett anrop som blir tyst, en gräns på 300 sekunder för hela anropet och upp till 3 omförsök efter 30 sekunder, 2 minuter och 5 minuter när API:et är överbelastat eller har nått sin gräns. Ett hängande verktygsanrop faller inte vidare till reservmodellerna, eftersom en långsammare modell inte lagar ett fastnat verktyg.
Inget av det syns som ett tokenpris. Det syns som timmar och som förlorat förtroende när agenten säger “klart” och har fel. Budgetera för det: ett första test på riktiga data, larm för sådant som kan bli tyst och kontroller av att en “framgång” faktiskt gav något.
Var passar AI in när skript klarar det mesta av arbetet?
I ytterkanterna. Fastighetsintygstjänsten samlar in handlingar från fastighetsförvaltarnas onlinekonton och bygger det intyg en säljare behöver. Ett skript sköter den största kända portalen, där 95 % av handlingarna blir kompletta. Visuell AI läser bara de portaler som skripten inte känner till, och den vägen ligger bakom en omkopplare som stänger av den direkt.
För dem som beställer tar ett intyg nu 2 till 3 minuter i stället för 2 till 3 veckor och kostar EUR 99 i stället för EUR 200 till 300. AI:n är med flit den mindre delen av flödet: skript är billiga och förutsägbara där de fungerar, och modellen används där bara läsning som en människa räcker.
Hur uppskattar du driftkostnaden för din egen agent?
Innan du ber om en offert, skriv ner fem siffror:
- Uppgifter per månad. Meddelanden, dokument, körningar.
- Modellanrop per uppgift och vilken modell varje behöver. De flesta uppgifter behöver inte toppmodellen.
- Tokens per anrop. Systemprompt, historik, dokument. Här växer kostnaderna i det tysta.
- De andra mätarna. Proxyer per MB, betalda API:er per anrop, servrar per kärna.
- Ett tak för varje jobb. En dollargräns per körning i koden, inte bara en månadsgräns på kontot.
Lägg sedan till kostnaden som ingen offererar: ett test på riktiga data första veckan, larm för tysta fel och någon som läser dem.
Vad säger de här siffrorna inte?
Taken ovan är gränser jag satte, inte det som spenderades, och modelltabellen visar listpriser, inte mina fakturor. Varje projektsiffra kommer från ett system och en period. Modellpriser ändras ofta, så kontrollera leverantörernas aktuella prissidor innan du planerar. Och inget av detta säger hur lång tid byggena tog eller vad de kostade att bygga; det beror mycket mer på integrationerna än på AI:n.
Om du planerar en agent och vill jämföra anteckningar om vad den kostar att driva tittar jag gärna på dina siffror. Min sida om utveckling av AI-agenter visar hur jag arbetar, och fallet med fastighetsintyg, fallet med ljud vid direktsändning och fallet med resebyråens priser visar tre av byggena mer i detalj. För en bot på WhatsApp väger kanalavgifterna ofta tyngre än modellen; jag har räknat ut dem per land i vad en WhatsApp-chatbot med AI kostar.
Källor
- Anthropic, alternativ i Claude Agent SDK:
max_turnsochmax_budget_usdstoppar en körning; varje resultat rapporterartotal_cost_usd. - OpenRouter, listpriser för modeller och plattformsavgifter, lästa den 15 oktober 2026.
- Anthropic, Claude-priser, och Google, priser för Gemini API, lästa den 15 oktober 2026: anteckningen om tokenisatorn och prisändringen för Gemini 4 Argon.
- Alla projektsiffror: projektens egna konfigurationsfiler, commit-meddelanden och mätta körningar, 2026.