Em resumo
Quanto custa um agente de IA a funcionar? Três coisas: as chamadas ao modelo, os sistemas que ele controla e as proteções que o impedem de falhar em silêncio. O modelo que escolhe pesa mais na fatura de tokens: mil passos iguais de um agente custam USD 0,46 no DeepSeek V4.1 Flash, USD 0,65 no Claude Haiku 5.5 e USD 26 no Claude Opus 5.5. Nos quatro sistemas que construí este ano, as chamadas ao modelo foram também a parte mais fácil de limitar: USD 0,05 para uma verificação em segundo plano e, no máximo, USD 2,10 para uma pesquisa completa. O tráfego de proxies de uma execução de um comparador de preços custou USD 3,08, e as surpresas caras foram falhas que ninguém viu, como uma avaria que durou 8 dias até ser notada.
Sou o Denys, engenheiro full-stack e de IA. A maioria dos artigos sobre este tema dá intervalos largos, sem nenhum projeto por trás. Abaixo estão os contadores de quatro coisas que construí e que mantenho em funcionamento, com a origem de cada número: ficheiros de configuração, mensagens de commit e execuções medidas. Quando um número é um limite que defini e não uma fatura que paguei, digo-o.
Quanto custa um agente de IA: o que se paga ao executá-lo?
Três contadores, e o modelo é só um deles.
| Projeto | O que a IA faz | Custo do modelo por unidade | O que mais pesa na fatura |
|---|---|---|---|
| Agente de assistente pessoal | Conversa no Telegram, trabalha no CRM e no email, faz pesquisa na web | USD 0,00065 a 0,026 por passo, conforme o modelo; limites de USD 0,05 a 2,10 por execução | Um servidor, mais novas tentativas e vigilância |
| Comparador de preços para um agente de viagens | Outro agente de IA inicia as execuções através de um servidor MCP | Zero do meu lado: esse agente paga os próprios tokens | Tráfego de proxies, cerca de USD 3,08 por execução, e um servidor de 8 núcleos |
| Verificação de áudio em emissões em direto | Deteta fala e idioma falado em cada canal | Zero por chamada: dois modelos pequenos correm no computador do local | CPU: uma demonstração com 32 canais usou cerca de 0,9 de um servidor cloud de 2 núcleos |
| Certificados de imóveis | Lê portais desconhecidos como uma pessoa | Tokens só para portais que os scripts não conhecem | Os scripts tratam do portal conhecido sem tokens |
O padrão repetiu-se nos quatro: o token mais barato é o que nunca se envia, e as horas caras vão para as partes à volta do modelo.
Quanto custam as chamadas ao modelo?
O assistente é o único dos quatro em que a fatura do modelo é minha. Corre sobre o Claude Agent SDK da Anthropic, e cada agente tem um limite rígido no código. O SDK pára a execução quando atinge o limite de turnos ou o limite em dólares.
| Tarefa | Modelo | Limite por execução |
|---|---|---|
| Verificação em segundo plano, em repouso | Claude Haiku 4.5 | USD 0,05, e USD 1,00 por dia no total |
| Pesquisa: dividir a pergunta | Claude Opus 4.6 | USD 0,10, 1 turno |
| Pesquisa: três investigadores em paralelo | Claude Opus 4.6 | USD 0,50 cada, 3 turnos, pesquisa e leitura na web |
| Pesquisa: escrever a resposta | Claude Opus 4.6 | USD 0,50, 1 turno |
| Conversa principal | Haiku, Sonnet ou Opus, ver abaixo | 200 turnos ou USD 50, uma rede de segurança e não uma expectativa |
Assim, o máximo que uma pesquisa completa pode custar é USD 0,10 + 3 × 0,50 + 0,50 = USD 2,10. É um limite, não uma média; o custo real depende do modelo, que a secção seguinte põe em preços.
Duas decisões cortaram mais a fatura do que qualquer mudança de preço:
- Encaminhar cada mensagem para o modelo mais barato que a resolve. Mensagens curtas e simples vão para o Haiku, as moderadas para o Sonnet, as de vários passos para o Opus. O encaminhador lê palavras-chave e o tamanho da mensagem, por isso não gasta nenhuma chamada ao modelo. No início, todos os agentes corriam no Opus.
- Apagar as chamadas que não justificam o lugar. A verificação em segundo plano pedia ao modelo um relatório de estado em cada ciclo. Não tinha acesso ao email nem ao CRM, por isso só escrevia mensagens de que ninguém precisava. Removi a chamada ao modelo por completo. O limite diário de USD 1,00 continua na configuração, sem proteger nada.
Uma falha assumida: o SDK indica o custo de cada chamada e eu nunca o guardei. O total mensal está na consola da Anthropic, não na aplicação. Se o construísse outra vez, registava o custo por chamada desde o primeiro dia, para ver que tarefa gasta o dinheiro e não só quanto se gasta.
Quanto muda a fatura com a escolha do modelo?
Mais do que qualquer outra coisa do lado dos tokens. Abaixo, um passo de um agente é calculado em vários modelos. O passo tem cerca de 4.000 tokens de entrada e 500 de saída, a estimativa por chamada escrita no próprio código do assistente para a verificação em segundo plano. Os preços são a lista da OpenRouter a 15 de outubro de 2026. A OpenRouter repassa o preço de lista de cada fornecedor e cobra a sua comissão quando se compram créditos (5,5% no plano normal), não por pedido.
| Modelo | Preço por 1 M de tokens, entrada / saída | Um passo | 1.000 passos |
|---|---|---|---|
| DeepSeek V4.1 Flash | USD 0,024 / 0,72 | USD 0,00046 | USD 0,46 |
| Claude Haiku 5.5, GPT-6 Luna | USD 0,10 / 0,50 | USD 0,00065 | USD 0,65 |
| Qwen3.8 Flash | USD 0,15 / 0,47 | USD 0,00083 | USD 0,83 |
| Mistral Small 4 | USD 0,15 / 0,60 | USD 0,00090 | USD 0,90 |
| Llama 4 Maverick | USD 0,188 / 0,652 | USD 0,0011 | USD 1,08 |
| Gemini 3.5 Flash Lite | USD 0,30 / 2,50 | USD 0,0025 | USD 2,45 |
| DeepSeek V4 Pro | USD 0,955 / 1,911 | USD 0,0048 | USD 4,78 |
| Gemini 3.8 Flash | USD 0,75 / 3,75 | USD 0,0049 | USD 4,88 |
| Grok 4.7 | USD 2 / 6 | USD 0,011 | USD 11 |
| Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon | USD 2 / 10 | USD 0,013 | USD 13 |
| Claude Opus 5.5 | USD 4 / 20 | USD 0,026 | USD 26 |
| Claude Fable 5.1, GPT-6 Astra | USD 10 / 50 | USD 0,065 | USD 65 |
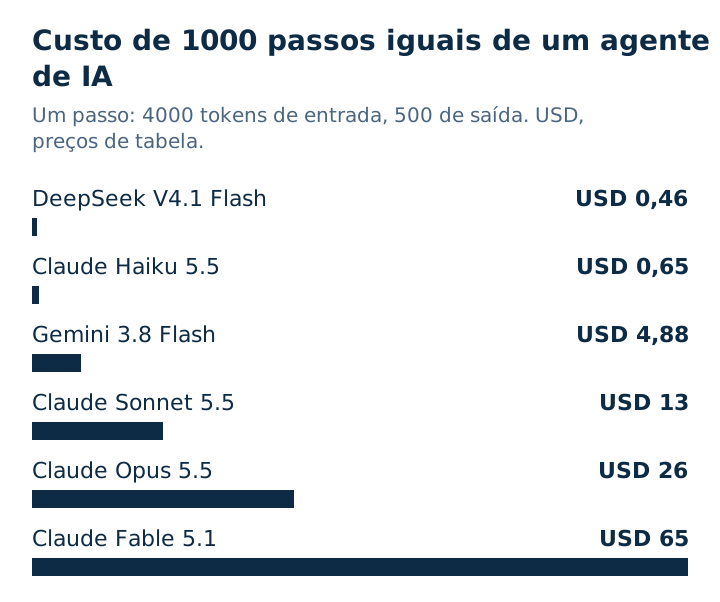
O mesmo trabalho custa de USD 0,46 a USD 65 por mil passos, uma diferença de cerca de 140 vezes. Daqui tiram-se três coisas:
- Um modelo pequeno resolve a maioria dos passos. Classificar uma mensagem, extrair campos de um documento, responder a partir de um texto conhecido: raramente precisam de um modelo de topo. Guarde os grandes para o planeamento e o raciocínio difícil, que é o que o encaminhamento acima faz.
- Os preços mudam depressa. O assistente correu em Claude Haiku 4.5, Sonnet 4.6 e Opus 4.6. Na lista de hoje, o passo custa USD 0,0065 no Haiku 4.5 e USD 0,00065 no Haiku 5.5. A Anthropic indica que os modelos mais recentes contam cerca de 30% mais tokens para o mesmo texto, pelo que, por passo, o mais novo continua a ser quase oito vezes mais barato. O Gemini 4 Argon, da Google, deve duplicar o preço a 1 de dezembro de 2026. Volte a verificar antes de planear um ano à frente.
- Compare tarefas, não preços de tokens. Um modelo mais barato que precisa de duas tentativas, ou de um prompt mais longo para se portar bem, pode custar mais por tarefa concluída. Meça uma amostra de tarefas reais em dois ou três modelos antes de escolher.
A sua estimativa é uma linha: passos por tarefa × tarefas por mês × preço do passo do seu modelo.
Porque é que o contexto foi o verdadeiro problema, e não o preço por token?
O preço por token é previsível. O contexto não. Os erros que mais custaram a este assistente tinham todos a ver com a quantidade de texto que entrava em cada chamada:
- Sessões longas estragavam as respostas. Para responder mais depressa, a aplicação mantinha uma sessão aberta entre mensagens. Quando o contexto transbordava, o modelo começava a devolver texto baralhado, em alfabetos misturados. A solução: reciclar a sessão ao fim de 20 mensagens e repetir numa sessão nova quando uma resposta parece estragada.
- Um ponto de controlo guardado ficou grande demais. Um dia, as chamadas falharam com “Prompt is too long”. O ponto de controlo injetado em cada chamada está agora limitado a 2 KB.
- O prompt do sistema levava ficheiros de que raramente precisava. Carregar as competências só quando uma mensagem as pede poupou cerca de 3.000 tokens por chamada, e retirar três ficheiros de referência do pré-carregamento poupou mais cerca de 1.500. São estimativas das notas de commit, não linhas de fatura.
- O histórico era mais longo do que útil. O histórico da conversa enviado em cada chamada passou de 20 mensagens para 10.
Todas estas mudanças baixam o custo e aceleram as respostas ao mesmo tempo. Trate o contexto como um orçamento, como trata o dinheiro.
Quanto custa a infraestrutura que um agente controla?
No comparador de preços de viagens, a parte de IA é um agente à parte. Inicia as execuções através de um servidor MCP que construí, e os tokens são faturados a quem corre esse agente. O que o próprio comparador paga é a recolha de dados por trás: proxies residenciais e um servidor cheio de navegadores.
Números medidos nesse sistema:
- Tráfego de proxies: uma execução sobre dois sites de viagens usou cerca de 935 MB, cerca de USD 3,08, aproximadamente 0,23 MB por linha de preço guardada.
- Bloquear rastreadores: num dos sites, bloquear os scripts de rastreio baixou o tráfego de 4,2 MB para 2,5 MB por pesquisa, com preços idênticos nas seis execuções de teste.
- Sem navegador onde não é preciso: os preços de um dos sites podiam ser lidos com um cliente HTTP simples que se faz passar por um navegador móvel. A recolha passou de 8 para 43 datas por minuto, com cinco processos, e o código de navegador desse site foi apagado.
- A CPU, e não a memória, define o tamanho do servidor: com 20 navegadores num servidor de 8 núcleos, a carga andou em cerca de 30 enquanto 6 a 7 GB de RAM ficavam livres. Um navegador ativo ocupa cerca de 345 MB. Dimensione o servidor pelos núcleos.
Se o seu agente controla navegadores, proxies ou APIs pagas, esses contadores provavelmente vão crescer mais do que a fatura do modelo. Meça-os por tarefa antes de escolher um modelo.
Quando é que a IA no dispositivo é mais barata do que uma API?
Quando os dados nunca precisam de sair do edifício e o modelo é pequeno. O projeto de emissões verifica canais de áudio em direto durante transmissões desportivas: silêncio, falhas, um comentador que muda para o idioma errado. Enviar cada segundo de áudio para uma API custaria dinheiro em cada chamada e acrescentaria atraso.
Em vez disso, dois modelos abertos correm no computador do próprio local: um deteta fala, o outro identifica o idioma. Juntos ocupam cerca de 24 MB de pesos, o detetor de fala acrescenta cerca de 7 MB de RAM e não há taxa por chamada. Numa demonstração com 32 canais, analisar todos os canais em tempo real usou cerca de 0,9 de um servidor cloud de 2 núcleos.
A contrapartida é uma exatidão que tem de provar por si. Num conjunto público de fala lida e limpa, com 30 clipes de três segundos por idioma, o modelo de idioma acertou em 93,3% dos casos para português e em pelo menos 96,7% para espanhol, inglês e francês. É um teto, não uma previsão: o ruído do público e a música por baixo de um comentador nunca foram medidos, porque não havia áudio de um circuito de emissão real.
Quanto custa tornar um agente seguro para o deixar sozinho?
Este é o custo que a maioria das estimativas ignora, e foi para aqui que foram as minhas horas. Algumas falhas reais:
- Uma avaria silenciosa de 8 dias. Outro projeto no mesmo servidor atualizou uma cache de navegadores partilhada. O conjunto do recolhedor passou de 40 navegadores a funcionar para 0, as tarefas ficaram penduradas sem erro e nenhum alerta avisou ninguém. A solução foi pequena: dar ao recolhedor a sua própria cache de navegadores. Descobrir a causa levou 8 dias, porque não havia alerta para a disponibilidade do conjunto.
- Uma tarefa que “teve sucesso” sem nada. Uma execução percorreu 359 datas em 12 minutos, guardou 0 linhas e comunicou sucesso. Agora as tarefas param após 25 datas vazias seguidas e dizem porquê.
- Uma execução parada que continuava a gastar. Um teste de comparação marcado como parado continuou a correr durante 4 horas, a gastar tráfego de proxies o tempo todo.
- Um limite de proxies esvaziou o conjunto. Quando o plano de proxies atingiu o limite de tráfego, o conjunto encolheu de 40 navegadores para 0 em 12 minutos e ficou assim até um reinício. Agora volta a encher-se sozinho de 60 em 60 segundos, recuando até 5 minutos.
- Demasiados alertas no primeiro dia. O primeiro teste da ferramenta de emissões num sinal real de 16 canais, com 49 minutos, produziu 3.492 eventos. 92,4% eram ruído e alertas de mudança de voz, e o operador carregou 182 vezes em Limpar em 27 minutos. Os detetores estavam bem; os limiares nunca tinham encontrado áudio de programação real. A solução foi um interruptor por perfil, não matemática nova.
- Chamadas penduradas e limites de pedidos. O assistente tem agora um vigilante de 120 segundos para uma chamada que fica calada, um limite de 300 segundos para a chamada inteira e até 3 novas tentativas, passados 30 segundos, 2 minutos e 5 minutos, quando a API está sobrecarregada ou com limite de pedidos. Uma chamada de ferramenta pendurada não passa para os modelos de reserva, porque um modelo mais lento não resolve uma ferramenta bloqueada.
Nada disto aparece como preço de token. Aparece como horas, e como confiança perdida quando o agente diz “feito” e está errado. Reserve orçamento para isto: um primeiro teste com dados reais, alertas para o que pode falhar em silêncio e verificações de que um “sucesso” produziu algo.
Onde entra a IA quando os scripts fazem quase todo o trabalho?
Nas margens. O serviço de certificados de imóveis recolhe documentos das contas online dos administradores de condomínio e monta o certificado de que o vendedor precisa. Um script trata do principal portal conhecido, onde 95% dos documentos ficam completos. A IA de visão lê apenas os portais que os scripts não conhecem, e esse caminho está atrás de um interruptor que o desliga de imediato.
Para quem os encomenda, um certificado demora agora 2 a 3 minutos em vez de 2 a 3 semanas, e custa EUR 99 em vez de EUR 200 a 300. A IA é a parte mais pequena deste processo de propósito: os scripts são baratos e previsíveis onde funcionam, e o modelo é usado onde só ler como uma pessoa resolve.
Como estimar o custo de funcionamento do seu próprio agente?
Antes de pedir um orçamento, escreva cinco números:
- Tarefas por mês. Mensagens, documentos, execuções.
- Chamadas ao modelo por tarefa, e qual o modelo de cada uma. A maioria das tarefas não precisa do modelo de topo.
- Tokens por chamada. Prompt do sistema, histórico, documentos. É aqui que os custos crescem em silêncio.
- Os outros contadores. Proxies por MB, APIs pagas por chamada, servidores por núcleo.
- Um limite para cada tarefa. Um teto em dólares por execução, no código, e não só um limite mensal na conta.
Depois some o custo que ninguém orça: um teste com dados reais na primeira semana, alertas para falhas silenciosas e alguém que os leia.
O que é que estes números não dizem?
Os limites acima são tetos que defini, não o que foi gasto, e a tabela de modelos mostra preços de lista, não as minhas faturas. Cada número de projeto vem de um só sistema e de um só período. Os preços dos modelos mudam com frequência, por isso consulte as páginas de preços dos fornecedores antes de planear. E nada disto diz quanto tempo demoraram as construções nem quanto custaram; isso depende muito mais das integrações do que da IA.
Se está a planear um agente e quer comparar notas sobre o custo de funcionamento, terei gosto em ver os seus números. A minha página de desenvolvimento de agentes de IA mostra como trabalho, e o caso dos certificados de imóveis, o caso do áudio de emissões e o caso dos preços de viagens mostram três destas construções com mais detalhe. Para um bot no WhatsApp, as taxas do canal pesam muitas vezes mais do que o modelo; calculei-as por país em quanto custa um chatbot de IA para WhatsApp.
Fontes
- Anthropic, opções do Claude Agent SDK:
max_turnsemax_budget_usdparam uma execução; cada resultado indicatotal_cost_usd. - OpenRouter, preços de lista dos modelos e taxas da plataforma, consultados a 15 de outubro de 2026.
- Anthropic, preços do Claude, e Google, preços da API Gemini, consultados a 15 de outubro de 2026: a nota sobre o tokenizador e a mudança de preço do Gemini 4 Argon.
- Todos os números dos projetos: os ficheiros de configuração, as mensagens de commit e as execuções medidas dos próprios projetos, 2026.