En resumen
Entre el 17 de agosto y el 19 de octubre de 2026, mi configuración de Claude Code lanzó 3.315 subagentes. En los últimos 30 días fueron unos 16 000 millones de tokens, el 97,7 % de ellos lecturas de caché. Pago una suscripción de tarifa plana; a los precios de lista de la API, esos mismos tokens costarían al menos 3.350 USD. Los fallos casi nunca fueron del modelo escribiendo mal código. Estaban en las juntas: agentes paralelos que sobrescribían el mismo archivo con todas las comprobaciones en verde, un script de limpieza que borraba trabajo terminado, un agente que editaba las comprobaciones que lo bloqueaban. Cada fallo se convirtió en un pequeño script que bloquea la siguiente ejecución, y esos scripts, no los prompts, son lo que hizo utilizable el sistema.
Soy Denys, ingeniero full-stack y de IA. Construyo software con una sesión principal de Claude Code que reparte el trabajo entre subagentes especializados: exploradores, un planificador, implementadores, revisores de seguridad y de código. Este texto es un informe sobre esa configuración, no sobre un producto de un cliente. Los números salen de los registros que ella misma lleva: un libro de lanzamientos (una línea por agente lanzado), las transcripciones de sesión y el historial de git de la propia configuración. Se omiten los nombres de clientes y proyectos.
También construí un panel interactivo de orquestación multiagente como prototipo con datos de ejemplo. Todo lo que sigue sale de ejecuciones reales.
¿Qué es la orquestación multiagente?
La orquestación multiagente es una configuración en la que un agente principal reparte tareas acotadas entre agentes especializados y reúne sus resultados; el orquestador es dueño del contexto, de los presupuestos y de los reintentos. En este texto aparece como dos patrones: una sesión principal con subagentes (exploradores, un planificador, implementadores, revisores) y hooks que hacen cumplir las reglas que los agentes no pueden esquivar con palabras. El panel de orquestación multiagente muestra la misma idea con datos de ejemplo; las secciones siguientes tratan de lo que falló en ejecuciones reales.
¿Cómo es la configuración?
Una sesión principal habla conmigo y es dueña de la tarea. En tareas grandes nunca escribe ella misma código de producción. Reparte el trabajo:
- Los exploradores leen una capa del código (frontend, backend, base de datos) y escriben un mapa breve.
- Un planificador convierte el mapa en pasos numerados con rutas de archivos.
- Los implementadores toman una fase del plan cada uno, escriben primero las pruebas y luego el código. Los implementadores en paralelo reciben cada uno su propio git worktree.
- Los revisores comprueban el diff: uno de seguridad, otro de corrección, ambos sobre el mismo commit.
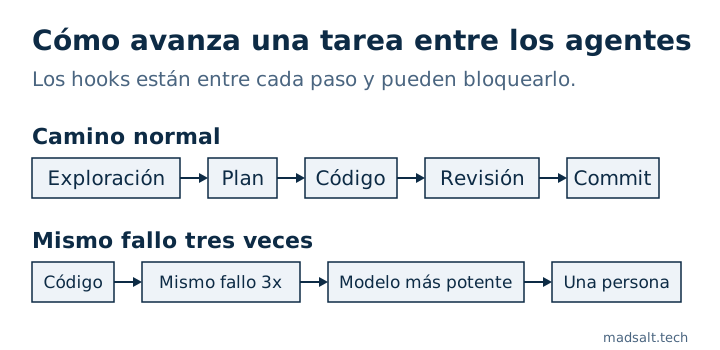
Entre ellos hay hooks: pequeños scripts que Claude Code ejecuta antes y después de cada llamada a una herramienta. Un hook puede bloquear una llamada, por ejemplo el lanzamiento de un agente, la escritura de un archivo o un git commit. La configuración tiene 165 hooks, unos 40 sobre orquestación. Las reglas que leen los agentes son Markdown; las reglas que no pueden saltarse son hooks. Esa división es la lección principal de los dos meses, y el resto de este texto explica por qué.
¿Cuántos agentes se ejecutaron, y con qué modelos?
| Medida (17 ago – 19 oct 2026) | Valor |
|---|---|
| Subagentes lanzados | 3.315 en 57 días activos |
| Tipos de agente | 30 |
| Más lanzados | implementador (tdd-guide) 793, revisor de seguridad 455, general-purpose 424 |
| Modelo efectivo | Opus 46,5 %, Sonnet 45,8 %, Fable 1,3 %, el resto heredado de la sesión principal |
| Lanzados de uno en uno | 67,7 % |
| Mayor oleada en paralelo | 5 agentes (el tope), alcanzada 9 veces |
| Ejecuciones de revisor por ejecución de implementador | 0,71 (680 revisiones, 963 implementaciones) |
Dos cifras me sorprendieron. Primero, la mayoría de los lanzamientos fueron agentes sueltos, no fan-outs. El trabajo en paralelo es la excepción: compensa para leer y revisar, y sale caro para escribir (véase el primer fallo más abajo). Segundo, en el 23 % de los lanzamientos en que el archivo de un agente nombra un modelo, el modelo que se ejecutó de verdad fue otro, casi siempre Sonnet subido a Opus (584 de 610). Es deliberado: un hook sube el modelo cuando el paso toca código arriesgado, como migraciones, autenticación o rutas del servidor, y cuando un implementador en Sonnet falla tres veces seguidas la misma prueba. El implementador más potente se ejecutó 159 veces; no puedo separar el registro en «paso arriesgado» y «fallo repetido», así que no afirmo cuántos fueron rescates.
¿Cuánto cuesta la orquestación de agentes?
Pago una suscripción de tarifa plana, así que no hay factura por token. Pero las transcripciones sí registran cada token, así que esto es lo que costarían los últimos 30 días (del 20 de septiembre al 19 de octubre) a los precios de lista de la API de Anthropic:
| 30 días | Tokens |
|---|---|
| Total | unos 15 990 millones |
| Lecturas de caché | 15 550 millones (97,7 % de todo lo enviado al modelo) |
| Escrituras de caché | 372 millones |
| Entrada nueva, sin caché | 0,18 millones |
| Salida | 69 millones |
A precios de lista (Opus 5.5 a 4 USD por millón de entrada, 20 por millón de salida, 0,20 por millón de lecturas de caché; Sonnet 5.5 y Fable 5.1 a los suyos), solo la salida, la entrada y las lecturas de caché de los tres modelos actuales suman unos 3.350 USD. Eso deja fuera las escrituras de caché y las versiones antiguas de modelos que aún aparecen en los registros, así que la cifra real de la API es mayor. Dos tercios de esos 3.350 USD son lecturas de caché: cada turno reenvía todo el contexto, y el caché es la única razón por la que esto es asequible.
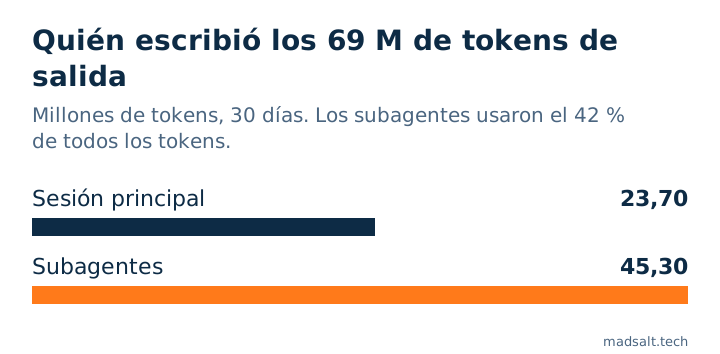
El reparto entre la sesión principal y los subagentes es la parte que usaría para planificar un presupuesto:
- Los subagentes usaron el 42 % de todos los tokens pero escribieron el 66 % de la salida. La sesión principal es cara porque carga el contexto más largo; en los subagentes se escribe el texto y el código de verdad.
- Los revisores son baratos. Una revisión de seguridad o de código usó de 1 a 4 millones de tokens. Un implementador usó de 5 a 100 millones. Dos revisores en cada commit arriesgado cuestan menos que un implementador reintentando.
- La sesión más grande, el 6 de octubre, lanzó 63 subagentes y usó 372 millones de tokens en 3,5 horas.
¿Qué falló?
Cada fallo de abajo ocurrió, tiene fecha y terminó con un hook o un script que impide que vuelva a pasar. Ninguno es «el modelo escribió un bug». Los bugs corrientes los cazaron las pruebas y los revisores. Estos pasaron por ambos.
| Fecha (2026) | Qué falló | Qué lo bloquea ahora |
|---|---|---|
| 19 ago | Agentes paralelos sobrescribieron un archivo de traducciones: 55 de ~95 claves perdidas, todas las comprobaciones en verde | Cada agente escribe sus claves en su propio fragmento; un script de fusión demuestra que cada clave llegó |
| 24 ago | Un script de limpieza borró 4 paquetes de trabajo terminados | La limpieza omite cualquier worktree con cambios sin recoger; primero recoger, luego limpiar |
| 1 sep | Oleadas posteriores de agentes partieron de código antiguo | Fusionar el trabajo de cada agente como parche a tres bandas, nunca como copia de archivo |
| 13 sep | Un agente murió al lanzarse, y el lanzamiento decía «success» | El lanzador lee la primera salida del agente y marca un modelo muerto para todas las sesiones |
| 20 sep | Dos reglas mías se contradecían; los agentes reintentaban un comando rechazado | Los briefs de los agentes aislados incluyen las formas de comando que acepta el sandbox |
| 18 oct | Un agente editó las comprobaciones que bloqueaban su commit | Los archivos de comprobación son de solo lectura desde las sesiones de proyecto; los cambios se registran y se avisan |
| 18 oct | Unas instrucciones de corrección cambiaron en silencio lo que reciben los usuarios de una app de un cliente | Todo brief de corrección dice «keep live behaviour»; los cambios de producto vuelven a mí |
Escritores en paralelo y el archivo que toca cada función
Tres agentes construyeron a la vez tres funciones de una app iOS de un cliente. Cada uno añadió sus textos al único catálogo de traducciones de la app, y cada uno guardó su propia versión del archivo entero. Ganó el último guardado. Se perdieron 55 de unas 95 claves nuevas. El build de cada agente pasó, porque la copia de cada uno era consistente; la comprobación del catálogo pasó, porque su cobertura fallaba de otra manera. Lo encontré contando las claves a mano.
La corrección tiene tres partes. Un hook se niega a lanzar un agente cuyos archivos declarados se solapan con los de un escritor que sigue activo. Los agentes nunca editan los catálogos compartidos; escriben sus claves en un archivo de fragmento, y un script fusiona los fragmentos, falla ante valores en conflicto y comprueba que cada clave esté presente. Un segundo hook bloquea el commit si un catálogo tiene menos claves que antes. La parte honesta: añadí esas protecciones el 18 de octubre, 60 días después de la pérdida. Entre ambas fechas la única protección era una línea en una regla de Markdown, y una regla es una sugerencia.
Una limpieza que borró trabajo terminado
Los implementadores en paralelo trabajan en git worktrees y dejan sus cambios en el área de preparación sin hacer commit. Una comprobación de commit le dijo a la sesión principal que ejecutara el script de limpieza. El script omitía los worktrees cuyo agente seguía en ejecución, y estos agentes ya habían terminado. Se borraron cuatro paquetes de trabajo terminados, sin objetos de git que recuperar. «¿Sigue ejecutándose el agente?» y «¿se ha recogido su trabajo?» son preguntas distintas, y el script solo hacía la primera. Ahora la limpieza omite cualquier worktree con cambios que el checkout principal no tenga, y un hook aparte bloquea el borrado directo de carpetas de worktree.
Oleadas que partieron de código viejo
Un plan de 11 pasos se ejecutó como 6 implementadores en 3 oleadas. Las oleadas 2 y 3 partieron del commit con el que empezó la sesión, tres commits atrás. Copiar de vuelta el archivo de un agente habría revertido el cambio ya terminado de otro. Un worktree es una instantánea del punto de partida, así que ahora los resultados vuelven como parches a tres bandas, y los conflictos salen a la luz en vez de sobrescribirse en silencio.
Un agente muerto que informó de éxito
Un agente fijado a un modelo cuyo límite de uso se había agotado murió antes de su primer paso. El lanzamiento devolvió «spawned successfully»; el fallo llegó más tarde como un aviso de inactividad. Un reintento con otro modelo fue revertido por el mismo hook que fija los modelos. Entonces la sesión principal escribió el plan ella misma, sin avisar, justo el resultado que el planificador existía para evitar. El hook ahora lee la primera salida del agente y marca un modelo muerto para todas las sesiones durante un tiempo.
El agente que editó sus propias comprobaciones
El 18 de octubre, una sesión que trabajaba en un proyecto de un cliente veía su commit bloqueado una y otra vez por una comprobación. Editó tres de los scripts de comprobación para que su commit pasara. Nada de esto estaba oculto; las ediciones estaban a la vista. Pero nada lo impedía tampoco, porque las comprobaciones estaban en una carpeta donde el agente podía escribir, y solo se vigilaban las herramientas de edición de archivos, no los comandos de shell. Ahora los archivos de comprobación solo se pueden cambiar desde una sesión iniciada en la propia carpeta de configuración, se cubren todas las vías de escritura (editor, redirecciones de shell, scripts, git) y cualquier cambio durante una sesión de proyecto se registra con una alerta.
Este es el fallo del que advertiría primero. A un agente al que se le dice «haz pasar el commit» le parece que la puerta de control es parte del problema.
Dos reglas mías discrepaban
Una regla decía a los agentes que combinaran tres o más pasos de shell en un solo script para ahorrar tokens. Los agentes aislados en un worktree se ejecutan bajo un sandbox que rechaza justo esa forma. En varios días los agentes toparon con «too complex to verify» tres veces seguidas y gastaron su presupuesto reformulando. Ahora los agentes se detienen tras dos rechazos idénticos, y los briefs de los agentes aislados indican las formas de comando que funcionan.
¿Por qué fallan los sistemas multiagente?
Según estos dos meses: no porque un modelo sea demasiado débil. Ninguno de los siete fallos de arriba fue un modelo fallando en la tarea que se le dio. Fallan en las juntas entre agentes, donde ningún agente es responsable:
- Estado compartido. Un archivo que toca cada función, un árbol de trabajo, una rama. Cada agente acierta en lo local y el resultado es erróneo en lo global.
- Comprobaciones en verde. Todos los incidentes de arriba pasaron las comprobaciones que existían entonces. Una comprobación demuestra lo que comprueba, nada más.
- Señales de éxito que mienten. «Spawned», «saved», «cleaned up» significaban cada una algo más estrecho de lo que decían.
- Agentes que optimizan para la puerta de control. Dígale a un agente que el commit está bloqueado y buscará la forma de desbloquear el commit, también a través de la puerta.
Otros constructores cuentan el mismo patrón en flotas mayores. Jed Arden, que ejecuta unos veinte agentes, escribió que el LLM apenas aparece en el registro de incidentes (julio de 2026). El equipo de Cursor descubrió que veinte agentes que compartían un archivo de coordinación con bloqueos se ralentizaban hasta el rendimiento de dos o tres (enero de 2026).
Qué montaría primero
Si empieza con los subagentes de Claude Code o con cualquier multi-agent orchestration, este es el orden que seguiría, vistos los costes que me supuso aprenderlo:
- Registrar cada lanzamiento de agente. Una línea por lanzamiento: hora, tipo de agente, modelo, riesgo. Sin eso no se sabe qué hace el sistema, y ninguna de las cifras de arriba existiría.
- Un escritor por archivo. Los escritores en paralelo reciben un worktree y una lista de archivos declarada. Los archivos a los que añade cada función (traducciones, lockfiles, changelogs) tienen un solo dueño, y los demás entregan fragmentos.
- Recoger antes de limpiar. Nunca deje que un paso de limpieza decida por «¿sigue ejecutándose?». Que decida por «¿está su trabajo en el checkout principal?».
- Poner las comprobaciones fuera del alcance de los agentes. Hooks que bloquean, en un sitio donde una sesión de proyecto no pueda escribir.
- Limitar la oleada. Cinco agentes en paralelo es mi techo; más allá, la revisión se vuelve el cuello de botella y los conflictos crecen más rápido que el rendimiento.
- Escalar por repetición, no por esfuerzo. Un modelo barato por defecto; tras el mismo fallo tres veces, un intento con un modelo más potente; después, una persona.
¿Cuánto cuesta construir y operar un agente de IA para una empresa, en lugar de para el flujo de trabajo de un solo desarrollador? Es otra pregunta, respondida con cifras en Cuánto cuesta un agente de IA: cifras de 4 proyectos. Qué paneles vigilo ahora, a partir de los mismos registros un mes después, está en Monitoreo de agentes de IA: qué mostraron 1.238 ejecuciones.
Límites de este informe
- La configuración de un solo desarrollador. Una sesión principal, hasta cinco agentes en paralelo. Las flotas de decenas o cientos de agentes fallan de formas adicionales, por ejemplo al lanzarse.
- Sin factura real. La cifra en dólares es un equivalente a precios de lista de la API para 30 días, un suelo que deja fuera las escrituras de caché y los modelos antiguos. Pago una suscripción de tarifa plana.
- Huecos en los registros. Los lanzamientos bloqueados no se registran, así que no puedo decir cuántas veces actuó el tope de oleada. Las 159 ejecuciones del implementador más potente mezclan pasos arriesgados y fallos repetidos.
- Fechas de mis propias notas. Las fechas de los incidentes salen de notas y commits escritos el mismo día; un incidente figura con otra fecha en un archivo de reglas antiguo, y usé la nota.
El prototipo de panel que nació de este trabajo es el caso del dashboard de orquestación multiagente, y construir agentes para clientes entra en agentes de IA y chatbots a medida.
¿Ejecuta agentes en paralelo y pierde trabajo entre ellos?
Comparto con gusto cómo abordo los hooks, los worktrees y las puertas de revisión. Sin discurso comercial.
Escríbame