Kurz gesagt
Beim Auslesen von Rechnungen mit KI lasen drei der vier getesteten Modelle auf sauberen digitalen Rechnungen alle neun Felder bei 30 von 30 Rechnungen richtig. Auf simulierten Scans derselben Rechnungen schaffte das beste Modell 22 von 30. Die Fehler steckten fast nie in den Beträgen, sondern in USt-IdNrn. und Rechnungsnummern, und das übliche Sicherheitsnetz, die Prüfung, ob netto plus Umsatzsteuer den Gesamtbetrag ergibt, markierte nur 3 der 63 falschen Rechnungen. Zwei einfache Regeln für die USt-IdNrn. erwischten 31 der 32 falschen Rechnungen der drei besten Modelle. Das günstigste Modell kostete USD 0,43 je 1.000 Rechnungen, kam bei Scans aber nicht an das 17-mal so teure Modell heran: 14 von 30 gegenüber 22. Gemini 3.8 Flash erreichte die 22 von Sonnet zum etwa halben Preis.
Ich habe diesen Test am 22. Oktober 2026 mit einem neuen Satz fiktiver Rechnungen wiederholt. Alle Zahlen in diesem Artikel stammen aus dem neuen Lauf.
Ich bin Denys, Full-Stack- und KI-Entwickler. Anfang des Jahres habe ich einen Prototyp zum Auslesen von Rechnungen gebaut: eine Web-App und eine API, die aus PDF-Rechnungen Felder machen und unsichere Felder zur Prüfung an einen Menschen geben. Er läuft mit Beispieldaten, ohne Modell dahinter. Bevor ich über das Auslesen von Rechnungen schreibe, habe ich deshalb einen echten Test gemacht: 30 fiktive tschechische, deutsche und portugiesische Lieferantenrechnungen, vier Modelle, 240 Aufrufe, USD 0,76 abgerechnete Nutzung.
Rechnungen auslesen mit KI: Was klappt und was nicht?
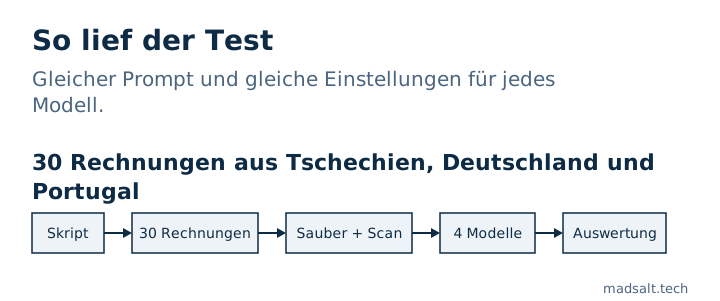
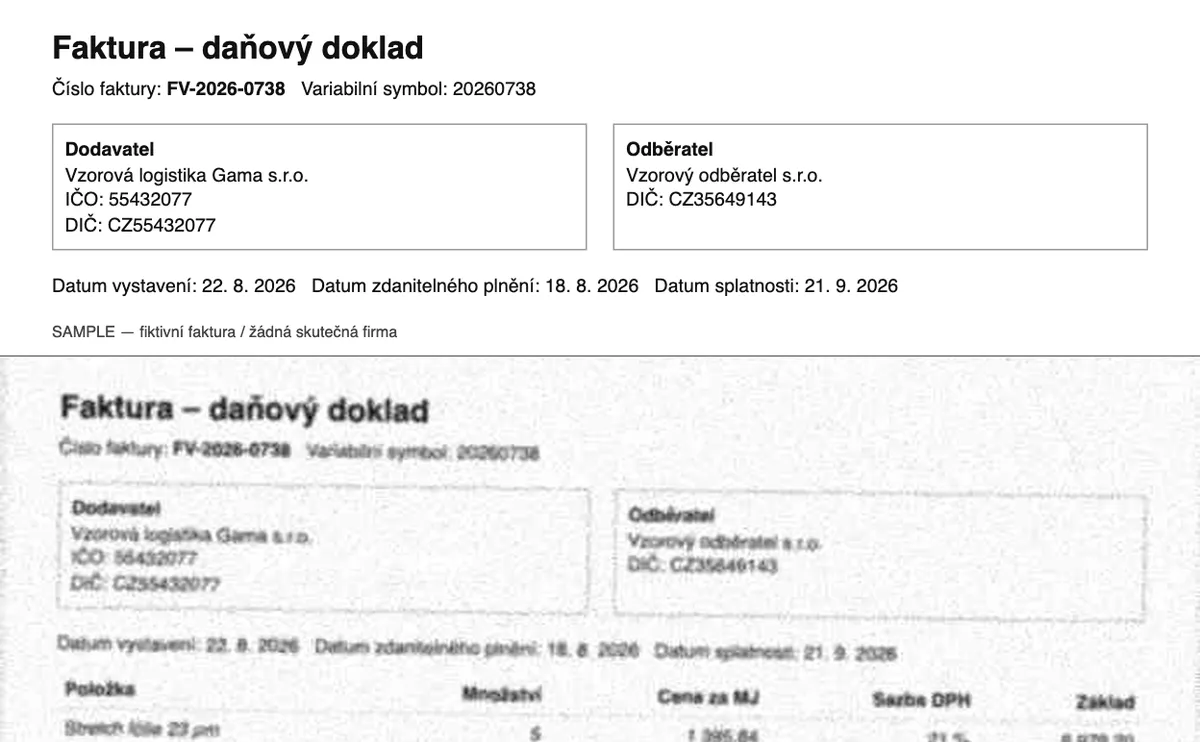
Jedes Modell las jede Rechnung zweimal: als saubere Darstellung, so wie ein PDF aus der Buchhaltungssoftware aussieht, und als simulierten Scan, grau, leicht gedreht, unscharf und komprimiert. Eine Rechnung zählt nur dann als richtig, wenn alle neun Felder stimmen: Rechnungsnummer, Rechnungsdatum, Fälligkeitsdatum, USt-IdNr. des Lieferanten, USt-IdNr. des Käufers, Währung, Nettosumme, Umsatzsteuer und Bruttosumme.
| Modell | Sauber, alle 9 Felder richtig | Scan, alle 9 Felder richtig | USD je 1.000 Rechnungen | Median Sekunden je Rechnung |
|---|---|---|---|---|
| Claude Haiku 5.5 | 30 von 30 | 14 von 30 | 0,43 | 6,13 |
| Claude Sonnet 5.5 | 30 von 30 | 22 von 30 | 7,18 | 8,50 |
| Gemini 3.8 Flash | 30 von 30 | 22 von 30 | 3,51 | 8,43 |
| GPT-5.6 Luna | 29 von 30 | 0 von 30 | 1,52 | 10,85 |
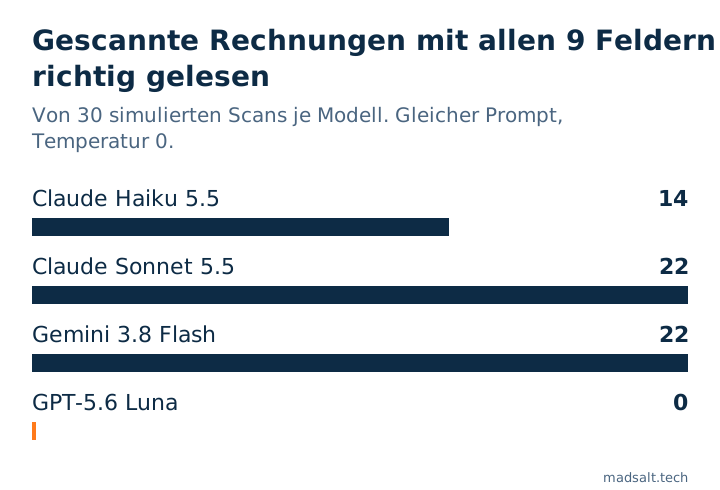
Die Kosten sind das, was OpenRouter für jeden Aufruf abgerechnet hat, keine Schätzung nach Preisliste. Auf sauberen Rechnungen waren Claude Haiku 5.5 und Claude Sonnet 5.5 gleich gut, 30 von 30. Auf Scans las Sonnet 22 richtig gegenüber 14 bei Haiku und kostete etwa 17-mal mehr.
Brauchen Sie noch OCR, um Rechnungsdaten auszulesen?
In diesem Test nicht als eigenen Schritt. Alle vier Modelle bekamen die Seite als Bild und gaben die neun Felder direkt zurück, ohne OCR-Schicht dazwischen. Das Ergebnis ändert sich mit der Qualität der Seite. Ein sauberes PDF aus der Buchhaltungssoftware hat eine Textschicht, ein Scan nicht: Er besteht nur aus Pixeln. Die Spalte „Scan“ in der Tabelle oben ist genau die Frage nach der OCR-Qualität, und hier unterscheiden sich die Modelle: Das beste las 22 von 30 gescannten Rechnungen richtig, das schwächste keine.
Klassische OCR-Engines oder vorlagenbasierte Werkzeuge habe ich nicht getestet, deshalb kann ich nicht sagen, wie sie bei denselben 30 Rechnungen abschneiden würden. Der Test zeigt, wo das Risiko liegt, wenn ein Modell einen Scan liest: in USt-IdNrn. und Rechnungsnummern, die die Prüfungen weiter unten finden.
Wie war der Test aufgebaut?
Ich habe die Rechnungen mit einem Skript erzeugt, damit jeder wahre Wert auf den Cent bekannt ist. Die Rechnungen sind fiktiv: Die Firmennamen tragen die Wörter Vzor, Muster, Beispiel oder Exemplo, und jede Rechnung hat eine Fußzeile in der Landessprache mit dem Text „SAMPLE - fictitious invoice / no real company“. Jede enthält die Fallen, auf die ein echter Sachbearbeiter in der Kreditorenbuchhaltung in diesem Land trifft:
- Landestypische Zahlenformate.
175 011,84 Kčauf Tschechisch,10.465,61 €auf Deutsch, und auf portugiesischen Rechnungen sowohl1 234,56als auch1.234,56. - Eine zweite Kennung neben der Rechnungsnummer. Das tschechische variable Symbol, die deutsche Kundennummer, der portugiesische ATCUD-Code.
- Ein zweites Datum. Das tschechische Datum der steuerbaren Leistung und das deutsche Leistungsdatum stehen neben dem Rechnungsdatum.
- Zwei USt-IdNrn. auf einer Seite, dazu eine deutsche Steuernummer, die wie eine USt-IdNr. aussieht, aber keine ist.
- Schwierige Fälle. Gemischte Steuersätze, eine Rechnung ohne Umsatzsteuer, eine Rechnung mit Reverse-Charge, eine Gutschrift mit negativen Beträgen und in jedem Land eine Rechnung mit neun Positionen.
Jede USt-IdNr. hat eine gültige Prüfziffer, geprüft mit der Bibliothek python-stdnum, und keine davon ist registriert: Ich habe jede der 33 verwendeten Kennungen (30 Lieferanten-IDs und eine Käufer-ID je Land) im VIES-Dienst der EU nachgeschlagen, und er antwortete bei allen mit „nicht gültig“. Die 11 tschechischen Firmennummern hinter den tschechischen Kennungen habe ich außerdem im tschechischen Unternehmensregister ARES nachgeschlagen und nicht gefunden. Alle vier Modelle bekamen denselben Prompt bei Temperatur 0, ein Aufruf je Bild.
Warum fand die Summenprüfung fast nichts?
Zu prüfen, ob netto plus Umsatzsteuer den Bruttobetrag ergibt, ist die erste Regel, die die meisten Auslese-Pipelines ergänzen, und die, die mein Prototyp nutzt. In diesem Test hat sie 3 der 63 falschen Rechnungen über die vier Modelle markiert: einen Scan von Gemini 3.8 Flash (cz06, Bruttosumme falsch), einen Scan von GPT-5.6 Luna (cz08, bei dem Rechnungsdatum, USt-IdNr. des Käufers, Netto und Umsatzsteuer falsch waren) und eine saubere Rechnung von Luna (pt02, Nettosumme falsch).
Der Grund liegt darin, wo die Fehler waren. Claude Haiku 5.5, Claude Sonnet 5.5 und Gemini 3.8 Flash machten zusammen 32 falsche Auslesungen, und nur zwei hatten einen falschen Betrag: der Gemini-Scan oben und ein Haiku-Scan (cz09), bei dem Netto- und Umsatzsteuersumme leicht abwichen, netto plus Umsatzsteuer aber trotzdem brutto ergab, die Prüfung blieb also stumm. Die übrigen verlasen eine Ziffer in einer USt-IdNr. oder in einer Rechnungsnummer, etwa FV-2026-0738, gelesen als FV-2026-0758. GPT-5.6 Luna las bei 7 Rechnungen tatsächlich Beträge falsch, doch bei 5 davon ergaben Netto, Umsatzsteuer und Brutto weiterhin eine stimmige Summe. Ein Modell liest eine Summe, die zum Rest des Gelesenen passt, und deshalb geht eine Rechenprüfung über die meisten seiner Fehler hinweg.
Welche Prüfungen finden die Fehler?
Zwei Regeln für die USt-IdNrn., beide wenige Zeilen Code:
- Die Prüfziffer. Eine USt-IdNr. endet mit einer Prüfziffer, die aus den übrigen Ziffern berechnet wird: Modulo 11 für die tschechische Firmennummer hinter einer DIČ und für die portugiesische NIF, ISO 7064 für die deutsche USt-IdNr. Bibliotheken wie python-stdnum setzen alle drei um. Eine falsch gelesene Ziffer bricht sie fast immer.
- Ihre eigene USt-IdNr. Auf einer Eingangsrechnung sind Sie der Käufer. Jede USt-IdNr. des Käufers, die nicht Ihre ist, ist falsch, oder die Rechnung war nicht für Sie bestimmt.
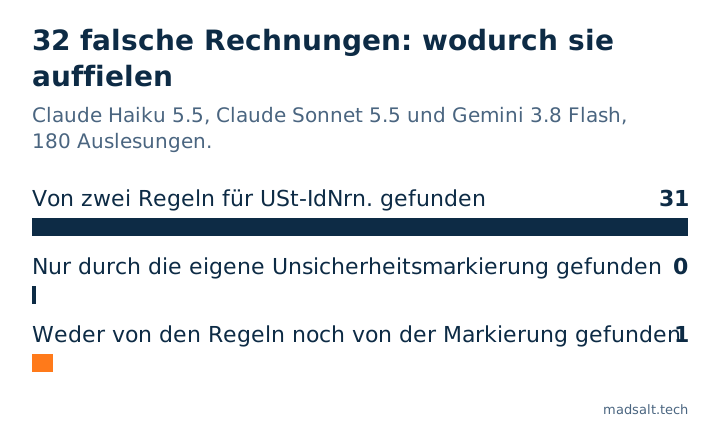
Die eine übrige, der Gemini-Scan cz06, hatte eine falsche Bruttosumme. Keine Regel für USt-IdNrn. kann das sehen, und Gemini nennt nie unsichere Felder, deshalb fand nur die Summenprüfung es. Ich bat jedes Modell, die Felder aufzulisten, bei denen es unsicher war:
| Modell | Falsche Rechnungen | Von den zwei Regeln gefunden | Nur durch die Unsicherheitsmarkierung gefunden | Nicht gefunden | Richtige Rechnungen, die es trotzdem markierte |
|---|---|---|---|---|---|
| Claude Haiku 5.5 | 16 | 16 | 0 | 0 | 13 von 44 |
| Claude Sonnet 5.5 | 8 | 8 | 0 | 0 | 19 von 52 |
| Gemini 3.8 Flash | 8 | 7 | 0 | 1 | 0 von 52 |
| GPT-5.6 Luna | 31 | 30 | 0 | 1 | 0 von 29 |
Gemini 3.8 Flash nannte nie ein Feld als unsicher, bei ihm bleiben also nur die Prüfungen; hier fanden die zwei Regeln 7 seiner 8 falschen Rechnungen und die Summenprüfung die achte. Die Claude-Modelle markierten eher zu viel als zu wenig: Haiku markierte 13 seiner 44 richtigen Rechnungen (30 %) und Sonnet 19 von 52 (37 %), alle davon Scans; keines markierte eine einzige saubere Rechnung. Diesen Tausch will man in der Kreditorenbuchhaltung, wo ein Blick eines Sachbearbeiters weniger kostet als eine falsche Zahlung.
Zwei weitere Dinge zeigten sich. Die Fehler von GPT-5.6 Luna beschränkten sich nicht auf Kennungen: Von seinen 31 falschen Rechnungen waren 30 Scans, 20 hatten eine falsche Rechnungsnummer, 13 ein falsches Rechnungsdatum und 15 ein falsches Fälligkeitsdatum, und bei 7 Rechnungen waren 15 Betragsfelder falsch. Seine eine Rechnung in der Spalte „Nicht gefunden“ ist eine saubere, pt02, mit falscher Nettosumme: Die zwei Regeln und seine Unsicherheitsmarkierung übersahen sie, die Summenprüfung nicht. Und eine Prüfziffer kann nicht jede Fehllesung finden, weil manche falschen Nummern ebenfalls gültig sind; in diesem Lauf bestand keine falsche USt-IdNr. beide Regeln.
Welches Modell sollten Sie zum Auslesen von Rechnungen nehmen?
Bei diesem Satz lauteten die Scan-Ergebnisse: Claude Sonnet 5.5 22 von 30 bei 8 falschen Rechnungen zu USD 7,18 je 1.000; Gemini 3.8 Flash ebenfalls 22 von 30 bei 8 falschen Rechnungen zu USD 3,51, etwa dem halben Preis; Claude Haiku 5.5 14 von 30 bei 16 falschen zu USD 0,43. Gemini erreichte Sonnets Genauigkeit zum halben Preis, nennt aber nie unsichere Felder: Seine falschen Rechnungen fanden die zwei Regeln für die USt-IdNrn. (7) und die Summenprüfung (1), während Sonnet außerdem 19 seiner 52 richtigen Rechnungen markierte. Mit den Prüfungen blieb keine der falschen Rechnungen von Haiku oder Sonnet unbemerkt; das günstigste Modell bedeutet also mehr falsche Rechnungen zu korrigieren (16 gegenüber 8), nicht mehr Fehler im Hauptbuch. Wenn Sie jede Rechnung an ein Modell schicken, ist das Modell selten der große Kostenblock; bei den Kosten eines KI-Agenten ist es genauso. GPT-5.6 Luna ist in diesem Test auf Scans nicht brauchbar.
Diese Rangfolge stammt aus einem Test mit 30 Rechnungen. Lassen Sie Ihre eigenen Rechnungen durch zwei oder drei Modelle laufen, bevor Sie sich entscheiden.
Brauchen Sie überhaupt ein Modell?
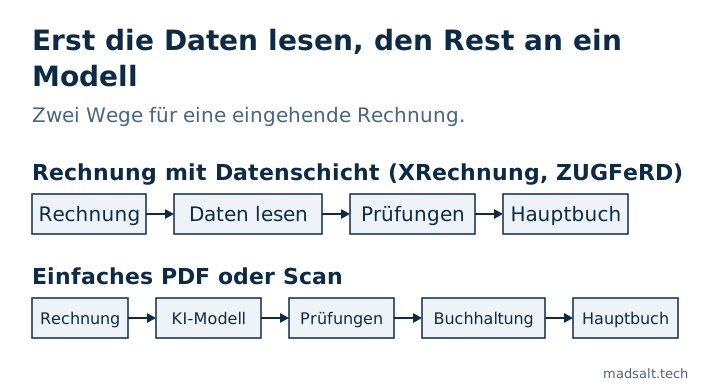
Oft nicht, und in manchen Ländern jedes Jahr weniger. Bevor Sie das Bild einer Rechnung an ein Modell schicken, prüfen Sie, ob die Daten schon in der Datei stehen:
- Deutschland. Seit dem 1. Januar 2025 gilt ein einfaches PDF zwischen deutschen Unternehmen nicht mehr als E-Rechnung. Papier- und PDF-Rechnungen sind während einer Übergangszeit erlaubt, die für alle Unternehmen Ende 2027 endet (FAQ des Bundesfinanzministeriums). XRechnung- und ZUGFeRD-Rechnungen enthalten strukturierte Daten, die Sie direkt lesen können.
- Portugal. Jede Rechnung aus zertifizierter Software muss einen QR-Code mit beiden NIFs, dem Datum, der Rechnungsnummer, dem ATCUD sowie der Bemessungsgrundlage und Umsatzsteuer je Satz tragen (Portaria n.º 195/2020, Spezifikation des QR-Codes der AT). Das Lesen des QR-Codes liefert die meisten Felder exakt.
- Tschechien. Viele Buchhaltungsprogramme betten eine ISDOC-Datenschicht in das PDF ein; Fakturoid hat sie seit Dezember 2022 in alle seine PDF-Rechnungen aufgenommen (Fakturoid).
Die Reihenfolge, die funktioniert, lautet also: die Datenschicht lesen, falls es eine gibt, nur den Rest an ein Modell schicken, dann die Prüfungen laufen lassen. Das Modell ist der Notanker, nicht der erste Schritt.
Wie kommen die Felder in Excel oder Ihre Buchhaltung?
Das Archiv weiter unten enthält bereits eine CSV mit allen Ergebnissen, eine Zeile je Auslesung, sie öffnet sich also direkt in Excel. Mein Prototyp zum Auslesen von Rechnungen arbeitet auf App-Ebene genauso: Er exportiert die freigegebenen Felder und bietet einen API-Aufruf, der ein PDF entgegennimmt und die Felder je Rechnung als JSON zurückgibt.
Von dort lässt sich eine CSV- oder XLSX-Datei in eine Buchhaltung importieren, die Dateiimporte akzeptiert, oder das JSON wird von einem kleinen Skript weitergereicht. Der Prototyp läuft mit Beispieldaten, und ich habe ihn an kein bestimmtes Buchhaltungsprodukt angebunden. Für einen Lauf von PDF nach Excel mit Positionen und einer Arbeitsmappe aus zwei Blättern siehe PDF-Rechnung in Excel: Wann Sie KI brauchen und wann nicht.
Wenn Sie noch klären, welcher Teil Ihres Unternehmens sich zu automatisieren lohnt, helfe ich Ihnen bei der Auswahl und baue ihn anschließend: siehe KI-Beratung für den Mittelstand. Kundennachrichten sind die andere häufige erste KI-Aufgabe in einem kleinen Unternehmen: was ein WhatsApp-Chatbot mit KI pro Antwort kostet, Metas Gebühr eingerechnet.
Was zeigt dieser Test nicht?
- Die Rechnungen sind fiktiv. Ein Layout je Land, von einem Skript erzeugt, mit Beispiel-Firmennamen. Echte Lieferantenrechnungen sind viel vielfältiger.
- Die Scans sind simuliert. Unschärfe, Drehung, Rauschen und JPEG-Kompression auf einer sauberen Darstellung, kein Papier im Scanner und kein Handyfoto.
- Ein Aufruf je Rechnung, ein Satz von 30. Die Ergebnisse schwanken zwischen Sätzen stark. Dieser Artikel lief zuerst mit einem anderen Satz von 30 Rechnungen, bei dem die Scan-Ergebnisse für Haiku, Sonnet und Gemini 22, 22 und 17 von 30 waren; bei diesem Satz sind es 14, 22 und 22. Pro Land wird eine USt-IdNr. des Käufers auf 10 Rechnungen wiederholt, eine falsch gelesene Zeichenfolge kann also bis zu 10 Rechnungen auf einmal treffen.
- Preise ändern sich. Die Kosten sind das, was OpenRouter am 22. Oktober 2026 abgerechnet hat.
- Nur neun Felder. Keine Positionen, IBANs oder Zahlungsbedingungen.
So wiederholen Sie den Test mit Ihren eigenen Rechnungen
- Wählen Sie 30 bis 50 echte Rechnungen, darunter die schlechtesten Scans, die bei Ihnen eingehen. Notieren Sie die wahren Werte von Hand.
- Nutzen Sie einen Prompt und ein festes Ausgabeschema mit einer Liste unsicherer Felder, bei Temperatur 0.
- Lassen Sie zwei oder drei Modelle laufen und halten Sie die abgerechneten Kosten je Aufruf fest, nicht den Listenpreis.
- Bewerten Sie ganze Rechnungen, nicht einzelne Felder: Eine falsche Ziffer in einer USt-IdNr. ist eine falsche Rechnung.
- Ergänzen Sie die Prüfziffer-Regel und die Regel der eigenen USt-IdNr. und messen Sie, was sie finden.
- Lesen Sie zuerst die Datenschicht, wo die Software Ihrer Lieferanten eine liefert.
Die Skripte, die erzeugten Rechnungen und alle Ergebnisse stehen in einem Archiv: der Generator, der Runner, die Auswertung und eine CSV mit allen 240 Auslesungen. Wenn Sie das in Ihren Kreditorenprozess einbauen lassen möchten, gehört es zur Workflow-Automatisierung.
Wenn Sie ein solches Auslesen in einen Prozess einbauen lassen möchten, den Sie bereits betreiben, übernehme ich das unter KI-Integration für bestehende Produkte.
Siehe auch: Dokumentenmanagement für kleine Unternehmen: DE und CH.
Mein ähnlicher Fall
Ich habe einen Service gebaut, der aus einer Immobilienbescheinigung, die 2–3 Wochen dauerte und EUR 200–300 kostete, eine macht, die 2–3 Minuten dauert und EUR 99 kostet, mit Skripten und Vision-KI. Der Bau steht in der Fallstudie zur Automatisierung von Immobiliendokumenten.
Rechnungsdaten von Hand oder mit einem Tool erfassen, dem Sie nicht trauen? Schreiben Sie mir, und wir finden die beste Lösung für Sie.
Rechnungsdaten noch von Hand tippen?
Schreiben Sie mir, was Sie jetzt haben und was Sie brauchen. Ich antworte mit der Option, die ich wählen würde.
Schreiben Sie mir