TL;DR
Při vytěžování faktur z čistých digitálních PDF přečetly tři ze čtyř testovaných modelů všech devět polí správně u 30 z 30 faktur. U simulovaných skenů týchž faktur zvládl nejlepší model 22 z 30. Chyby téměř nikdy nebyly v částkách. Byly v DIČ a číslech faktur a obvyklá pojistka, kontrola, že základ plus DPH dává celkovou částku, označila jen 3 z 63 chybných faktur. Dvě jednoduchá pravidla pro DIČ zachytila 31 z 32 chybných faktur od tří nejlepších modelů. Nejlevnější model stál USD 0,43 za 1 000 faktur, ale u skenů nevyrovnal model, který stál 17krát víc: 14 z 30 proti 22. Gemini 3.8 Flash vyrovnal 22 modelu Sonnet za zhruba poloviční cenu.
Tento test jsem zopakoval 22. října 2026 na nové sadě fiktivních faktur. Všechna čísla v tomto článku pocházejí z opakovaného běhu.
Jsem Denys, full-stack a AI inženýr. Začátkem roku jsem postavil prototyp vytěžování faktur: webovou aplikaci a API, které z PDF faktur dělají pole a nejisté položky označují pro člověka. Běží na ukázkových datech, bez modelu za ním. Než jsem o vytěžování faktur začal psát, provedl jsem proto skutečný test: 30 fiktivních českých, německých a portugalských dodavatelských faktur, čtyři modely, 240 volání, USD 0,76 vyúčtovaného provozu.
Co umí AI při vytěžování faktur správně a co špatně?
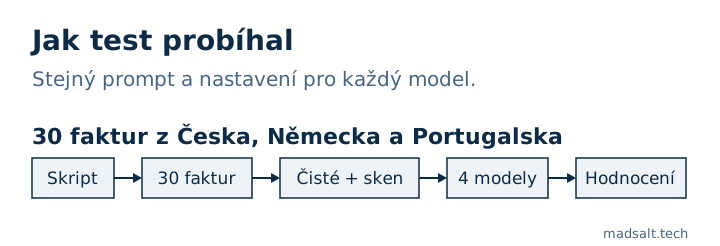
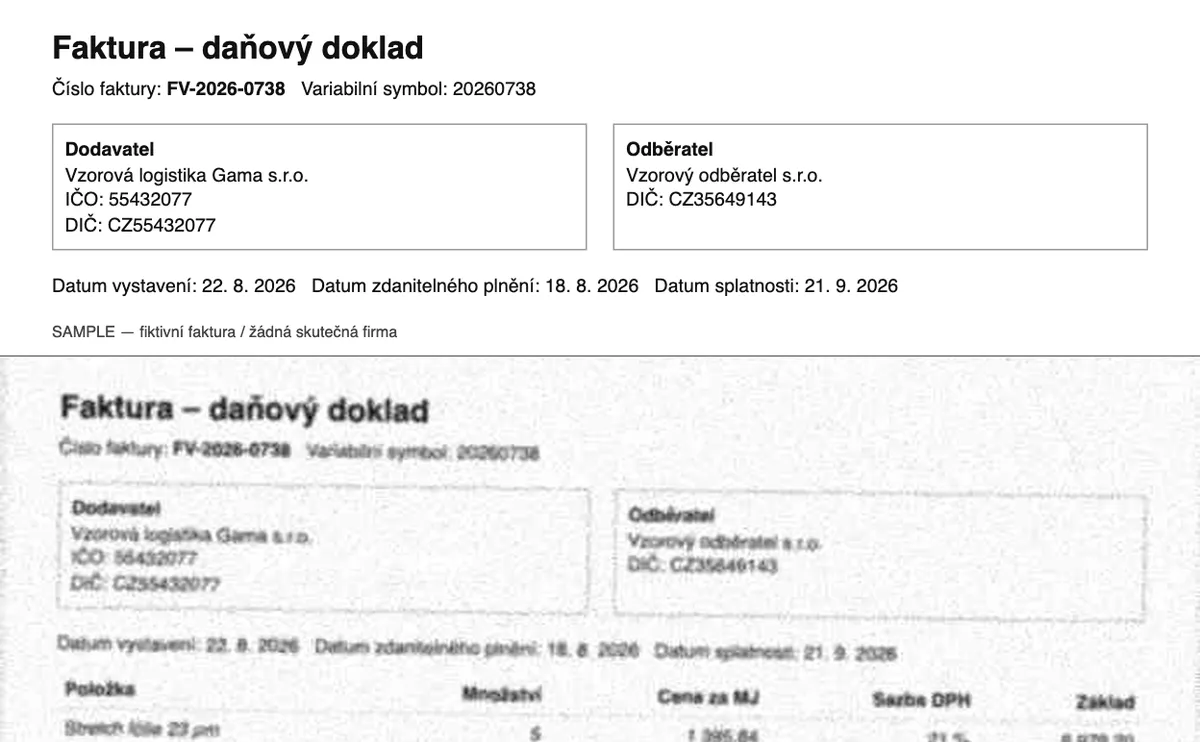
Každý model četl každou fakturu dvakrát: jako čistý výstup, tak jak vypadá PDF z účetního programu, a jako simulovaný sken, šedý, mírně pootočený, rozmazaný a komprimovaný. Faktura se počítá jako správná, jen když souhlasí všech devět polí: číslo faktury, datum vystavení, datum splatnosti, DIČ dodavatele, DIČ odběratele, měna, základ daně, DPH a celková částka.
| Model | Čistá, všech 9 polí správně | Sken, všech 9 polí správně | USD za 1 000 faktur | Medián sekund na fakturu |
|---|---|---|---|---|
| Claude Haiku 5.5 | 30 z 30 | 14 z 30 | 0,43 | 6,13 |
| Claude Sonnet 5.5 | 30 z 30 | 22 z 30 | 7,18 | 8,50 |
| Gemini 3.8 Flash | 30 z 30 | 22 z 30 | 3,51 | 8,43 |
| GPT-5.6 Luna | 29 z 30 | 0 z 30 | 1,52 | 10,85 |
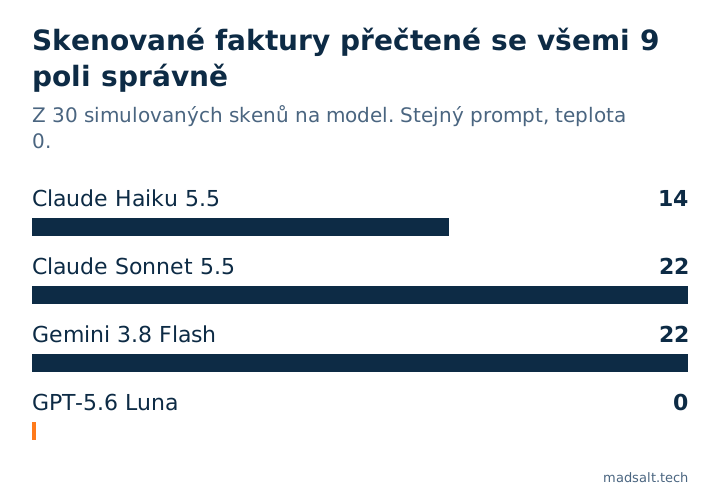
Cena je to, co za každé volání vyúčtoval OpenRouter, ne odhad podle ceníku. U čistých faktur byly Claude Haiku 5.5 a Claude Sonnet 5.5 stejně přesné, 30 z 30. U skenů Sonnet přečetl správně 22 proti 14 u Haiku a stál asi 17krát víc.
Potřebujete při vytěžování faktur ještě OCR?
V tomto testu ne jako samostatný krok. Všechny čtyři modely dostaly stránku jako obrázek a vrátily rovnou devět polí, bez jakékoli vrstvy OCR mezi tím. Výsledek mění kvalita stránky. Čisté PDF z účetního programu má textovou vrstvu, sken ji nemá: jsou to jen pixely. Sloupec „Sken“ v tabulce výše je přesně otázka kvality OCR a právě tam se modely liší: nejlepší přečetl správně 22 z 30 skenovaných faktur a nejhorší žádnou.
Klasické OCR nástroje ani nástroje založené na šablonách jsem netestoval, takže nevím, jak by dopadly na stejných 30 fakturách. Test ukazuje, kde je riziko, když model čte sken: v DIČ a v číslech faktur, které kontroly níže zachytí.
Jak byl test postaven?
Faktury jsem vygeneroval skriptem, takže každá pravdivá hodnota je známa na halíř. Faktury jsou fiktivní: názvy firem nesou slova Vzor, Muster, Beispiel nebo Exemplo a každá faktura má v zápatí text v místním jazyce, který zní „SAMPLE - fictitious invoice / no real company“. Každá obsahuje pasti, na které v dané zemi narazí skutečná účetní zpracovávající přijaté faktury:
- Místní formáty čísel.
175 011,84 Kčv češtině,10.465,61 €v němčině a na portugalských fakturách jak1 234,56, tak1.234,56. - Druhý identifikátor vedle čísla faktury. Český variabilní symbol, německé číslo zákazníka, portugalský kód ATCUD.
- Druhé datum. České datum uskutečnění zdanitelného plnění a německé datum plnění stojí vedle data vystavení.
- Dvě DIČ na jedné stránce, plus německé daňové číslo (Steuernummer), které vypadá jako DIČ, a není.
- Těžké případy. Smíšené sazby DPH, faktura bez DPH, faktura v režimu přenesené daňové povinnosti, dobropis se zápornými částkami a devítiřádková faktura v každé zemi.
Každé DIČ má platnou kontrolní číslici, ověřenou knihovnou python-stdnum, a žádné z nich není registrováno: každé z 33 použitých ID (30 ID dodavatelů a jedno ID odběratele na zemi) jsem vyhledal ve službě VIES Evropské unie a u všech odpověděla „neplatné“. Také 11 českých čísel firem za českými DIČ jsem vyhledal v českém registru ekonomických subjektů ARES a nenašel jsem je. Všechny čtyři modely dostaly stejný prompt při teplotě 0, jedno volání na obrázek.
Proč kontrola součtů nezachytila téměř nic?
Kontrola, že základ plus DPH dává celkovou částku, je první pravidlo, které většina vytěžovacích řetězců přidá, a to, které používá můj prototyp. V tomto testu označila 3 ze 63 chybných faktur napříč čtyřmi modely: jeden sken modelu Gemini 3.8 Flash (cz06, špatná celková částka), jeden sken modelu GPT-5.6 Luna (cz08, kde bylo špatně datum vystavení, DIČ odběratele, základ a DPH) a jednu čistou fakturu modelu Luna (pt02, špatný základ daně).
Důvod je v tom, kde chyby byly. Claude Haiku 5.5, Claude Sonnet 5.5 a Gemini 3.8 Flash udělaly dohromady 32 chybných vytěžení a jen dvě měla špatnou částku: sken Gemini výše a sken Haiku (cz09), kde byly základ a DPH mírně mimo, ale základ plus DPH se stále rovnal celkové částce, takže kontrola mlčela. Ostatní přečetly špatně číslici v DIČ nebo v čísle faktury, například FV-2026-0738 přečtené jako FV-2026-0758. GPT-5.6 Luna udělala chyby v částkách u 7 faktur, ale u 5 z nich se základ, DPH a celková částka stále shodovaly. Model přečte celkovou částku, která je v souladu se zbytkem toho, co přečetl, takže aritmetická kontrola většinu jeho chyb přejde.
Které kontroly chyby zachytí?
Dvě pravidla pro DIČ, obě pár řádků kódu:
- Kontrolní číslice. DIČ končí kontrolní číslicí vypočtenou z ostatních číslic: modulo 11 pro české IČO za DIČ a pro portugalské NIF, ISO 7064 pro německé USt-IdNr. Knihovny jako python-stdnum implementují všechna tři. Špatně přečtená číslice ji téměř vždy rozbije.
- Vaše vlastní DIČ. Na přijaté faktuře jste odběratel vy. Každé DIČ odběratele, které není vaše, je chybné, nebo faktura nebyla určena vám.
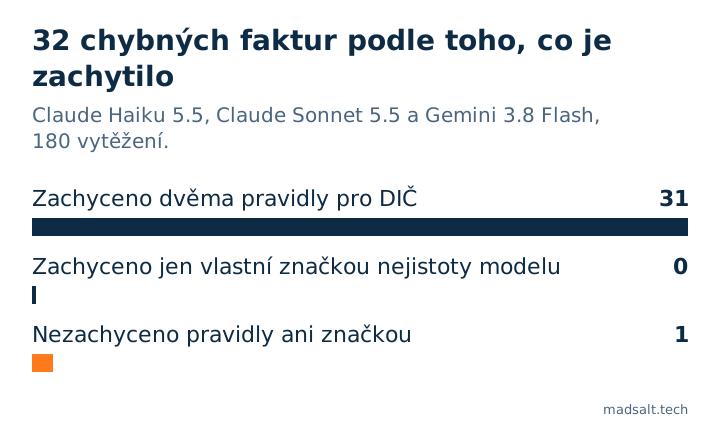
Zbývající jedna, sken Gemini cz06, měla špatnou celkovou částku. Žádné pravidlo pro DIČ to nevidí a Gemini nikdy neuvádí nejistá pole, takže to zachytila jen kontrola součtů. Každý model jsem požádal o seznam polí, u kterých si není jistý:
| Model | Chybné faktury | Zachyceno dvěma pravidly | Zachyceno jen značkou nejistoty | Nezachyceno | Správné faktury, které přesto označil |
|---|---|---|---|---|---|
| Claude Haiku 5.5 | 16 | 16 | 0 | 0 | 13 z 44 |
| Claude Sonnet 5.5 | 8 | 8 | 0 | 0 | 19 z 52 |
| Gemini 3.8 Flash | 8 | 7 | 0 | 1 | 0 z 52 |
| GPT-5.6 Luna | 31 | 30 | 0 | 1 | 0 z 29 |
Gemini 3.8 Flash nikdy neuvedl žádné pole jako nejisté, takže u něj zbývají jen kontroly; tady obě pravidla zachytila 7 z jeho 8 chybných faktur a kontrola součtů osmou. Modely Claude označovaly spíš příliš než málo: Haiku označil 13 ze svých 44 správných faktur (30 %) a Sonnet 19 z 52 (37 %), všechny to byly skeny; ani jeden neoznačil jedinou čistou fakturu. To je výměna, kterou u přijatých faktur chcete, protože pohled účetní stojí méně než chybná platba.
Objevily se ještě dvě věci. Chyby GPT-5.6 Luna se neomezovaly na identifikátory: z jejích 31 chybných faktur bylo 30 skenů, 20 mělo špatné číslo faktury, 13 špatné datum vystavení a 15 špatné datum splatnosti a u 7 faktur bylo špatně 15 polí s částkami. Její jediná faktura ve sloupci „Nezachyceno“ je čistá, pt02, se špatným základem daně: dvě pravidla ani její značka nejistoty ji minuly, kontrola součtů ne. A kontrolní číslice nezachytí každé chybné přečtení, protože některá chybná čísla jsou také platná; v tomto běhu neprošlo obě pravidla žádné chybné DIČ.
Který model použít pro vytěžování faktur?
Na této sadě vyšly výsledky skenů takto: Claude Sonnet 5.5 22 z 30 s 8 chybnými fakturami za USD 7,18 za 1 000; Gemini 3.8 Flash také 22 z 30 s 8 chybnými fakturami za USD 3,51, tedy zhruba za polovinu; Claude Haiku 5.5 14 z 30 s 16 chybnými za USD 0,43. Gemini se přesností vyrovnal modelu Sonnet za zhruba poloviční cenu, ale nikdy neuvádí nejistá pole: jeho chybné faktury zachytila dvě pravidla pro DIČ (7) a kontrola součtů (1), zatímco Sonnet navíc označil 19 ze svých 52 správných faktur. Při použití kontrol nezůstala bez povšimnutí žádná chybná faktura modelů Haiku ani Sonnet, takže nejlevnější model znamená víc chybných faktur k opravě (16 proti 8), ne víc chyb v účetnictví. Pokud posíláte každou fakturu modelu, model je zřídka velká nákladová položka; cena AI agenta funguje stejně. GPT-5.6 Luna je v tomto testu u skenů nepoužitelná.
Toto pořadí vychází z jednoho testu na 30 fakturách. Než si vyberete, nechte projít své vlastní faktury dvěma nebo třemi modely.
Potřebujete vůbec model?
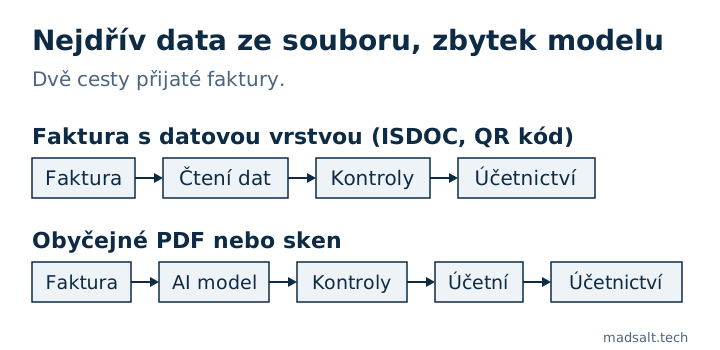
Často ne, a v některých zemích každým rokem méně. Než pošlete obrázek faktury modelu, zjistěte, zda data už nejsou v souboru:
- Česko. Mnoho účetních programů vkládá do PDF datovou vrstvu ISDOC; Fakturoid ji přidává do všech svých PDF faktur od prosince 2022 (Fakturoid).
- Portugalsko. Každá faktura z certifikovaného softwaru musí nést QR kód s oběma NIF, datem, číslem faktury, ATCUD a základem daně a DPH podle sazby (Portaria n.º 195/2020, specifikace QR kódu AT). Přečtením QR kódu získáte většinu polí přesně.
- Německo. Od 1. ledna 2025 už prosté PDF mezi německými firmami není elektronickou fakturou. Papírové a PDF faktury jsou povoleny během přechodného období, které pro všechny firmy končí na konci roku 2027 (FAQ spolkového ministerstva financí). Faktury XRechnung a ZUGFeRD nesou strukturovaná data, která můžete číst přímo.
Funguje tedy tento postup: přečíst datovou vrstvu, pokud existuje, poslat modelu jen zbytek a pak spustit kontroly. Model je záloha, ne první krok.
Jak se pole dostanou do Excelu nebo do účetního systému?
Archiv odkazovaný níže už obsahuje CSV se všemi výsledky, jeden řádek na vytěžení, takže výstup se v Excelu otevře tak, jak je. Můj prototyp vytěžování faktur funguje stejně na úrovni aplikace: exportuje schválená pole a nabízí jedno API volání, které přijme PDF a vrátí pole jako JSON pro každou fakturu.
Odtud lze soubor CSV nebo XLSX naimportovat do účetního systému, který import souborů podporuje, nebo lze JSON předat malým skriptem. Prototyp běží na ukázkových datech a s žádným konkrétním účetním produktem jsem ho nepropojil. Převod z PDF do Excelu včetně řádkových položek a sešitu o dvou listech najdete v článku Převod PDF faktury do Excelu: kdy je potřeba AI a kdy ne.
Pokud ještě zvažujete, kterou část firmy se vyplatí automatizovat, pomohu ji vybrat a pak ji postavím: viz AI konzultant pro malé firmy. Zprávy od zákazníků jsou druhá častá první práce pro AI v malé firmě: kolik stojí WhatsApp chatbot s AI za odpověď, včetně poplatku Meta.
Co tento test neprokazuje?
- Faktury jsou fiktivní. Jedno rozvržení na zemi, vygenerované skriptem, s ukázkovými názvy firem. Skutečné dodavatelské faktury se liší mnohem víc.
- Skeny jsou simulované. Rozmazání, pootočení, šum a JPEG komprese na čistém výstupu, ne papír ve skeneru ani fotka z mobilu.
- Jedno volání na fakturu, jedna sada 30. Výsledky se mezi sadami hodně liší. Tento článek poprvé běžel na jiné sadě 30 faktur, kde byly výsledky skenů pro Haiku, Sonnet a Gemini 22, 22 a 17 z 30; na této sadě jsou 14, 22 a 22. V každé zemi se jedno DIČ odběratele opakuje na 10 fakturách, takže jeden špatně přečtený řetězec může rozbít až 10 faktur najednou.
- Ceny se mění. Náklady jsou to, co OpenRouter vyúčtoval 22. října 2026.
- Jen devět polí. Žádné řádkové položky, IBAN ani platební podmínky.
Jak test zopakovat na vlastních fakturách
- Vyberte 30 až 50 skutečných faktur včetně nejhorších skenů, které dostáváte. Pravdivé hodnoty si zapište ručně.
- Použijte jeden prompt a pevné výstupní schéma se seznamem nejistých polí, při teplotě 0.
- Spusťte dva nebo tři modely a zaznamenejte vyúčtovanou cenu za volání, ne ceníkovou.
- Hodnoťte celé faktury, ne jednotlivá pole: jedna špatná číslice v DIČ je chybná faktura.
- Přidejte pravidlo kontrolní číslice a pravidlo vlastního DIČ a změřte, co zachytí.
- Kde software vašich dodavatelů datovou vrstvu poskytuje, čtěte nejdřív ji.
Skripty, vygenerované faktury i všechny výsledky jsou v jednom archivu: generátor, spouštěč, vyhodnocení a CSV se všemi 240 vytěženími. Pokud chcete něco takového zabudovat do zpracování přijatých faktur, je to součást automatizace workflow.
Pokud chcete takové čtení faktur přidat do procesu, který už provozujete, řeším to v rámci služby Integrace AI do existujících produktů.
Viz také: Systém pro správu dokumentů pro malou firmu: ceny a limity.
Můj podobný případ
Postavil jsem službu, která z potvrzení o nemovitosti, na které se čekalo 2–3 týdny a stálo EUR 200–300, udělá potvrzení za 2–3 minuty a EUR 99, se skripty a vision AI. Stavba je v případové studii automatizace dokumentů k nemovitostem.
Zadáváte data z faktur ručně nebo nástrojem, kterému nevěříte? Napište mi a společně vybereme nejlepší možnost.
Pořád přepisujete data z faktur ručně?
Napište mi, co máte teď a co potřebujete. Odpovím variantou, kterou bych zvolil já.
Napište mi