Em resumo
Na extração de dados de faturas digitais limpas, três dos quatro modelos que testei leram os nove campos certos em 30 de 30. Em scans simulados das mesmas faturas, o melhor acertou 22 de 30. Os erros quase nunca estavam nos valores. Estavam nos números de IVA e nos números das faturas, e a rede de segurança habitual, verificar se líquido mais IVA é igual ao total, assinalou apenas 3 das 63 faturas erradas. Duas regras simples sobre os números de IVA apanharam 31 das 32 faturas erradas dos três melhores modelos. O modelo mais barato custou USD 0,43 por 1.000 faturas, mas nos scans não igualava o modelo 17 vezes mais caro: 14 de 30 contra 22. O Gemini 3.8 Flash igualou os 22 do Sonnet por cerca de metade do preço.
Repeti este teste a 22 de outubro de 2026 com um conjunto novo de faturas fictícias. Todos os números deste artigo vêm da nova execução.
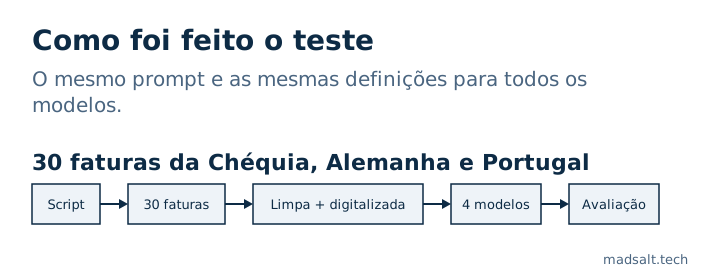
Sou o Denys, engenheiro full-stack e de IA. No início do ano construí um protótipo de extração de faturas: uma aplicação web e uma API que transformam faturas em PDF em campos, com os campos duvidosos assinalados para uma pessoa. Corre com dados de exemplo, sem nenhum modelo por trás. Por isso, antes de escrever sobre extração de dados de faturas, fiz um teste a sério: 30 faturas fictícias de fornecedores checos, alemães e portugueses, quatro modelos, 240 chamadas, USD 0,76 de consumo faturado.
O que a IA acerta e falha na extração de dados de faturas?
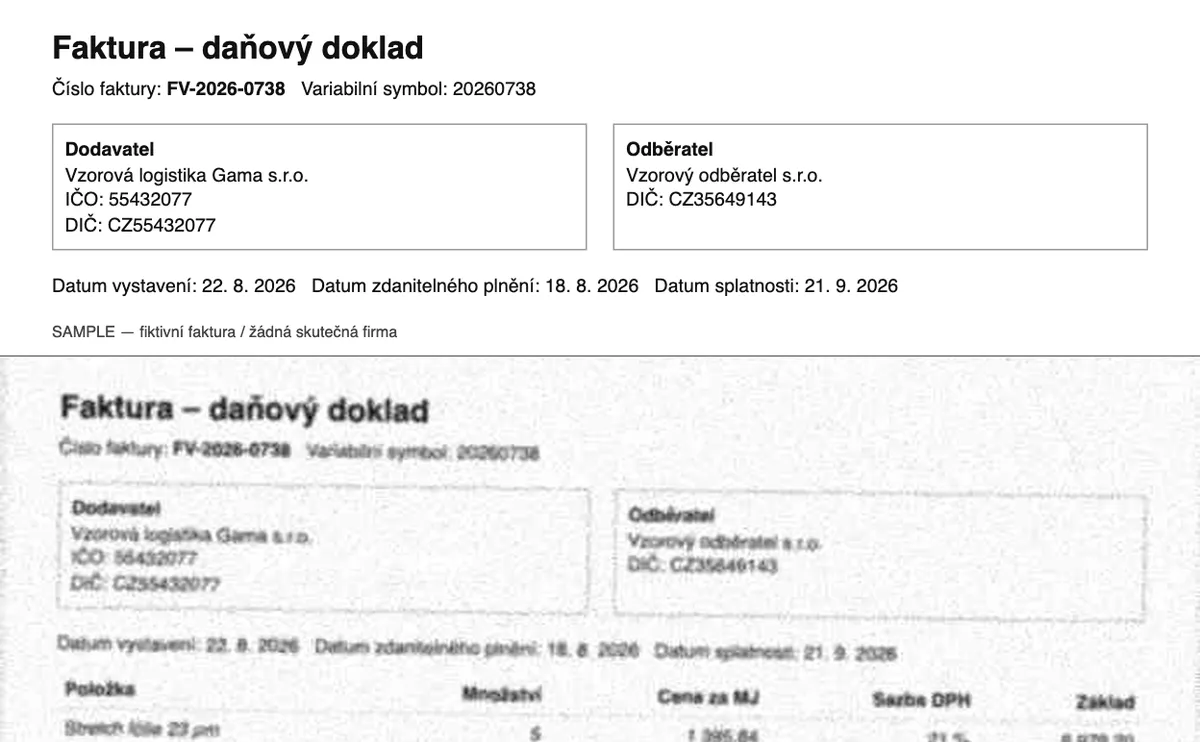
Cada modelo leu cada fatura duas vezes: numa versão limpa, como é um PDF saído do software de contabilidade, e num scan simulado, cinzento, ligeiramente rodado, desfocado e comprimido. Uma fatura só conta como certa quando os nove campos coincidem: número da fatura, data de emissão, data de vencimento, número de IVA do fornecedor, número de IVA do comprador, moeda, total líquido, total do IVA e total bruto.
| Modelo | Limpa, 9 campos certos | Scan, 9 campos certos | USD por 1.000 faturas | Segundos por fatura (mediana) |
|---|---|---|---|---|
| Claude Haiku 5.5 | 30 de 30 | 14 de 30 | 0,43 | 6,13 |
| Claude Sonnet 5.5 | 30 de 30 | 22 de 30 | 7,18 | 8,50 |
| Gemini 3.8 Flash | 30 de 30 | 22 de 30 | 3,51 | 8,43 |
| GPT-5.6 Luna | 29 de 30 | 0 de 30 | 1,52 | 10,85 |
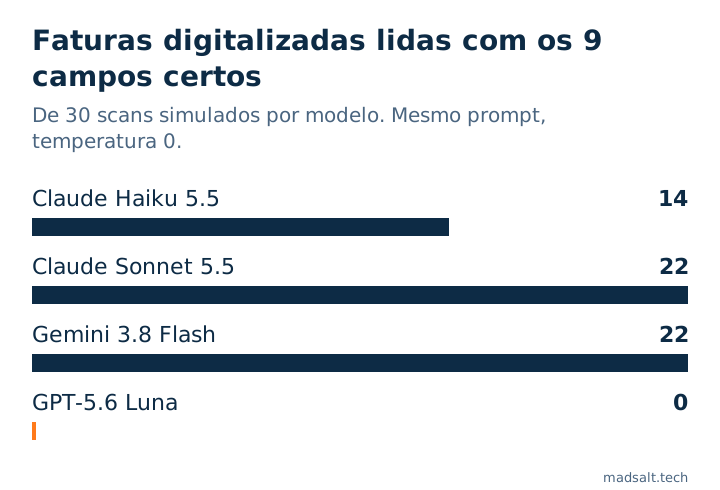
O custo é o que a OpenRouter faturou por cada chamada, não uma estimativa a partir da lista de preços. Nas faturas limpas, o Claude Haiku 5.5 e o Claude Sonnet 5.5 acertaram o mesmo, 30 de 30. Nos scans o Sonnet leu bem 22 contra 14 do Haiku, e custou cerca de 17 vezes mais.
Ainda é preciso OCR para extrair os dados de uma fatura?
Não como passo separado, neste teste. Os quatro modelos receberam a página como imagem e devolveram diretamente os nove campos, sem nenhuma camada de OCR pelo meio. O que muda o resultado é a qualidade da página. Um PDF limpo de um software de contabilidade tem camada de texto; um scan não tem: são só píxeis. A coluna “Scan” da tabela acima é exatamente a questão da qualidade do OCR, e é onde os modelos se distinguem: o melhor leu bem 22 de 30 faturas digitalizadas e o pior, nenhuma.
Não testei motores de OCR clássicos nem ferramentas baseadas em modelos de documento, por isso não sei que resultado teriam com as mesmas 30 faturas. O que o teste mostra é onde está o risco quando um modelo lê um scan: nos números de IVA e nos números das faturas, que as verificações abaixo apanham.
Como foi montado o teste?
Gerei as faturas com um script, por isso cada valor verdadeiro é conhecido ao cêntimo. As faturas são fictícias: os nomes das empresas trazem Vzor, Muster, Beispiel ou Exemplo, e cada fatura tem um rodapé na língua local com o texto “SAMPLE - fictitious invoice / no real company”. Cada uma traz as armadilhas que um funcionário de contas a pagar encontra em cada país:
- Formatos numéricos locais.
175 011,84 Kčem checo,10.465,61 €em alemão, e tanto1 234,56como1.234,56nas faturas portuguesas. - Um segundo identificador junto ao número da fatura. O símbolo variável checo, o número de cliente alemão, o código ATCUD português.
- Uma segunda data. A data de prestação do serviço, checa e alemã, está ao lado da data de emissão.
- Dois números de IVA na mesma página, e um número fiscal alemão (Steuernummer) que parece um número de IVA e não é.
- Casos difíceis. Taxas de IVA mistas, uma fatura sem IVA, uma fatura com autoliquidação, uma nota de crédito com valores negativos e uma fatura de nove linhas em cada país.
Todos os números de IVA têm um dígito de controlo válido, verificado com a biblioteca python-stdnum, e nenhum está registado: procurei cada um dos 33 números usados (30 de fornecedores e um de comprador por país) no serviço VIES da UE, que respondeu “não válido” para todos. Os 11 números de empresa checos por trás dos números de IVA checos também foram procurados no registo comercial checo, o ARES, e não foram encontrados. Os quatro modelos receberam o mesmo prompt, à temperatura 0, uma chamada por imagem.
Porque é que a verificação dos totais quase não apanhou nada?
Verificar se líquido mais IVA é igual ao total bruto é a primeira regra que a maioria das pipelines de extração acrescenta, e a que o meu protótipo usa. Neste teste assinalou 3 das 63 faturas erradas nos quatro modelos: um scan do Gemini 3.8 Flash (cz06, total bruto errado), um scan do GPT-5.6 Luna (cz08, em que a data de emissão, o número de IVA do comprador, o líquido e o IVA estavam errados) e uma fatura limpa do Luna (pt02, total líquido errado).
A razão está em onde estavam os erros. O Claude Haiku 5.5, o Claude Sonnet 5.5 e o Gemini 3.8 Flash fizeram 32 extrações erradas entre os três, e só duas tinham um valor errado: o scan do Gemini acima e um scan do Haiku (cz09) em que os totais líquido e de IVA estavam ligeiramente errados mas líquido mais IVA continuava igual ao bruto, pelo que a verificação ficou em silêncio. As restantes leram mal um dígito de um número de IVA ou de um número de fatura, como FV-2026-0738 lido como FV-2026-0758. O GPT-5.6 Luna errou mesmo valores em 7 faturas, e em 5 delas o líquido, o IVA e o bruto continuavam a somar. Um modelo lê um total coerente com o resto do que leu, por isso uma verificação aritmética deixa passar a maior parte dos seus erros.
Que verificações apanham os erros?
Duas regras sobre os números de IVA, ambas com poucas linhas de código:
- O dígito de controlo. Um número de IVA termina num dígito de controlo calculado a partir dos outros dígitos: módulo 11 para o número da empresa checa por trás de um DIČ e para o NIF português, ISO 7064 para o USt-IdNr alemão. Bibliotecas como a python-stdnum implementam as três. Um dígito mal lido quase sempre o quebra.
- O seu próprio número de IVA. Numa fatura recebida, o comprador é você. Qualquer número de IVA do comprador que não seja o seu está errado, ou a fatura não era para si.
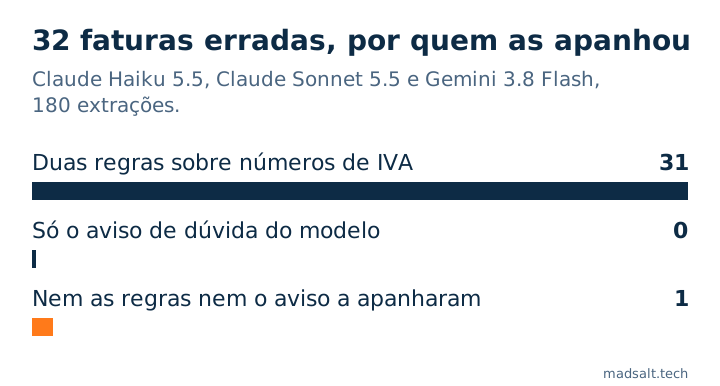
A que sobrou, o scan cz06 do Gemini, tinha um total bruto errado. Nenhuma regra sobre números de IVA o vê, e o Gemini nunca indica campos duvidosos, por isso só a verificação dos totais o apanhou. Pedi a cada modelo que listasse os campos de que não tinha certeza:
| Modelo | Faturas erradas | Apanhadas pelas duas regras | Apanhadas só pelo aviso de dúvida | Não apanhadas | Faturas certas que assinalou na mesma |
|---|---|---|---|---|---|
| Claude Haiku 5.5 | 16 | 16 | 0 | 0 | 13 de 44 |
| Claude Sonnet 5.5 | 8 | 8 | 0 | 0 | 19 de 52 |
| Gemini 3.8 Flash | 8 | 7 | 0 | 1 | 0 de 52 |
| GPT-5.6 Luna | 31 | 30 | 0 | 1 | 0 de 29 |
O Gemini 3.8 Flash nunca indicou um campo como duvidoso, pelo que com ele as verificações são tudo o que tem; aqui as duas regras apanharam 7 das suas 8 faturas erradas e a verificação dos totais a oitava. Os modelos Claude assinalaram de mais, não de menos: o Haiku assinalou 13 das suas 44 faturas certas (30 %) e o Sonnet 19 de 52 (37 %), todas scans; nenhum assinalou uma única fatura limpa. É a troca que se quer nas contas a pagar, onde um olhar de um funcionário custa menos do que um pagamento errado.
Apareceram mais duas coisas. Os erros do GPT-5.6 Luna não se limitaram a identificadores: das suas 31 faturas erradas, 30 eram scans, 20 tinham o número da fatura errado, 13 a data de emissão errada e 15 a data de vencimento errada, e 15 campos de valores estavam errados em 7 faturas. A sua única fatura na coluna “não apanhadas” é uma limpa, a pt02, com o total líquido errado: as duas regras e o seu aviso de dúvida falharam, a verificação dos totais não. E um dígito de controlo não apanha todas as leituras erradas, porque alguns números errados também são válidos; nesta execução, nenhum número de IVA errado passou nas duas regras.
Que modelo usar para a extração de dados de faturas?
Neste conjunto, os resultados nos scans foram: Claude Sonnet 5.5 22 de 30 com 8 faturas erradas a USD 7,18 por 1.000; Gemini 3.8 Flash também 22 de 30 com 8 faturas erradas a USD 3,51, cerca de metade do preço; Claude Haiku 5.5 14 de 30 com 16 erradas a USD 0,43. O Gemini igualou o Sonnet na exatidão por cerca de metade do preço, mas nunca indica campos duvidosos: as suas faturas erradas foram apanhadas pelas duas regras sobre os números de IVA (7) e pela verificação dos totais (1), enquanto o Sonnet assinalou também 19 das suas 52 faturas certas. Com as verificações em funcionamento, nenhuma das faturas erradas do Haiku ou do Sonnet ficou em silêncio, por isso o modelo mais barato significa mais faturas erradas para corrigir (16 contra 8), não mais erros na contabilidade. Se envia cada fatura a um modelo, o modelo raramente é o grande custo; o custo de um agente de IA funciona da mesma maneira. O GPT-5.6 Luna não serve para scans neste teste.
Esta classificação é um teste em 30 faturas. Passe as suas próprias faturas por dois ou três modelos antes de escolher.
Precisa mesmo de um modelo?
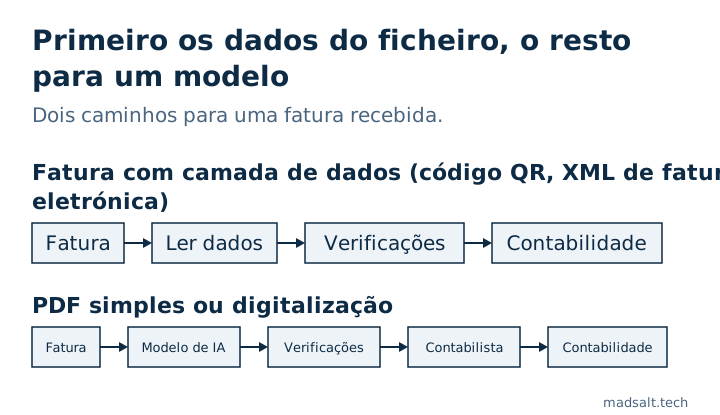
Muitas vezes não, e em alguns países cada ano menos. Antes de enviar a imagem de uma fatura a um modelo, veja se os dados já estão no ficheiro:
- Portugal. Toda a fatura de software certificado tem de levar um código QR com os dois NIF, a data, o número da fatura, o ATCUD e a base tributável e o IVA por taxa (Portaria n.º 195/2020, especificação técnica do código QR da AT). Ler o código QR dá-lhe a maioria dos campos com exatidão.
- Alemanha. Desde 1 de janeiro de 2025, um PDF simples já não conta como fatura eletrónica entre empresas alemãs. As faturas em papel e em PDF são permitidas durante um período de transição, que termina para todas as empresas no fim de 2027 (FAQ do Ministério Federal das Finanças). As faturas XRechnung e ZUGFeRD trazem dados estruturados que pode ler diretamente.
- Chéquia. Muitas ferramentas de contabilidade incorporam uma camada de dados ISDOC dentro do PDF; a Fakturoid acrescenta-a a todas as suas faturas em PDF desde dezembro de 2022 (Fakturoid).
A ordem que funciona é, portanto: ler a camada de dados, se existir, enviar só o resto a um modelo e depois correr as verificações. O modelo é o recurso de reserva, não o primeiro passo.
Como chegam os campos ao Excel ou ao programa de contabilidade?
O arquivo ligado mais abaixo já traz um CSV com todos os resultados, uma linha por extração, pelo que o resultado abre no Excel tal como está. O meu protótipo de extração de faturas funciona da mesma forma ao nível da aplicação: exporta os campos aprovados e expõe uma chamada de API que recebe um PDF e devolve os campos em JSON para cada fatura.
A partir daí, um ficheiro CSV ou XLSX pode ser importado num programa de contabilidade que aceite importação de ficheiros, ou o JSON pode ser encaminhado por um pequeno script. O protótipo corre com dados de exemplo e não o liguei a nenhum produto de contabilidade em concreto. Para uma conversão de PDF para Excel com linhas de artigos e um ficheiro de duas folhas, veja Converter fatura PDF em Excel: precisa de IA ou não?.
Se ainda está a decidir que parte da sua empresa vale a pena automatizar, ajudo a escolhê-la e depois construo-a: veja Consultoria de IA para PME. As mensagens de clientes são o outro primeiro trabalho comum da IA numa pequena empresa: quanto custa um chatbot WhatsApp com IA por resposta, com a taxa da Meta incluída.
O que este teste não prova?
- As faturas são fictícias. Um modelo de página por país, gerado por um script, com nomes de empresas de exemplo. As faturas reais de fornecedores variam muito mais.
- Os scans são simulados. Desfoque, rotação, ruído e compressão JPEG sobre uma versão limpa, não papel passado num scanner nem uma fotografia de telemóvel.
- Uma chamada por fatura, um conjunto de 30. Os resultados variam muito entre conjuntos. Este artigo correu primeiro noutro conjunto de 30 faturas, em que os resultados nos scans para Haiku, Sonnet e Gemini foram 22, 22 e 17 de 30; neste conjunto são 14, 22 e 22. Cada país tem um número de IVA de comprador repetido em 10 faturas, por isso uma sequência de dígitos mal lida pode estragar até 10 faturas de uma vez.
- Os preços mudam. Os custos são os que a OpenRouter faturou a 22 de outubro de 2026.
- Só nove campos. Sem linhas de artigos, IBAN nem condições de pagamento.
Como repetir o teste com as suas faturas
- Escolha 30 a 50 faturas reais, incluindo os piores scans que recebe. Anote à mão os valores verdadeiros.
- Use um só prompt e um esquema de saída fixo com uma lista de campos duvidosos, à temperatura 0.
- Corra dois ou três modelos e registe o custo faturado por chamada, não o preço de lista.
- Pontue faturas inteiras, não campos soltos: um dígito errado num número de IVA é uma fatura errada.
- Acrescente a regra do dígito de controlo e a regra do seu próprio número de IVA, e meça o que apanham.
- Leia primeiro a camada de dados sempre que o software dos seus fornecedores a ofereça.
Os scripts, as faturas geradas e todos os resultados estão num só arquivo: o gerador, o executor, o avaliador e um CSV com as 240 extrações. Se quer isto integrado no seu processo de contas a pagar, faz parte da automatização de fluxos de trabalho.
Se quer acrescentar uma extração destas a um processo que já tem em funcionamento, faço-o em Integração de IA em Produtos Existentes.
Ver também: Software de gestão documental para PME: 5 opções.
O meu caso semelhante
Construí um serviço que transforma uma certidão de imóvel que demorava 2–3 semanas e custava EUR 200–300 numa que demora 2–3 minutos e custa EUR 99, com scripts e IA de visão. A construção está no caso da automatização de documentos imobiliários.
Extrai dados de faturas à mão ou com uma ferramenta em que não confia? Escreva-me e encontramos a melhor opção para si.
Ainda digita à mão os dados das faturas?
Diga-me o que tem agora e o que precisa. Respondo com a opção que eu escolheria.
Fale comigo