TL;DR
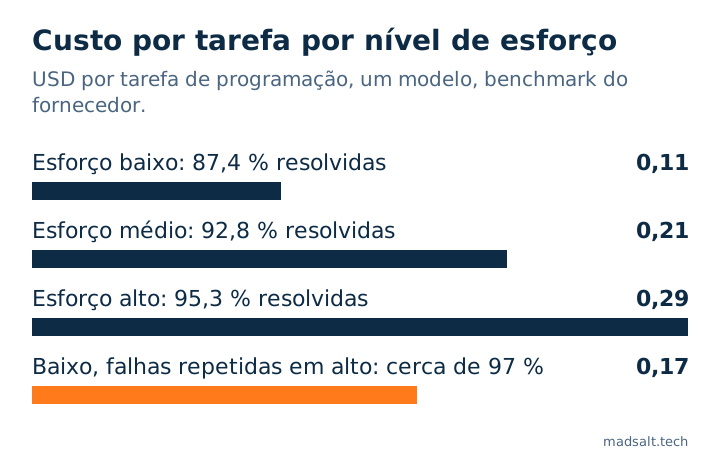
Para reduzir custos de IA, deixe de pagar o preço do melhor modelo em cada passo. Baixe primeiro o nível de esforço: no teste da Anthropic, um modelo resolveu 87,4 % das tarefas de programação com esforço baixo por USD 0,11 cada, contra 95,3 % com esforço alto por USD 0,29. Correr tudo em baixo e repetir em alto só as falhas deu cerca de 97 % por cerca de USD 0,17. Depois: guarde em cache os prompts repetidos, envie em lote o que pode esperar (50 % de desconto), dê os passos simples a modelos gratuitos ou baratos e deixe ao modelo forte a decisão.
Sou o Denys, engenheiro full-stack e de IA. Construo agentes de IA e automações para pequenas empresas. Esta é a lista que uso. É para o gerente que vê crescer uma linha de IA na fatura e quer saber que alavancas a fazem mexer. Os números são dados dos fornecedores de novembro de 2026, com a ligação onde aparecem; os números de benchmark da Anthropic vêm dos seus próprios testes internos. Todos os preços estão em USD, tal como os fornecedores os publicam.
Reduzir custos de IA: de onde vem a fatura?
Dos tokens, os pedaços de texto que um modelo lê e escreve. Escrever custa mais do que ler: na tabela de preços da Anthropic, um modelo forte cobra USD 4 por milhão de tokens lidos e USD 20 por milhão escritos, e o seu modelo mais pequeno USD 0,10 e 0,50 (preços da Anthropic). Para saber quanto custa uma IA, é preciso olhar para três coisas: que modelo chama, quanto pensa e escreve, e quantas vezes lhe volta a enviar o mesmo texto longo. Cada forma abaixo corta uma destas três parcelas.
| Forma | O que corta | Poupança típica (números dos fornecedores) |
|---|---|---|
| 1. Baixar o nível de esforço | pensar e escrever | medium custa 30–52 % menos do que high |
| 2. Primeiro low, repetir as falhas em high | pensar em tarefas fáceis | cerca de 40 % menos do que tudo em high |
| 3. Modelos gratuitos para passos simples | preço por token | USD 0 dentro dos limites diários |
| 4. O modelo forte decide, os baratos trabalham | preço por token | cerca de um terço, só em trabalhos grandes |
| 5. Cache de prompts | reler o mesmo texto | leitura de cache a 5–10 % do preço de entrada |
| 6. Lotes para o que pode esperar | tudo | 50 % de desconto |
| 7. Enviar menos | leitura | 21–26 % num agente pequeno |
| 8. Pedir respostas mais curtas | escrita | cerca de 13 % |
| 9. Licenças contra API | licenças por usar | depende do uso |
1. Baixar o nível de esforço
A maioria dos modelos atuais tem uma definição de esforço ou de raciocínio, e é a maior alavanca individual a seguir ao próprio modelo. Os níveis da Anthropic são low, medium, high, xhigh e max, e o esforço altera todos os tokens da resposta, incluindo chamadas a ferramentas e o raciocínio (documentação da Anthropic sobre esforço).
O teste publicado pela Anthropic com o Claude Opus 5.5 (um subconjunto do SWE-bench Pro, benchmark próprio) (guia de custo e inteligência):
| Esforço | Tarefas resolvidas | Custo por tarefa |
|---|---|---|
| low | 87,4 % | USD 0,11 |
| medium (por omissão) | 92,8 % | USD 0,21 |
| high | 95,3 % | USD 0,29 |
O mesmo guia diz que medium custou cerca de 30 % a 52 % menos do que high em tarefas longas de programação, e low cerca de dois terços menos. Os modelos da OpenAI têm o mesmo interruptor (reasoning.effort, de low a max) e a OpenAI refere que os tokens de raciocínio são faturados como saída, mas não publica nenhuma percentagem, por isso não cito nenhuma (guia de raciocínio da OpenAI).
Se o definir demasiado baixo, o modelo pára antes de ter provas suficientes. Comece em medium, meça e desça onde os resultados se mantêm.
2. Correr primeiro em low e repetir só as falhas em high
No mesmo teste da Anthropic, correr tudo em low e repetir em high os 13 % de tarefas falhadas resolveu cerca de 97 % por cerca de USD 0,17 por tarefa, contra 95,3 % por USD 0,29 com tudo em high. A Anthropic fala em cerca de 40 % menos com a mesma taxa de sucesso (guia).
Funciona quando se consegue ver automaticamente que uma tarefa falhou: um teste, uma validação de formulário, um campo em falta. Sem essa verificação, não se sabe o que repetir.
3. Usar modelos gratuitos para os passos simples
A OpenRouter, uma única API à frente de muitos fornecedores de modelos, lista versões gratuitas de alguns modelos, marcadas com :free. Os seus limites (limites da OpenRouter):
- 20 pedidos por minuto;
- 50 pedidos por dia se tiver comprado no total menos de USD 10 de créditos;
- 1.000 pedidos por dia depois de comprar USD 10 ou mais;
- as tentativas falhadas contam para o limite diário.
A coleção gratuita da OpenRouter incluía em novembro de 2026 o NVIDIA Nemotron 3 Ultra e o Nemotron 3.5 Super VL, o Cohere North Mini Code e o Google Gemma 4 (modelos gratuitos). A lista muda todas as semanas e algumas entradas gratuitas expiram.
Leia a política de dados antes de enviar algo privado. A OpenRouter não guarda os prompts a não ser que o ative, mas cada fornecedor tem a sua política e alguns estão marcados «may train», ou seja, podem usar os seus dados para treino (registo por fornecedor). Os modelos gratuitos servem para textos públicos ou anonimizados: resumos de páginas web, triagem, primeiros rascunhos, não dados de clientes nem dados pessoais abrangidos pelo RGPD.
4. Um modelo forte decide e modelos baratos trabalham
Deixe o modelo caro a planear e a verificar e passe os passos de volume a modelos mais baratos. Os dois grandes agentes de programação suportam-no: os subagentes do Claude têm a sua própria definição model, e o Codex tem default_subagent_model e default_subagent_reasoning_effort (subagentes da Anthropic, subagentes do Codex).
Como é essa divisão num só ecrã, com o custo de cada agente como uma barra, vê-se no meu protótipo de painel de orquestração multiagente (dados de exemplo).
Seja honesto sobre onde compensa. A Anthropic mediu um orquestrador forte com subagentes de tamanho médio a cerca de um terço menos de custo com uma pontuação quase igual, mas em trabalho maior do que uma janela de contexto. Quando o trabalho era uma única cadeia dependente ou cabia num só contexto, um único modelo com menos esforço saiu mais barato em todos os casos medidos (guia). O seu conselho: afine primeiro o esforço num só modelo, porque a maioria das cargas de trabalho acaba aí.
5. Guardar em cache o texto que envia sempre
Se cada pedido começa com as mesmas instruções, documentos ou lista de ferramentas, guarde-os em cache. Na Anthropic uma leitura de cache custa 10 % do preço normal de entrada, e 5 % nos seus modelos Opus e Sonnet mais recentes; a escrita em cache custa um pouco mais, uma vez (preços da Anthropic). A OpenAI cobra a entrada em cache a 5 % no GPT-6.1 Sol (página do modelo). A Anthropic mediu que a cache reduzia o custo de um agente de pesquisa entre 4,8 e 7,2 vezes e chama-lhe normalmente a maior alavanca.
Uma armadilha do mesmo guia: uma linha de estado de 25 tokens logo no início do prompt mudava em cada pedido, por isso cada pedido reescrevia toda a cache. Ponha no fim tudo o que muda.
6. Enviar em lote o que pode esperar
Relatórios, classificação noturna, extração em massa: tudo o que pode esperar até 24 horas pode ir pela API de lotes com 50 % de desconto, tanto na Anthropic como na OpenAI, e na Anthropic o desconto soma-se ao da cache (preços da Anthropic, preços da OpenAI).
7. Enviar menos
Cada documento, definição de ferramenta e mensagem antiga que anexa é relido em cada chamada. A Anthropic mediu que reduzir a entrada tirava mais 21 % a 26 % da fatura de um pequeno agente de triagem, e que carregar as definições de ferramentas só quando necessário poupava 45 % com 500 ferramentas ligadas (guia). Os prompts longos também podem passar um escalão de preço: o Haiku 5.5 cobra 5 vezes mais por prompts acima de 100.000 tokens.
8. Pedir respostas mais curtas
Escrever custa cerca de cinco vezes mais do que ler na maioria das tabelas de preços. A Anthropic mediu que «pedir respostas mais curtas» dava cerca de 13 % menos, com 39 % menos tokens de saída (guia). «Responde em três frases» ou «devolve só o JSON» é uma alteração gratuita.
9. Comparar as licenças com o uso da API
Os planos de equipa são por pessoa: os lugares standard do ChatGPT Business e do Claude Team custam USD 25 por mês, ou USD 20 com plano anual (ChatGPT Business, Claude Team). Dez lugares com faturação anual são USD 2.400 por ano. Se metade da equipa o abre duas vezes por mês, uma ferramenta interna sobre a API com limite de gasto pode custar menos. Se todos o usam diariamente, as licenças costumam compensar mais.
O meu caso semelhante
O meu próprio trabalho assenta nas formas 1, 3 e 4 em conjunto. O Claude ou o Codex continua a ser o orquestrador: planeia a tarefa e verifica o resultado. A maior parte do trabalho vai para modelos gratuitos na OpenRouter. E mudo o nível de esforço de tarefa para tarefa em vez de o deixar em high. Só o esforço já é uma grande alavanca: pelos números da Anthropic acima, passa o custo de uma tarefa de USD 0,29 em high para USD 0,11 em low.
O que custa um agente inteiro por execução está em quanto custa um agente de IA, e o que correu mal quando executei muitos agentes em paralelo está em orquestração multiagente: o que se partiu.
Envie-me o que paga hoje por IA e o que ela faz, e mostro-lhe onde pode custar menos. Este trabalho enquadra-se na integração de IA.
A sua fatura de IA cresce todos os meses?
Envie-me o que paga e o que a IA faz. Mostro-lhe que alavancas servem e ponho-as a funcionar.
Fale comigoLimites desta lista
- Benchmarks de fornecedor. As percentagens de esforço, cache e orquestração são testes internos da Anthropic sobre programação e agentes. As suas tarefas podem comportar-se de outro modo; meça com as suas.
- Sem percentagens da OpenAI. A OpenAI não publica diferença de tokens nem de custo entre níveis de esforço, por isso não se dá nenhuma.
- Os preços mudam. Consultados a 9 de novembro de 2026. A lista gratuita da OpenRouter muda todas as semanas e duas promoções em páginas de fornecedores terminam a 30 de novembro e a 31 de dezembro de 2026.
- Os modelos gratuitos não foram testados aqui em qualidade nem disponibilidade; verifique-os com a sua própria tarefa antes de depender de um.