TL;DR
I min test av fakturatolkning med AI leste tre av de fire modellene alle ni feltene riktig på 30 av 30 rene digitale fakturaer. På simulerte skanninger av de samme fakturaene klarte den beste 22 av 30. Feilene satt nesten aldri i beløpene. De satt i MVA-numre og fakturanumre, og det vanlige sikkerhetsnettet, å sjekke at netto pluss MVA er lik totalen, flagget bare 3 av de 63 feilaktige fakturaene. To enkle regler på MVA-numrene fanget 31 av de 32 feilaktige fakturaene fra de tre beste modellene. Den billigste modellen kostet USD 0,43 per 1 000 fakturaer, men på skanninger tilsvarte den ikke modellen til 17 ganger prisen: 14 av 30 mot 22. Gemini 3.8 Flash tilsvarte Sonnets 22 til omtrent halv pris.
Jeg kjørte denne testen på nytt 22. oktober 2026 på et nytt sett med fiktive fakturaer. Alle tallene i denne artikkelen er fra den nye kjøringen.
Jeg er Denys, fullstack- og AI-ingeniør. Tidligere i år bygde jeg en prototype for fakturauttrekk: en nettapp og et API som gjør PDF-fakturaer om til felt, der usikre felt merkes for en person. Den kjører på eksempeldata, uten noen modell bak. Så før jeg skrev om fakturatolkning, kjørte jeg en ekte test: 30 fiktive tsjekkiske, tyske og portugisiske leverandørfakturaer, fire modeller, 240 kall, USD 0,76 i fakturert bruk.
Hva gjør AI riktig og galt ved fakturatolkning?
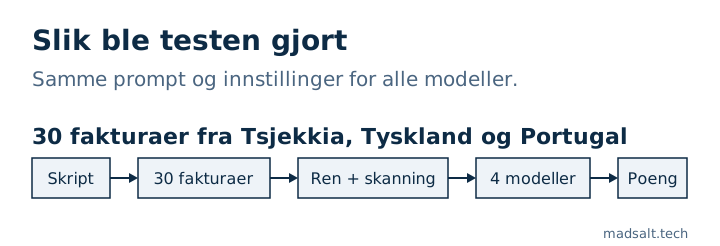
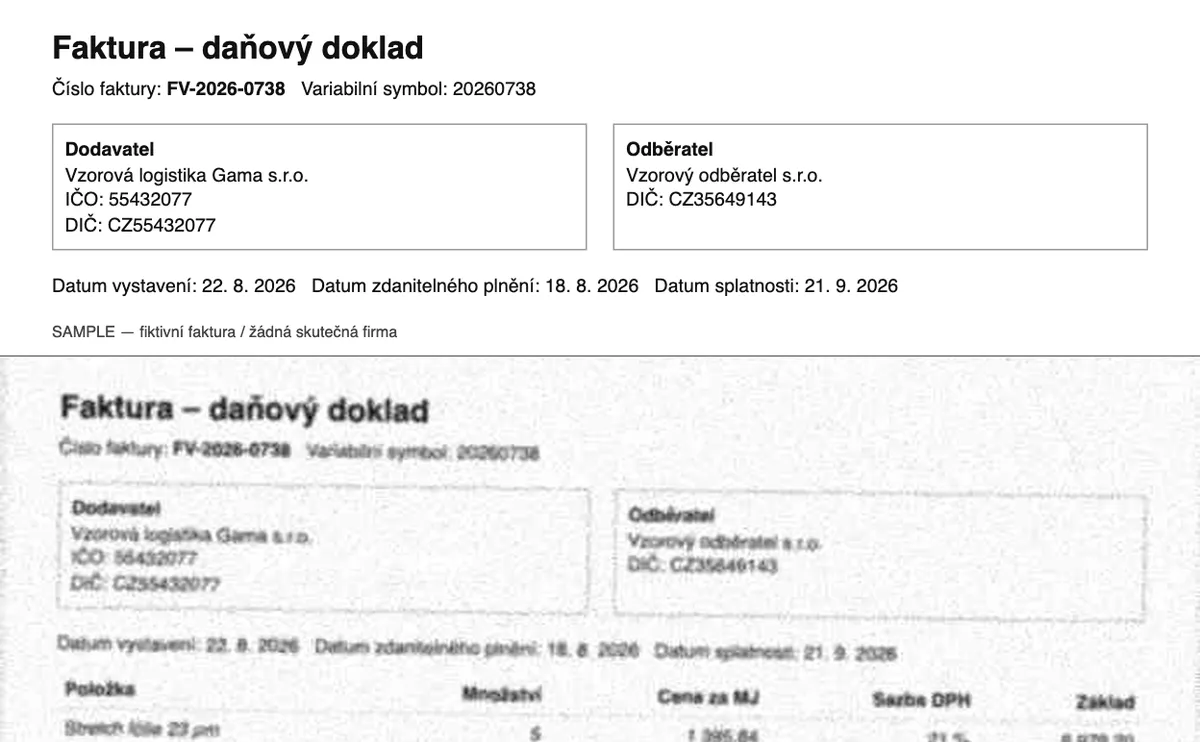
Hver modell leste hver faktura to ganger: som en ren gjengivelse, slik en PDF fra et regnskapsprogram ser ut, og som en simulert skanning, grå, litt rotert, uskarp og komprimert. En faktura teller som riktig bare når alle ni felt stemmer: fakturanummer, fakturadato, forfallsdato, leverandørens MVA-nummer, kjøperens MVA-nummer, valuta, nettototal, MVA-total og bruttototal.
| Modell | Ren, alle 9 felt riktige | Skanning, alle 9 felt riktige | USD per 1 000 fakturaer | Median sekunder per faktura |
|---|---|---|---|---|
| Claude Haiku 5.5 | 30 av 30 | 14 av 30 | 0,43 | 6,13 |
| Claude Sonnet 5.5 | 30 av 30 | 22 av 30 | 7,18 | 8,50 |
| Gemini 3.8 Flash | 30 av 30 | 22 av 30 | 3,51 | 8,43 |
| GPT-5.6 Luna | 29 av 30 | 0 av 30 | 1,52 | 10,85 |
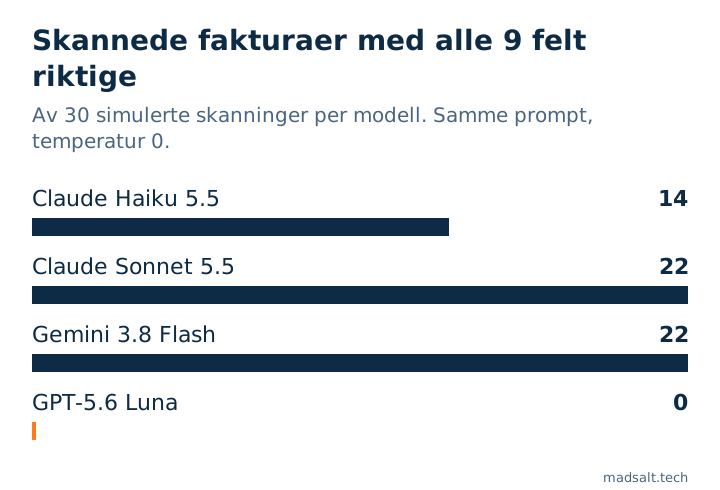
Kostnaden er det OpenRouter fakturerte for hvert kall, ikke et anslag fra prislisten. På rene fakturaer var Claude Haiku 5.5 og Claude Sonnet 5.5 like treffsikre, 30 av 30. På skanninger leste Sonnet 22 riktig mot Haikus 14, og kostet omtrent 17 ganger mer.
Trenger du fortsatt OCR for å hente ut fakturadata?
Ikke som et eget steg, i denne testen. Alle fire modellene fikk siden som et bilde og returnerte de ni feltene direkte, uten noe OCR-lag imellom. Det som endrer resultatet, er kvaliteten på siden. En ren PDF fra et regnskapsprogram har et tekstlag, og en skanning har det ikke: den er bare piksler. Kolonnen «skanning» i tabellen over er nettopp spørsmålet om OCR-kvalitet, og det er her modellene skiller seg: den beste leste 22 av 30 skannede fakturaer riktig, og den svakeste ingen.
Jeg testet ikke klassiske OCR-motorer eller malbaserte verktøy, så jeg kan ikke si hvordan de ville klart seg på de samme 30 fakturaene. Testen viser hvor risikoen ligger når en modell leser en skanning: i MVA-numre og fakturanumre, som kontrollene under fanger.
Hvordan var testen satt opp?
Jeg genererte fakturaene med et skript, så hver sann verdi er kjent på øre. Fakturaene er fiktive: firmanavnene inneholder Vzor, Muster, Beispiel eller Exemplo, og hver faktura har en bunntekst på det lokale språket med teksten “SAMPLE - fictitious invoice / no real company”. Hver faktura har fellene en ekte regnskapsmedarbeider møter i det landet:
- Lokale tallformater.
175 011,84 Kčpå tsjekkisk,10.465,61 €på tysk, og både1 234,56og1.234,56på portugisiske fakturaer. - En ekstra identifikator ved siden av fakturanummeret. Det tsjekkiske variable symbolet, det tyske kundenummeret, den portugisiske ATCUD-koden.
- En ekstra dato. Den tsjekkiske datoen for skattepliktig leveranse og den tyske tjenestedatoen står ved siden av fakturadatoen.
- To MVA-numre på én side, pluss et tysk skattenummer (Steuernummer) som ligner et MVA-nummer og ikke er det.
- Vanskelige tilfeller. Blandede MVA-satser, en faktura uten MVA, en faktura med omvendt avgiftsplikt, en kreditnota med negative beløp og en faktura med ni linjer i hvert land.
Hvert MVA-nummer har et gyldig kontrollsiffer, verifisert med biblioteket python-stdnum, og ingen av dem er registrert: jeg slo opp hvert av de 33 brukte numrene (30 leverandørnumre og ett kjøper-MVA-nummer per land) i EUs VIES-tjeneste, og den svarte “ikke gyldig” for alle. De 11 tsjekkiske selskapsnumrene bak de tsjekkiske MVA-numrene ble også slått opp i det tsjekkiske foretaksregisteret, ARES, og ikke funnet. Alle fire modellene fikk samme prompt, ved temperatur 0, ett kall per bilde.
Hvorfor fanget totalsjekken nesten ingenting?
Å sjekke at netto pluss MVA er lik brutto er den første regelen de fleste uttrekkspipelines legger til, og den prototypen min bruker. I denne testen flagget den 3 av de 63 feilaktige fakturaene på tvers av de fire modellene: én Gemini 3.8 Flash-skanning (cz06, bruttototalen feil), én GPT-5.6 Luna-skanning (cz08, der fakturadatoen, kjøperens MVA-nummer, netto og MVA var feil) og én ren Luna-faktura (pt02, nettototalen feil).
Grunnen er hvor feilene satt. Claude Haiku 5.5, Claude Sonnet 5.5 og Gemini 3.8 Flash gjorde 32 feilaktige uttrekk til sammen, og bare to hadde et feil beløp: Gemini-skanningen over og en Haiku-skanning (cz09) der netto- og MVA-totalene var litt feil, men netto pluss MVA fortsatt var lik brutto, så sjekken forble stille. De andre leste et siffer feil i et MVA-nummer eller i et fakturanummer, som FV-2026-0738 lest som FV-2026-0758. GPT-5.6 Luna tok feil på beløp på 7 fakturaer, og på 5 av dem gikk netto, MVA og brutto likevel opp. En modell leser en total som stemmer med resten av det den leste, så en regnesjekk går forbi det meste av feilene.
Hvilke kontroller fanger feilene?
To regler på MVA-numrene, begge noen få linjer kode:
- Kontrollsifferet. Et MVA-nummer ender med et kontrollsiffer beregnet fra de andre sifrene: modulo 11 for det tsjekkiske organisasjonsnummeret bak et DIČ og for det portugisiske NIF, ISO 7064 for det tyske USt-IdNr. Biblioteker som python-stdnum implementerer alle tre. Et feillest siffer bryter det nesten alltid.
- Ditt eget MVA-nummer. På en innkommende faktura er kjøperen deg. Et kjøper-MVA-nummer som ikke er ditt, er feil, eller så var ikke fakturaen ment for deg.
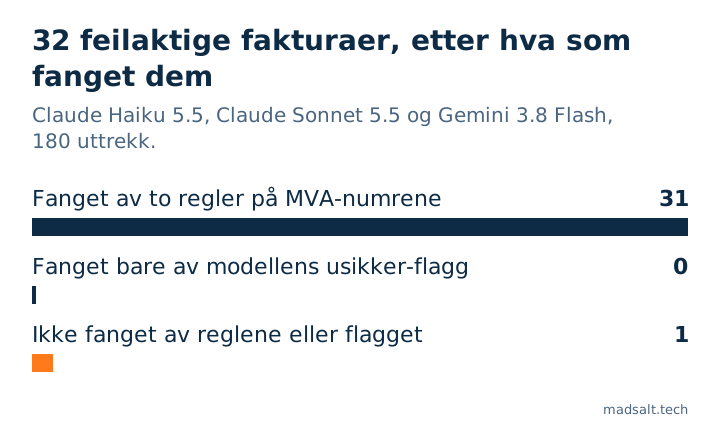
Den ene som var igjen, Gemini-skanningen cz06, hadde en feil bruttototal. Ingen MVA-regel kan se det, og Gemini oppgir aldri usikre felt, så bare totalsjekken fanget den. Jeg ba hver modell liste feltene den var usikker på:
| Modell | Feilaktige fakturaer | Fanget av de to reglene | Fanget bare av eget usikker-flagg | Ikke fanget | Riktige fakturaer den likevel flagget |
|---|---|---|---|---|---|
| Claude Haiku 5.5 | 16 | 16 | 0 | 0 | 13 av 44 |
| Claude Sonnet 5.5 | 8 | 8 | 0 | 0 | 19 av 52 |
| Gemini 3.8 Flash | 8 | 7 | 0 | 1 | 0 av 52 |
| GPT-5.6 Luna | 31 | 30 | 0 | 1 | 0 av 29 |
Gemini 3.8 Flash oppga aldri et felt som usikkert, så for den er kontrollene alt du har; her fanget de to reglene 7 av dens 8 feilaktige fakturaer og totalsjekken den åttende. Claude-modellene flagget for mye heller enn for lite: Haiku flagget 13 av sine 44 riktige fakturaer (30 %) og Sonnet 19 av 52 (37 %), alle skanninger; ingen av dem flagget en eneste ren faktura. Det er byttet du vil ha i leverandørreskontro, der et blikk fra en saksbehandler koster mindre enn en feil betaling.
To ting til dukket opp. GPT-5.6 Lunas feil var ikke begrenset til identifikatorer: av dens 31 feilaktige fakturaer var 30 skanninger, 20 hadde feil fakturanummer, 13 feil fakturadato og 15 feil forfallsdato, og 15 beløpsfelt var feil på 7 fakturaer. Dens ene faktura i kolonnen «Ikke fanget» er en ren en, pt02, med feil nettototal: de to reglene og usikker-flagget bommet på den, totalsjekken gjorde ikke det. Og et kontrollsiffer kan ikke fange alle feillesinger, for noen feile numre er også gyldige; i denne kjøringen besto ikke noe feilaktig MVA-nummer begge reglene.
Hvilken modell bør du bruke til fakturatolkning?
På dette settet var skanningsresultatene: Claude Sonnet 5.5 22 av 30 med 8 feilaktige fakturaer til USD 7,18 per 1 000; Gemini 3.8 Flash også 22 av 30 med 8 feilaktige fakturaer til USD 3,51, omtrent halv pris; Claude Haiku 5.5 14 av 30 med 16 feilaktige til USD 0,43. Gemini tilsvarte Sonnet i treffsikkerhet til omtrent halv pris, men den oppgir aldri usikre felt: dens feilaktige fakturaer ble fanget av de to MVA-reglene (7) og totalsjekken (1), mens Sonnet også flagget 19 av sine 52 riktige fakturaer. Med kontrollene på plass ble ingen av Haikus eller Sonnets feilaktige fakturaer stille, så den billigste modellen betyr flere feilaktige fakturaer å rette (16 mot 8), ikke flere feil i regnskapet. Hvis du sender hver faktura til en modell, er modellen sjelden den store kostnaden; kostnaden for en AI-agent fungerer på samme måte. GPT-5.6 Luna er ikke brukbar på skanninger i denne testen.
Den rangeringen er én test på 30 fakturaer. Kjør dine egne fakturaer gjennom to eller tre modeller før du velger.
Trenger du en modell i det hele tatt?
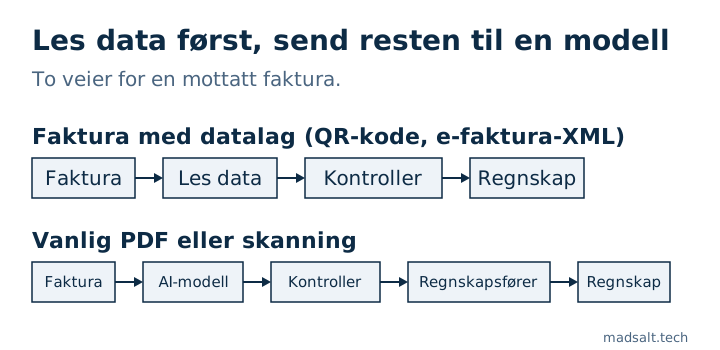
Ofte ikke, og i noen land mindre for hvert år. Før du sender et bilde av en faktura til en modell, sjekk om dataene allerede ligger i filen:
- Portugal. Hver faktura fra sertifisert programvare må ha en QR-kode med begge NIF-ene, datoen, fakturanummeret, ATCUD-en og skattegrunnlaget og MVA per sats (Portaria n.º 195/2020, AT-spesifikasjon for QR-koden). Leser du QR-koden, får du de fleste feltene nøyaktig.
- Tyskland. Siden 1. januar 2025 teller ikke en vanlig PDF lenger som e-faktura mellom tyske virksomheter. Papir- og PDF-fakturaer er tillatt i en overgangsperiode som for alle virksomheter slutter ved utgangen av 2027 (FAQ fra det tyske finansdepartementet). XRechnung- og ZUGFeRD-fakturaer bærer strukturerte data du kan lese direkte.
- Tsjekkia. Mange regnskapsverktøy legger et ISDOC-datalag inne i PDF-en; Fakturoid har lagt det til i alle sine PDF-fakturaer siden desember 2022 (Fakturoid).
Rekkefølgen som fungerer er altså: les datalaget hvis det finnes, send bare resten til en modell, og kjør så kontrollene. Modellen er reserveløsningen, ikke første steg.
Hvordan kommer feltene inn i Excel eller regnskapssystemet?
Arkivet som det lenkes til under, inneholder allerede en CSV med alle resultatene, én rad per uttrekk, så resultatet kan åpnes direkte i Excel. Min prototype for fakturauttrekk fungerer på samme måte på appnivå: den eksporterer de godkjente feltene, og den har ett API-kall som tar en PDF og returnerer feltene som JSON for hver faktura.
Derfra kan en CSV- eller XLSX-fil importeres i et regnskapssystem som tar imot filimport, eller JSON kan sendes videre av et lite skript. Prototypen kjører på eksempeldata, og jeg har ikke koblet den til noe bestemt regnskapsprodukt. For en kjøring fra PDF til Excel som også tar med fakturalinjer og en arbeidsbok med to ark, se Faktura fra PDF til Excel: når trenger du KI?.
Hvis du fortsatt vurderer hvilken del av virksomheten som er verdt å automatisere, hjelper jeg deg å velge den og bygger den etterpå: se AI-konsulent for små bedrifter. Kundemeldinger er den andre vanlige første jobben for AI i en liten bedrift: hva en WhatsApp-chatbot med AI koster per svar, med Metas gebyr regnet med.
Hva beviser ikke denne testen?
- Fakturaene er fiktive. Én layout per land, generert av et skript, med eksempelfirmanavn. Ekte leverandørfakturaer varierer langt mer.
- Skanningene er simulerte. Uskarphet, rotasjon, støy og JPEG-komprimering på en ren gjengivelse, ikke papir gjennom en skanner eller et mobilbilde.
- Ett kall per faktura, ett sett på 30. Resultatene varierer mye mellom sett. Denne artikkelen ble først kjørt på et annet sett med 30 fakturaer, der skanningsresultatene for Haiku, Sonnet og Gemini var 22, 22 og 17 av 30; på dette settet er de 14, 22 og 22. Hvert land har ett kjøper-MVA-nummer som gjentas på 10 fakturaer, så én feillest tallrekke kan ødelegge opptil 10 fakturaer på én gang.
- Prisene endrer seg. Kostnadene er det OpenRouter fakturerte 22. oktober 2026.
- Bare ni felt. Ingen fakturalinjer, IBAN-er eller betalingsvilkår.
Slik gjentar du testen på dine egne fakturaer
- Velg 30 til 50 ekte fakturaer, inkludert de verste skanningene du mottar. Skriv ned de sanne verdiene for hånd.
- Bruk én prompt og et fast utdataskjema med en liste over usikre felt, ved temperatur 0.
- Kjør to eller tre modeller og noter den fakturerte kostnaden per kall, ikke listeprisen.
- Score hele fakturaer, ikke enkeltfelt: ett feil siffer i et MVA-nummer er en feilaktig faktura.
- Legg til kontrollsiffer-regelen og regelen om ditt eget MVA-nummer, og mål hva de fanger.
- Les datalaget først overalt der leverandørenes programvare har et.
Skriptene, de genererte fakturaene og alle resultatene ligger i ett arkiv: generatoren, kjøreren, poengberegneren og en CSV med alle 240 uttrekk. Hvis du vil ha dette bygget inn i prosessen din for leverandørreskontro, er det en del av arbeidsflytautomatisering.
Hvis du vil legge en slik uttrekking til en prosess du allerede kjører, gjør jeg det under AI-integrasjon i eksisterende produkter.
Se også: Dokumenthåndteringssystem for små bedrifter: 8 priset.
Mitt tilsvarende tilfelle
Jeg bygde en tjeneste som gjør en eiendomsattest som tok 2–3 uker og kostet EUR 200–300 om til en som tar 2–3 minutter og koster EUR 99, med skript og vision-AI. Byggingen står i caset om automatisering av eiendomsdokumenter.
Henter du ut fakturadata for hånd eller med et verktøy du ikke stoler på? Skriv til meg, så finner vi det beste alternativet for deg.
Taster du fortsatt fakturadata for hånd?
Fortell meg hva du har nå og hva du trenger. Jeg svarer med alternativet jeg selv ville valgt.
Skriv til meg