TL;DR
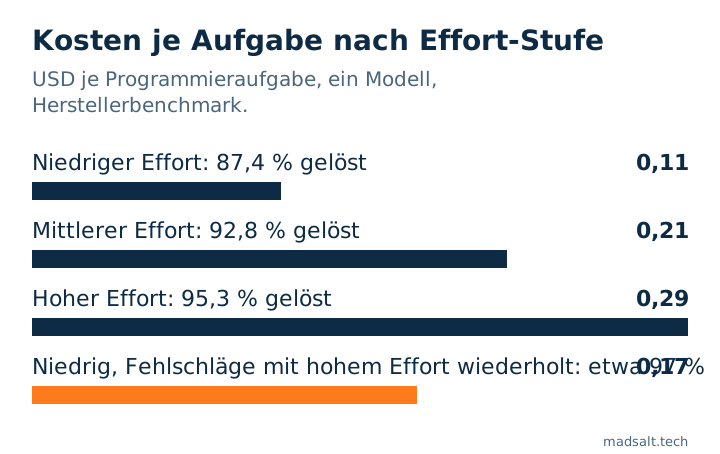
Um KI Kosten zu senken, zahlen Sie nicht mehr für jeden Schritt den Preis des Spitzenmodells. Drehen Sie zuerst die Effort-Stufe herunter: In Anthropics eigenem Test löste ein Modell bei niedrigem Effort 87,4 % der Programmieraufgaben für je USD 0,11, bei hohem Effort 95,3 % für USD 0,29. Erst niedrig laufen zu lassen und nur die Fehlschläge mit hohem Effort zu wiederholen, ergab etwa 97 % für rund USD 0,17. Danach: wiederkehrende Prompts cachen, aufschiebbare Arbeit im Batch laufen lassen (50 % Rabatt), einfache Schritte an kostenlose oder günstige Modelle geben und das starke Modell nur entscheiden lassen.
Ich bin Denys, Full-Stack- und KI-Ingenieur. Ich baue KI-Agenten und Automatisierungen für kleine Unternehmen. Das ist die Liste, die ich selbst benutze. Sie richtet sich an Inhaber, die auf der Rechnung eine wachsende KI-Zeile sehen und wissen wollen, an welchen Hebeln man ziehen kann. Die Zahlen sind Herstellerangaben vom November 2026, dort verlinkt, wo sie vorkommen; die Benchmark-Werte von Anthropic stammen aus dessen eigenen internen Tests. Alle Preise stehen in USD, so wie die Hersteller sie veröffentlichen.
KI Kosten senken: Woher kommt die Rechnung?
Aus Tokens, den Textstücken, die ein Modell liest und schreibt. Schreiben kostet mehr als Lesen: In der Preisliste von Anthropic berechnet ein starkes Modell USD 4 je Million gelesener und USD 20 je Million geschriebener Tokens, das kleinste Modell USD 0,10 und 0,50 (Anthropic-Preise). Wer wissen will, was KI kostet, muss also drei Dinge betrachten: welches Modell Sie aufrufen, wie viel es denkt und schreibt und wie oft Sie ihm denselben langen Text erneut schicken. Jeder der Wege unten senkt einen dieser drei Posten.
| Weg | Was er senkt | Typische Ersparnis (Herstellerangaben) |
|---|---|---|
| 1. Effort-Stufe senken | Denken und Schreiben | medium 30–52 % günstiger als high |
| 2. Erst low, Fehlschläge mit high wiederholen | Denken bei einfachen Aufgaben | etwa 40 % günstiger als alles auf high |
| 3. Kostenlose Modelle für einfache Schritte | Preis je Token | USD 0 innerhalb der Tageslimits |
| 4. Starkes Modell entscheidet, günstige arbeiten | Preis je Token | etwa ein Drittel, nur bei großen Aufgaben |
| 5. Prompt-Caching | erneutes Lesen desselben Textes | Cache-Lesen kostet 5–10 % des Eingabepreises |
| 6. Aufschiebbares im Batch | alles | 50 % Rabatt |
| 7. Weniger senden | Lesen | 21–26 % bei einem kleinen Agenten |
| 8. Kürzere Antworten verlangen | Schreiben | etwa 13 % |
| 9. Lizenzen gegen API prüfen | ungenutzte Lizenzen | hängt von der Nutzung ab |
1. Die Effort-Stufe herunterdrehen
Die meisten aktuellen Modelle haben eine Effort- oder Reasoning-Einstellung, und nach der Modellwahl ist sie der größte einzelne Hebel. Bei Anthropic heißen die Stufen low, medium, high, xhigh und max, und der Effort verändert alle Tokens der Antwort, auch Werkzeugaufrufe und das Nachdenken (Anthropic-Dokumentation zu Effort).
Anthropics veröffentlichter Test mit Claude Opus 5.5 (eine Teilmenge von SWE-bench Pro, der eigene Benchmark) (Leitfaden zu Kosten und Intelligenz):
| Effort | Gelöste Aufgaben | Kosten je Aufgabe |
|---|---|---|
| low | 87,4 % | USD 0,11 |
| medium (Standard) | 92,8 % | USD 0,21 |
| high | 95,3 % | USD 0,29 |
Derselbe Leitfaden nennt bei langen Programmieraufgaben für medium etwa 30 % bis 52 % geringere Kosten als für high und für low rund zwei Drittel weniger. Die Modelle von OpenAI haben denselben Schalter (reasoning.effort, von low bis max), und OpenAI weist darauf hin, dass Reasoning-Tokens als Ausgabe abgerechnet werden. Eine Prozentzahl nennt OpenAI aber nicht, deshalb zitiere ich keine (OpenAI-Leitfaden zu Reasoning).
Zu niedrig eingestellt, hört das Modell auf, bevor es genug Belege hat. Beginnen Sie bei medium, messen Sie und gehen Sie dort tiefer, wo die Ergebnisse halten.
2. Erst auf low laufen lassen, nur die Fehlschläge mit high wiederholen
Im selben Test von Anthropic wurde alles auf low ausgeführt und nur die 13 % fehlgeschlagener Aufgaben auf high wiederholt. Das löste etwa 97 % für rund USD 0,17 je Aufgabe, gegenüber 95,3 % für USD 0,29, wenn alles auf high lief. Anthropic spricht von etwa 40 % weniger bei gleicher Erfolgsquote (Leitfaden).
Das funktioniert, wenn sich automatisch erkennen lässt, dass eine Aufgabe fehlgeschlagen ist: ein Test, eine Formularprüfung, ein fehlendes Feld. Ohne diese Prüfung wissen Sie nicht, was Sie wiederholen sollen.
3. Kostenlose Modelle für einfache Schritte nutzen
OpenRouter, eine einzige API vor vielen Modellanbietern, führt kostenlose Versionen einiger Modelle, markiert mit :free. Die Limits (OpenRouter-Limits):
- 20 Anfragen pro Minute;
- 50 Anfragen pro Tag, wenn Sie insgesamt weniger als USD 10 Guthaben gekauft haben;
- 1.000 Anfragen pro Tag, sobald Sie USD 10 oder mehr gekauft haben;
- fehlgeschlagene Versuche zählen zum Tageslimit.
Die kostenlose Sammlung von OpenRouter enthielt im November 2026 unter anderem NVIDIA Nemotron 3 Ultra und Nemotron 3.5 Super VL, Cohere North Mini Code und Google Gemma 4 (kostenlose Modelle). Die Liste ändert sich wöchentlich, und manche kostenlosen Einträge laufen aus.
Lesen Sie die Datenschutzregeln, bevor Sie etwas Vertrauliches senden. OpenRouter selbst speichert Prompts nur, wenn Sie das aktivieren, aber jeder Anbieter hat eine eigene Richtlinie, und manche sind mit „may train“ markiert, dürfen Ihre Daten also zum Training nutzen (Provider-Logging). Kostenlose Modelle sind für öffentliche oder anonymisierte Texte gedacht: Zusammenfassungen von Webseiten, Sortieren, erste Entwürfe, keine Mandantendaten und keine personenbezogenen Daten, die unter die DSGVO fallen.
4. Ein starkes Modell entscheiden lassen, günstige Modelle arbeiten
Das teure Modell plant und prüft, die Masse der Schritte übernehmen günstigere. Beide großen Coding-Agenten unterstützen das: Die Subagenten von Claude haben eine eigene model-Einstellung, und Codex kennt default_subagent_model und default_subagent_reasoning_effort (Anthropic-Subagenten, Codex-Subagenten).
Wie diese Aufteilung auf einem Bildschirm aussieht, mit den Kosten jedes Agenten als Balken, zeigt mein Prototyp, das Dashboard für Multi-Agent-Orchestrierung (Beispieldaten).
Seien Sie ehrlich dabei, wo sich das lohnt. Anthropic maß bei einem starken Orchestrator mit mittelgroßen Subagenten etwa ein Drittel geringere Kosten bei ungefähr gleichem Ergebnis, aber bei Arbeit, die größer als ein Kontextfenster war. War die Arbeit eine einzige abhängige Kette oder passte in einen Kontext, schnitt in jedem gemessenen Fall ein einzelnes Modell mit niedrigerem Effort günstiger ab (Leitfaden). Der Rat von Anthropic: erst den Effort an einem Modell abstimmen, denn die meisten Workloads enden dort.
5. Den Text cachen, den Sie jedes Mal senden
Beginnt jede Anfrage mit denselben Anweisungen, Dokumenten oder derselben Werkzeugliste, cachen Sie sie. Bei Anthropic kostet ein Cache-Treffer 10 % des normalen Eingabepreises, bei den neuesten Opus- und Sonnet-Modellen 5 %; das Schreiben in den Cache kostet einmalig etwas mehr (Anthropic-Preise). OpenAI berechnet zwischengespeicherte Eingabe bei GPT-6.1 Sol mit 5 % (Modellseite). Anthropic maß, dass Caching die Kosten eines Recherche-Agenten um das 4,8- bis 7,2-Fache senkte, und nennt es meist den größten Hebel.
Eine Falle aus demselben Leitfaden: Eine Statuszeile mit 25 Tokens ganz am Anfang des Prompts änderte sich bei jeder Anfrage, sodass jede Anfrage den gesamten Cache neu schrieb. Alles, was sich ändert, gehört ans Ende.
6. Aufschiebbares im Batch laufen lassen
Berichte, nächtliche Klassifizierung, Massenextraktion: Alles, was bis zu 24 Stunden warten kann, geht bei Anthropic und OpenAI über die Batch-API mit 50 % Rabatt, und bei Anthropic lässt sich der Rabatt mit Caching kombinieren (Anthropic-Preise, OpenAI-Preise).
7. Weniger senden
Jedes Dokument, jede Werkzeugdefinition und jede alte Nachricht, die Sie anhängen, wird bei jedem Aufruf erneut gelesen. Anthropic maß, dass das Kürzen der Eingabe die Rechnung eines kleinen Triage-Agenten um weitere 21 % bis 26 % senkte, und dass das Laden von Werkzeugdefinitionen nur bei Bedarf bei 500 angehängten Werkzeugen 45 % sparte (Leitfaden). Lange Prompts können außerdem eine Preisstufe überschreiten: Haiku 5.5 berechnet für Prompts über 100.000 Tokens das Fünffache.
8. Kürzere Antworten verlangen
Schreiben kostet in den meisten Preislisten etwa das Fünffache von Lesen. Anthropic maß bei „kürzere Antworten verlangen“ rund 13 % weniger durch 39 % weniger Ausgabe-Tokens (Leitfaden). „Antworte in drei Sätzen“ oder „gib nur das JSON zurück“ ist eine kostenlose Änderung.
9. Lizenzen gegen die API-Nutzung prüfen
Team-Tarife gelten pro Person: ChatGPT Business und Claude Team kosten je Standardplatz USD 25 im Monat oder USD 20 bei Jahrestarif (ChatGPT Business, Claude Team). Zehn Plätze mit Jahresabrechnung sind USD 2.400 im Jahr. Öffnet die Hälfte des Teams das Tool zweimal im Monat, kann ein internes Tool auf der API mit Ausgabenlimit günstiger sein. Nutzt es jeder täglich, sind Lizenzen meist das bessere Geschäft.
Mein ähnlicher Fall
Meine eigene Arbeit läuft auf den Wegen 1, 3 und 4 zusammen. Claude oder Codex bleibt der Orchestrator: Er plant die Aufgabe und prüft das Ergebnis. Die Masse der Arbeit geht an kostenlose Modelle auf OpenRouter. Und den Effort stelle ich von Aufgabe zu Aufgabe um, statt ihn auf high stehen zu lassen. Allein der Effort ist ein großer Hebel: Nach den Zahlen von Anthropic oben sinken die Kosten einer Aufgabe von USD 0,29 bei high auf USD 0,11 bei low.
Was ein ganzer Agent pro Lauf kostet, steht in Was ein KI-Agent kostet, und was schiefging, als ich viele Agenten parallel laufen ließ, in Multi-Agent-Orchestrierung: Was kaputtging.
Schicken Sie mir, was Sie heute für KI zahlen und was sie leistet, und ich zeige Ihnen, wo es günstiger geht. Diese Arbeit gehört zur KI-Integration.
Wächst Ihre KI-Rechnung jeden Monat?
Schicken Sie mir, was Sie zahlen und was die KI tut. Ich zeige Ihnen, welche dieser Hebel passen, und richte sie ein.
Schreiben Sie mirGrenzen dieser Liste
- Herstellerbenchmarks. Die Prozentwerte zu Effort, Caching und Orchestrierung stammen aus Anthropics eigenen internen Tests zu Programmier- und Agentenarbeit. Ihre Aufgaben können anders reagieren; messen Sie an Ihren eigenen.
- Keine OpenAI-Prozentwerte. OpenAI veröffentlicht keinen Unterschied bei Tokens oder Kosten zwischen den Effort-Stufen, daher nenne ich keinen.
- Preise ändern sich. Stand 9. November 2026. Die kostenlose Liste von OpenRouter ändert sich wöchentlich, und zwei Aktionen auf Herstellerseiten enden am 30. November und 31. Dezember 2026.
- Kostenlose Modelle wurden hier nicht auf Qualität oder Verfügbarkeit getestet; prüfen Sie sie an Ihrer eigenen Aufgabe, bevor Sie sich auf eines verlassen.