TL;DR
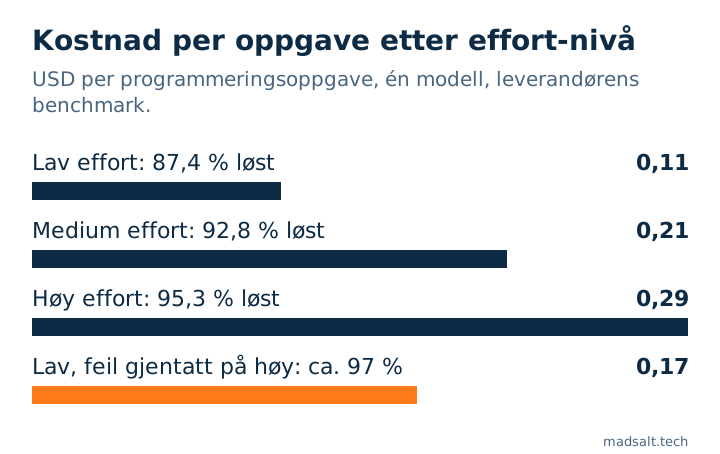
Den raskeste måten å redusere AI-kostnader på er å slutte å betale toppmodellens pris for hvert eneste steg. Skru ned effort-nivået først: I Anthropics egen test løste én modell 87,4 % av programmeringsoppgavene med lav effort for USD 0,11 hver, mot 95,3 % med høy effort for USD 0,29. Å kjøre lav først og bare gjenta feilene med høy effort ga rundt 97 % for rundt USD 0,17. Deretter: bruk cache på gjentatte prompter, kjør det som kan vente i batch (50 % rabatt), gi enkle steg til gratis eller billige modeller, og la den sterke modellen være den som avgjør.
Jeg heter Denys og er full-stack- og AI-ingeniør. Jeg bygger AI-agenter og automatiseringer for små firmaer. Dette er listen jeg selv bruker. Den er for eieren som ser en AI-linje på fakturaen som vokser og vil vite hvilke spaker som faktisk flytter den. Tallene er leverandørtall fra november 2026, lenket der de dukker opp; benchmark-tallene fra Anthropic er selskapets egne interne tester. Alle priser står i USD, slik leverandørene publiserer dem.
Hvor kommer en AI-regning fra?
Fra tokens, de tekstbitene en modell leser og skriver. Å skrive koster mer enn å lese: På Anthropics prisliste tar en sterk modell USD 4 per million tokens lest og USD 20 per million skrevet, og den minste modellen USD 0,10 og 0,50 (Anthropic pricing). Regningen vokser altså med tre ting: hvilken modell du kaller, hvor mye den tenker og skriver, og hvor ofte du sender den den samme lange teksten på nytt. Hver måte under kutter én av dem.
Ni måter å redusere AI-kostnader på
| Måte | Hva den kutter | Typisk besparelse (leverandørtall) |
|---|---|---|
| 1. Senk effort-nivået | tenking og skriving | medium 30–52 % mindre enn høy |
| 2. Lav først, gjenta feil med høy | tenking på enkle oppgaver | omtrent 40 % mindre enn alt på høy |
| 3. Gratis modeller til enkle steg | pris per token | USD 0 innenfor daglige tak |
| 4. Sterk modell avgjør, billige jobber | pris per token | omtrent en tredjedel, bare på store jobber |
| 5. Prompt-caching | å lese samme tekst om igjen | cache-lesing til 5–10 % av inputprisen |
| 6. Batch det som kan vente | alt | 50 % rabatt |
| 7. Send mindre | lesing | 21–26 % på én liten agent |
| 8. Be om kortere svar | skriving | omtrent 13 % |
| 9. Lisenser eller API | ubrukte lisenser | avhenger av bruk |
1. Skru ned effort-nivået
De fleste nåværende modeller har en effort- eller resonneringsinnstilling, og den er den største enkeltspaken etter selve modellvalget. Anthropics nivåer er low, medium, high, xhigh og max, og effort endrer alle tokens i svaret, også verktøykall og tenking (Anthropic effort docs).
Anthropics publiserte test på Claude Opus 5.5 (et utvalg fra SWE-bench Pro, deres egen benchmark) (cost and intelligence guide):
| Effort | Oppgaver løst | Kostnad per oppgave |
|---|---|---|
| low | 87,4 % | USD 0,11 |
| medium (standard) | 92,8 % | USD 0,21 |
| high | 95,3 % | USD 0,29 |
Samme guide sier at medium kostet omtrent 30 % til 52 % mindre enn high på lange programmeringsoppgaver, og low omtrent to tredjedeler mindre. OpenAIs modeller har samme bryter (reasoning.effort, low til max), og OpenAI påpeker at resonneringstokens faktureres som output, men publiserer ingen prosent, så jeg oppgir ingen (OpenAI reasoning guide).
Settes den for lavt, stopper modellen før den har nok grunnlag. Start på medium, mål, og gå lavere der resultatene holder.
2. Kjør lav først, gjenta bare feilene med høy effort
I samme Anthropic-test løste det omtrent 97 % for omtrent USD 0,17 per oppgave å kjøre alt på low og kjøre de 13 % som feilet på nytt med high, mot 95,3 % for USD 0,29 med alt på high. Anthropic kaller det omtrent 40 % mindre ved samme beståttrate (guide).
Dette virker når du kan se automatisk at en oppgave feilet: en test, en skjemasjekk, et manglende felt. Uten en slik sjekk vet du ikke hva som skal gjentas.
3. Bruk gratis modeller til enkle steg
OpenRouter, ett API foran mange modellleverandører, har gratisversjoner av enkelte modeller, merket :free. Grensene (OpenRouter limits):
- 20 forespørsler i minuttet;
- 50 forespørsler om dagen hvis du har kjøpt for mindre enn USD 10 i kreditter totalt;
- 1 000 forespørsler om dagen når du har kjøpt for USD 10 eller mer;
- mislykkede forsøk teller med i dagstaket.
OpenRouters gratissamling i november 2026 inneholdt NVIDIA Nemotron 3 Ultra og Nemotron 3.5 Super VL, Cohere North Mini Code og Google Gemma 4 (free models). Listen endres hver uke, og noen gratisoppføringer utløper.
Les databehandlingsreglene før du sender noe privat. OpenRouter selv lagrer ikke prompter med mindre du velger det, men hver leverandør har sin egen policy, og noen er merket «may train» på dataene dine (provider logging). Gratis modeller er for offentlig eller anonymisert tekst: sammendrag av nettsider, sortering, førsteutkast, ikke kundeopplysninger.
4. La en sterk modell avgjøre og billige modeller gjøre jobben
Behold den dyre modellen som den som planlegger og kontrollerer, og gi bulkarbeidet til billigere modeller. Begge de store kodeagentene støtter dette: Claudes subagenter har sin egen model-innstilling, og Codex har default_subagent_model og default_subagent_reasoning_effort (Anthropic subagents, Codex subagents).
Hvordan den fordelingen ser ut på én skjerm, med kostnaden for hver agent som en stolpe, viser prototypen min dashbord for multiagentorkestrering (eksempeldata).
Vær ærlig om hvor det lønner seg. Anthropic målte en sterk orkestrator med mellomstore subagenter til omtrent en tredjedel lavere kostnad for omtrent samme resultat, men på arbeid som var større enn ett kontekstvindu. Når arbeidet var én avhengig kjede eller fikk plass i én kontekst, ble én modell med lavere effort billigere i alle tilfeller Anthropic målte (guide). Rådet er å justere effort på én modell først, fordi de fleste arbeidsmengder ender der.
5. Bruk cache på teksten du sender hver gang
Hvis hver forespørsel starter med de samme instruksjonene, dokumentene eller verktøylisten, bruk cache. Hos Anthropic koster en cache-lesing 10 % av vanlig inputpris, og 5 % på de nyeste Opus- og Sonnet-modellene; cache-skrivingen koster litt mer, én gang (Anthropic pricing). OpenAI priser cachet input til 5 % på GPT-6.1 Sol (model page). Anthropic målte at caching kuttet kostnaden til en researchagent med 4,8 til 7,2 ganger, og kaller det vanligvis den største spaken.
En felle fra samme guide: en statuslinje på 25 tokens helt først i prompten endret seg i hver forespørsel, så hver forespørsel skrev hele cachen på nytt. Legg alt som endrer seg til slutt.
6. Kjør det som kan vente i batch
Rapporter, klassifisering over natten, masseuttrekk: alt som kan vente opptil 24 timer kan gå gjennom batch-API-et med 50 % rabatt hos både Anthropic og OpenAI, og hos Anthropic kan rabatten kombineres med caching (Anthropic pricing, OpenAI pricing).
7. Send mindre
Hvert dokument, hver verktøydefinisjon og hver gamle melding du legger ved, leses på nytt i hvert kall. Anthropic målte at beskjæring av input tok ytterligere 21 % til 26 % av regningen til en liten triageagent, og at det å laste verktøydefinisjoner bare ved behov sparte 45 % med 500 verktøy tilkoblet (guide). Lange prompter kan også passere et pristrinn: Haiku 5.5 tar 5 ganger så mye for prompter over 100 000 tokens.
8. Be om kortere svar
Å skrive koster omtrent fem ganger så mye som å lese på de fleste prislister. Anthropic målte «be om kortere svar» til omtrent 13 % lavere kostnad av 39 % færre output-tokens (guide). «Svar i tre setninger» eller «returner bare JSON» er en gratis endring.
9. Sjekk lisenser mot API-bruk
Teamabonnementer er per person: standardlisenser i ChatGPT Business og Claude Team koster USD 25 i måneden, eller USD 20 på årsabonnement (ChatGPT Business, Claude Team). Ti lisenser med årlig fakturering er USD 2 400 i året. Hvis halve teamet åpner den to ganger i måneden, kan et internt verktøy på API-et med en utgiftsgrense koste mindre. Hvis alle bruker den daglig, er lisenser som regel den bedre avtalen.
Mitt tilsvarende tilfelle
Mitt eget arbeid kjører på måte 1, 3 og 4 sammen. Claude eller Codex er fortsatt orkestratoren: den planlegger oppgaven og kontrollerer resultatet. Hoveddelen av arbeidet går til gratis modeller på OpenRouter. Og jeg endrer effort-nivået fra oppgave til oppgave i stedet for å la det stå på høy. Effort alene er en stor spak: etter Anthropics tall over flytter den kostnaden for én oppgave fra USD 0,29 på høy til USD 0,11 på lav.
Hva en hel agent koster per kjøring står i hva en AI-agent koster, og hva som gikk galt da jeg kjørte mange agenter parallelt står i multi-agent-orkestrering: hva som gikk i stykker.
Send meg hva du betaler for AI nå og hva den gjør, så viser jeg deg hvor det kan koste mindre. Dette arbeidet hører under AI-integrasjon.
Vokser AI-regningen din for hver måned?
Send meg hva du betaler og hva den gjør. Jeg viser deg hvilke av disse spakene som passer, og setter dem opp.
Skriv til megBegrensninger i denne listen
- Leverandørbenchmarks. Prosentene for effort, caching og orkestrering er Anthropics egne interne tester på koding og agentarbeid. Dine oppgaver kan oppføre seg annerledes; mål selv.
- Ingen OpenAI-prosenter. OpenAI publiserer ingen forskjell i tokens eller kostnad mellom effort-nivåer, så ingen er oppgitt.
- Priser endres. Lest 9. november 2026. OpenRouters gratisliste endres hver uke, og to kampanjer på leverandørsider utløper 30. november og 31. desember 2026.
- Gratis modeller er ikke testet her for kvalitet eller oppetid; sjekk dem på din egen oppgave før du stoler på én.