TL;DR
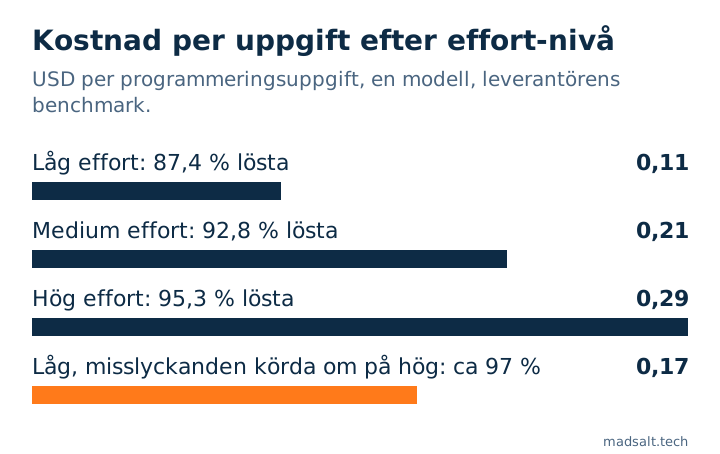
Det snabbaste sättet att minska AI-kostnader är att sluta betala toppmodellens pris för varje enskilt steg. Sänk effort-nivån först: i Anthropics eget test löste en modell 87,4 % av programmeringsuppgifterna med låg effort för USD 0,11 vardera, mot 95,3 % med hög effort för USD 0,29. Att köra lågt först och bara köra om misslyckandena med hög effort gav ungefär 97 % för ungefär USD 0,17. Sedan: cacha prompter som upprepas, kör sådant som kan vänta i batch (50 % rabatt), ge enkla steg till gratis eller billiga modeller och låt den starka modellen vara den som avgör.
Jag heter Denys och är full-stack- och AI-ingenjör. Jag bygger AI-agenter och automatiseringar åt små företag. Det här är listan jag själv använder. Den är för ägaren som ser en växande AI-rad på fakturan och vill veta vilka spakar som faktiskt påverkar den. Siffrorna är leverantörssiffror från november 2026, länkade där de förekommer; benchmarksiffrorna från Anthropic är företagets egna interna tester. Alla priser anges i USD, så som leverantörerna publicerar dem.
Var kommer en AI-räkning ifrån?
Från tokens, de textbitar som en modell läser och skriver. Att skriva kostar mer än att läsa: på Anthropics prislista tar en stark modell USD 4 per miljon lästa tokens och USD 20 per miljon skrivna, och den minsta modellen USD 0,10 och 0,50 (Anthropic pricing). Räkningen växer alltså med tre saker: vilken modell du anropar, hur mycket den tänker och skriver, och hur ofta du skickar samma långa text igen. Varje sätt nedan skär ner på en av dem.
Nio sätt att minska AI-kostnader
| Sätt | Vad det skär ner | Typisk besparing (leverantörssiffror) |
|---|---|---|
| 1. Sänk effort-nivån | tänkande och skrivande | medium 30–52 % mindre än hög |
| 2. Låg först, kör om misslyckanden på hög | tänkande på enkla uppgifter | ungefär 40 % mindre än allt på hög |
| 3. Gratismodeller för enkla steg | pris per token | USD 0 inom dagliga tak |
| 4. Stark modell avgör, billiga arbetar | pris per token | ungefär en tredjedel, bara på stora jobb |
| 5. Prompt-cachning | att läsa samma text igen | cacheläsning till 5–10 % av inputpriset |
| 6. Batcha det som kan vänta | allt | 50 % rabatt |
| 7. Skicka mindre | läsning | 21–26 % på en liten agent |
| 8. Be om kortare svar | skrivande | ungefär 13 % |
| 9. Licenser eller API | oanvända licenser | beror på användning |
1. Sänk effort-nivån
De flesta nuvarande modeller har en effort- eller resonemangsinställning, och den är den största enskilda spaken efter själva modellvalet. Anthropics nivåer är low, medium, high, xhigh och max, och effort ändrar alla tokens i svaret, inklusive verktygsanrop och tänkande (Anthropic effort docs).
Anthropics publicerade test på Claude Opus 5.5 (ett urval ur SWE-bench Pro, deras egen benchmark) (cost and intelligence guide):
| Effort | Lösta uppgifter | Kostnad per uppgift |
|---|---|---|
| low | 87,4 % | USD 0,11 |
| medium (standard) | 92,8 % | USD 0,21 |
| high | 95,3 % | USD 0,29 |
Samma guide säger att medium kostade ungefär 30 % till 52 % mindre än high på långa programmeringsuppgifter, och low ungefär två tredjedelar mindre. OpenAIs modeller har samma reglage (reasoning.effort, low till max), och OpenAI påpekar att resonemangstokens faktureras som output, men publicerar ingen procentsats, så jag anger ingen (OpenAI reasoning guide).
Sätts den för lågt slutar modellen innan den har tillräckligt underlag. Börja på medium, mät och gå lägre där resultaten håller.
2. Kör lågt först, kör bara om misslyckandena på hög effort
I samma Anthropic-test gav det ungefär 97 % för ungefär USD 0,17 per uppgift att köra allt på low och köra om de 13 % som misslyckades på high, mot 95,3 % för USD 0,29 med allt på high. Anthropic kallar det ungefär 40 % mindre med samma andel godkända (guide).
Det här fungerar när du automatiskt kan se att en uppgift misslyckades: ett test, en formulärkontroll, ett saknat fält. Utan en sådan kontroll vet du inte vad som ska köras om.
3. Använd gratismodeller för enkla steg
OpenRouter, ett API framför många modellleverantörer, listar gratisversioner av vissa modeller, markerade :free. Gränserna (OpenRouter limits):
- 20 förfrågningar per minut;
- 50 förfrågningar per dag om du har köpt krediter för mindre än USD 10 totalt;
- 1 000 förfrågningar per dag när du har köpt för USD 10 eller mer;
- misslyckade försök räknas mot dagstaket.
OpenRouters gratissamling i november 2026 innehöll NVIDIA Nemotron 3 Ultra och Nemotron 3.5 Super VL, Cohere North Mini Code och Google Gemma 4 (free models). Listan ändras varje vecka och vissa gratisposter går ut.
Läs datapolicyn innan du skickar något privat. OpenRouter själv sparar inte prompter om du inte väljer det, men varje leverantör har sin egen policy, och vissa är märkta «may train» på dina data (provider logging). Gratismodeller är till för publik eller anonymiserad text: sammanfattningar av webbsidor, sortering, första utkast, inte kunduppgifter.
4. Låt en stark modell avgöra och billiga modeller göra jobbet
Behåll den dyra modellen som den som planerar och kontrollerar, och ge det stora arbetet till billigare modeller. Båda de stora kodagenterna stöder detta: Claudes subagenter har en egen model-inställning, och Codex har default_subagent_model och default_subagent_reasoning_effort (Anthropic subagents, Codex subagents).
Hur den fördelningen ser ut på en skärm, med kostnaden för varje agent som en stapel, visar min prototyp dashboard för multiagent-orkestrering (exempeldata).
Var ärlig om var det lönar sig. Anthropic mätte en stark orkestrator med medelstora subagenter till ungefär en tredjedel lägre kostnad för ungefär samma resultat, men på arbete som var större än ett kontextfönster. När arbetet var en enda beroende kedja eller fick plats i en kontext blev en modell på lägre effort billigare i varje fall Anthropic mätte (guide). Rådet: trimma effort på en modell först, eftersom de flesta arbetsbelastningar slutar där.
5. Cacha texten du skickar varje gång
Om varje förfrågan börjar med samma instruktioner, dokument eller verktygslista, cacha dem. Hos Anthropic kostar en cacheläsning 10 % av normalt inputpris, och 5 % på de nyaste Opus- och Sonnet-modellerna; cacheskrivningen kostar lite mer, en gång (Anthropic pricing). OpenAI prissätter cachad input till 5 % på GPT-6.1 Sol (model page). Anthropic mätte att cachning sänkte en researchagents kostnad med 4,8 till 7,2 gånger och kallar det vanligtvis den största spaken.
En fälla från samma guide: en statusrad på 25 tokens allra först i prompten ändrades i varje förfrågan, så varje förfrågan skrev om hela cachen. Lägg allt som ändras sist.
6. Batcha det som kan vänta
Rapporter, klassificering över natten, massextrahering: allt som kan vänta upp till 24 timmar kan gå via batch-API:et med 50 % rabatt hos både Anthropic och OpenAI, och hos Anthropic går rabatten att kombinera med cachning (Anthropic pricing, OpenAI pricing).
7. Skicka mindre
Varje dokument, verktygsdefinition och gammalt meddelande du bifogar läses om vid varje anrop. Anthropic mätte att beskärning av input tog ytterligare 21 % till 26 % av en liten triageagents räkning, och att ladda verktygsdefinitioner först vid behov sparade 45 % med 500 verktyg kopplade (guide). Långa prompter kan också passera ett prissteg: Haiku 5.5 tar 5 gånger så mycket för prompter över 100 000 tokens.
8. Be om kortare svar
Att skriva kostar ungefär fem gånger så mycket som att läsa på de flesta prislistor. Anthropic mätte «be om kortare svar» till ungefär 13 % lägre kostnad av 39 % färre output-tokens (guide). «Svara på tre meningar» eller «returnera bara JSON» är en gratis ändring.
9. Jämför licenser med API-användning
Teamplaner är per person: standardlicenser i ChatGPT Business och Claude Team kostar USD 25 i månaden, eller USD 20 på årsplan (ChatGPT Business, Claude Team). Tio licenser med årsfakturering blir USD 2 400 om året. Om hälften av teamet öppnar den två gånger i månaden kan ett internt verktyg på API:et med en utgiftsgräns kosta mindre. Om alla använder den dagligen är licenser oftast det bättre köpet.
Mitt liknande fall
Mitt eget arbete går på sätt 1, 3 och 4 tillsammans. Claude eller Codex är fortfarande orkestratorn: den planerar uppgiften och kontrollerar resultatet. Merparten av arbetet går till gratismodeller på OpenRouter. Och jag ändrar effort-nivån från uppgift till uppgift i stället för att låta den stå på hög. Enbart effort är en stor spak: enligt Anthropics siffror ovan flyttar den kostnaden för en uppgift från USD 0,29 på hög till USD 0,11 på låg.
Vad en hel agent kostar per körning står i vad en AI-agent kostar, och vad som gick fel när jag körde många agenter parallellt står i multi-agent-orkestrering: vad som gick sönder.
Skicka mig vad du betalar för AI nu och vad den gör, så visar jag var det kan kosta mindre. Det här arbetet hör till AI-integration.
Växer din AI-räkning för varje månad?
Skicka mig vad du betalar och vad den gör. Jag visar vilka av de här spakarna som passar och ställer in dem.
Skriv till migBegränsningar i den här listan
- Leverantörsbenchmarks. Procentsatserna för effort, cachning och orkestrering är Anthropics egna interna tester på kodning och agentarbete. Dina uppgifter kan bete sig annorlunda; mät själv.
- Inga OpenAI-procentsatser. OpenAI publicerar ingen skillnad i tokens eller kostnad mellan effort-nivåer, så ingen anges.
- Priser ändras. Lästa den 9 november 2026. OpenRouters gratislista ändras varje vecka, och två kampanjer på leverantörssidor går ut den 30 november och den 31 december 2026.
- Gratismodeller har inte testats här för kvalitet eller drifttid; kontrollera dem på din egen uppgift innan du litar på en.