TL;DR
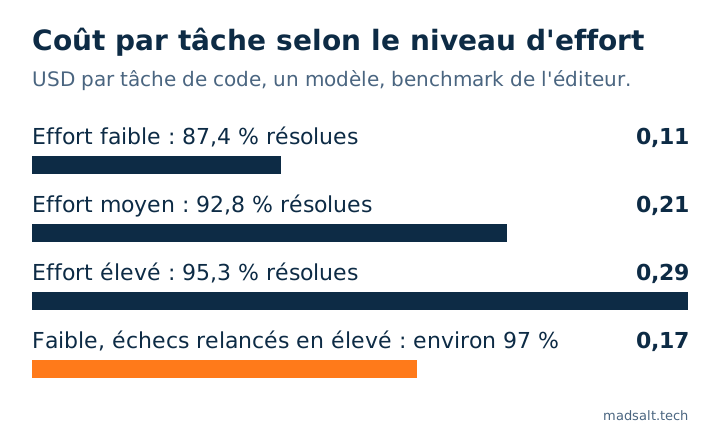
Pour réduire les coûts de l’IA, il faut cesser de payer le prix du meilleur modèle à chaque étape. Baissez d’abord le niveau d’effort : dans le test d’Anthropic, un modèle a résolu 87,4 % des tâches de code à effort faible pour USD 0,11 chacune, contre 95,3 % à effort élevé pour USD 0,29. Lancer tout en faible puis ne relancer en élevé que les échecs a donné environ 97 % pour environ USD 0,17. Ensuite : mettre en cache les prompts répétés, passer en batch ce qui peut attendre (50 % de remise), confier les étapes simples à des modèles gratuits ou bon marché, et garder le modèle fort pour décider.
Je suis Denys, ingénieur full-stack et IA. Je construis des agents IA et des automatisations pour de petites entreprises. Cette liste est celle que j’utilise. Elle s’adresse au dirigeant qui voit grossir une ligne IA sur sa facture et veut savoir quels leviers la font bouger. Les chiffres sont ceux des éditeurs en novembre 2026, avec le lien là où ils apparaissent ; les chiffres de benchmark d’Anthropic viennent de ses propres tests internes. Tous les prix sont en USD, tels que les éditeurs les publient.
Réduire les coûts de l’IA : d’où vient la facture ?
Des tokens, les morceaux de texte qu’un modèle lit et écrit. Écrire coûte plus cher que lire : sur la grille d’Anthropic, un modèle fort facture USD 4 par million de tokens lus et USD 20 par million écrits, son plus petit modèle USD 0,10 et 0,50 (tarifs Anthropic). Pour savoir combien coûte une IA, il faut donc regarder trois choses : quel modèle vous appelez, combien il réfléchit et écrit, et combien de fois vous lui renvoyez le même long texte. Chaque levier ci-dessous réduit l’un de ces trois postes.
| Levier | Ce qu’il réduit | Économie typique (chiffres des éditeurs) |
|---|---|---|
| 1. Baisser le niveau d’effort | réflexion et écriture | medium 30–52 % moins cher que high |
| 2. D’abord low, relancer les échecs en high | réflexion sur les tâches faciles | environ 40 % de moins que tout en high |
| 3. Modèles gratuits pour les étapes simples | prix par token | USD 0 dans les plafonds quotidiens |
| 4. Le modèle fort décide, les petits travaillent | prix par token | environ un tiers, sur les gros travaux seulement |
| 5. Cache de prompt | relecture du même texte | lecture en cache à 5–10 % du prix d’entrée |
| 6. Batch pour ce qui peut attendre | tout | 50 % de remise |
| 7. Envoyer moins | lecture | 21–26 % sur un petit agent |
| 8. Demander des réponses plus courtes | écriture | environ 13 % |
| 9. Licences ou API | licences inutilisées | selon l’usage |
1. Baisser le niveau d’effort
La plupart des modèles actuels ont un réglage d’effort ou de raisonnement, et c’est le plus gros levier après le choix du modèle. Chez Anthropic, les niveaux sont low, medium, high, xhigh et max, et l’effort modifie tous les tokens de la réponse, y compris les appels d’outils et la réflexion (doc Anthropic sur l’effort).
Le test publié par Anthropic sur Claude Opus 5.5 (un sous-ensemble de SWE-bench Pro, son propre benchmark) (guide coût et intelligence) :
| Effort | Tâches résolues | Coût par tâche |
|---|---|---|
| low | 87,4 % | USD 0,11 |
| medium (par défaut) | 92,8 % | USD 0,21 |
| high | 95,3 % | USD 0,29 |
Le même guide indique que medium coûte environ 30 % à 52 % de moins que high sur les longues tâches de code, et low environ deux tiers de moins. Les modèles d’OpenAI ont le même interrupteur (reasoning.effort, de low à max), et OpenAI précise que les tokens de raisonnement sont facturés comme de la sortie, mais ne publie aucun pourcentage, donc je n’en cite pas (guide OpenAI sur le raisonnement).
Réglé trop bas, le modèle s’arrête avant d’avoir assez d’éléments. Partez de medium, mesurez, puis descendez là où les résultats tiennent.
2. Lancer en low d’abord, relancer seulement les échecs en high
Dans le même test d’Anthropic, tout lancer en low et relancer en high les 13 % de tâches échouées a résolu environ 97 % pour environ USD 0,17 par tâche, contre 95,3 % pour USD 0,29 avec tout en high. Anthropic parle d’environ 40 % de moins pour un même taux de réussite (guide).
Cela fonctionne quand on peut voir automatiquement qu’une tâche a échoué : un test, un contrôle de formulaire, un champ manquant. Sans ce contrôle, on ne sait pas quoi relancer.
3. Utiliser des modèles gratuits pour les étapes simples
OpenRouter, une seule API devant de nombreux fournisseurs de modèles, propose des versions gratuites de certains modèles, repérées par :free. Ses limites (limites OpenRouter) :
- 20 requêtes par minute ;
- 50 requêtes par jour si vous avez acheté moins de USD 10 de crédits au total ;
- 1 000 requêtes par jour dès que vous avez acheté USD 10 ou plus ;
- les tentatives échouées comptent dans le plafond quotidien.
La collection gratuite d’OpenRouter comprenait en novembre 2026 NVIDIA Nemotron 3 Ultra et Nemotron 3.5 Super VL, Cohere North Mini Code et Google Gemma 4 (modèles gratuits). La liste change chaque semaine, et certaines offres gratuites expirent.
Lisez la politique de données avant d’envoyer quoi que ce soit de confidentiel. OpenRouter ne conserve pas les prompts sauf si vous l’activez, mais chaque fournisseur a sa propre politique, et certains sont marqués « may train » : ils peuvent utiliser vos données pour l’entraînement (journalisation par fournisseur). Les modèles gratuits conviennent aux textes publics ou anonymisés : résumés de pages web, tri, premiers jets, pas de dossiers clients ni de données personnelles relevant du RGPD.
4. Un modèle fort décide, des modèles bon marché travaillent
Gardez le modèle cher pour planifier et vérifier, et confiez les étapes en volume à des modèles moins chers. Les deux grands agents de code le permettent : les sous-agents de Claude ont leur propre réglage model, et Codex a default_subagent_model et default_subagent_reasoning_effort (sous-agents Anthropic, sous-agents Codex).
À quoi ressemble ce partage sur un seul écran, avec le coût de chaque agent en barre, se voit dans mon prototype de dashboard d’orchestration multi-agents (données d’exemple).
Soyez honnête sur les cas où cela paie. Anthropic a mesuré un orchestrateur fort avec des sous-agents de taille moyenne à environ un tiers de coût en moins pour un score à peu près identique, mais sur un travail plus grand qu’une fenêtre de contexte. Quand le travail était une seule chaîne dépendante ou tenait dans un seul contexte, un modèle unique à effort plus bas revenait moins cher dans tous les cas mesurés (guide). Son conseil : réglez d’abord l’effort sur un seul modèle, car la plupart des charges de travail s’arrêtent là.
5. Mettre en cache le texte envoyé à chaque fois
Si chaque requête commence par les mêmes instructions, documents ou la même liste d’outils, mettez-les en cache. Chez Anthropic, une lecture en cache coûte 10 % du prix d’entrée normal, et 5 % sur ses modèles Opus et Sonnet les plus récents ; l’écriture en cache coûte un peu plus, une fois (tarifs Anthropic). OpenAI facture l’entrée en cache à 5 % sur GPT-6.1 Sol (page du modèle). Anthropic a mesuré que le cache divisait le coût d’un agent de recherche par 4,8 à 7,2 et le qualifie de levier généralement le plus important.
Un piège relevé dans le même guide : une ligne d’état de 25 tokens placée tout au début du prompt changeait à chaque requête, donc chaque requête réécrivait tout le cache. Mettez ce qui change à la fin.
6. Passer en batch ce qui peut attendre
Rapports, classement de nuit, extraction en masse : tout ce qui peut attendre jusqu’à 24 heures peut passer par l’API batch à 50 % de remise chez Anthropic comme chez OpenAI, et chez Anthropic la remise se cumule avec le cache (tarifs Anthropic, tarifs OpenAI).
7. Envoyer moins
Chaque document, chaque définition d’outil et chaque ancien message joint est relu à chaque appel. Anthropic a mesuré que réduire l’entrée retirait encore 21 % à 26 % de la facture d’un petit agent de tri, et que ne charger les définitions d’outils qu’au besoin économisait 45 % avec 500 outils attachés (guide). Les longs prompts peuvent aussi franchir un palier de prix : Haiku 5.5 facture 5 fois plus cher les prompts de plus de 100 000 tokens.
8. Demander des réponses plus courtes
Écrire coûte environ cinq fois plus que lire sur la plupart des grilles. Anthropic a mesuré « demander des réponses plus courtes » à environ 13 % de moins grâce à 39 % de tokens de sortie en moins (guide). « Réponds en trois phrases » ou « renvoie uniquement le JSON » est un changement gratuit.
9. Comparer les licences à l’usage de l’API
Les offres d’équipe sont facturées par personne : les places standard de ChatGPT Business et de Claude Team coûtent USD 25 par mois, ou USD 20 en abonnement annuel (ChatGPT Business, Claude Team). Dix places en facturation annuelle font USD 2 400 par an. Si la moitié de l’équipe l’ouvre deux fois par mois, un outil interne sur l’API avec un plafond de dépense peut coûter moins. Si tout le monde l’utilise chaque jour, les licences sont en général plus avantageuses.
Mon cas similaire
Mon propre travail repose sur les leviers 1, 3 et 4 ensemble. Claude ou Codex reste l’orchestrateur : il planifie la tâche et vérifie le résultat. L’essentiel du travail va à des modèles gratuits sur OpenRouter. Et je change le niveau d’effort d’une tâche à l’autre au lieu de le laisser en high. L’effort seul est un gros levier : d’après les chiffres d’Anthropic ci-dessus, il fait passer le coût d’une tâche de USD 0,29 en high à USD 0,11 en low.
Ce que coûte un agent entier par exécution est dans combien coûte un agent IA, et ce qui a mal tourné quand j’ai lancé beaucoup d’agents en parallèle est dans orchestration multi-agents : ce qui a cassé.
Envoyez-moi ce que vous payez aujourd’hui pour l’IA et ce qu’elle fait, et je vous montrerai où cela peut coûter moins. Ce travail relève de l’intégration d’IA.
Votre facture d'IA grossit-elle chaque mois ?
Envoyez-moi ce que vous payez et ce que fait l'IA. Je vous montrerai quels leviers conviennent, et je les mettrai en place.
Me contacterLimites de cette liste
- Benchmarks d’éditeur. Les pourcentages sur l’effort, le cache et l’orchestration viennent des tests internes d’Anthropic sur du code et des agents. Vos tâches peuvent réagir autrement ; mesurez sur les vôtres.
- Pas de pourcentages OpenAI. OpenAI ne publie aucune différence de tokens ou de coût entre les niveaux d’effort, donc aucune n’est donnée.
- Les prix changent. Relevé le 9 novembre 2026. La liste gratuite d’OpenRouter change chaque semaine, et deux promotions sur les pages d’éditeurs se terminent le 30 novembre et le 31 décembre 2026.
- Les modèles gratuits n’ont pas été testés ici pour la qualité ni la disponibilité ; vérifiez-les sur votre propre tâche avant de vous y fier.